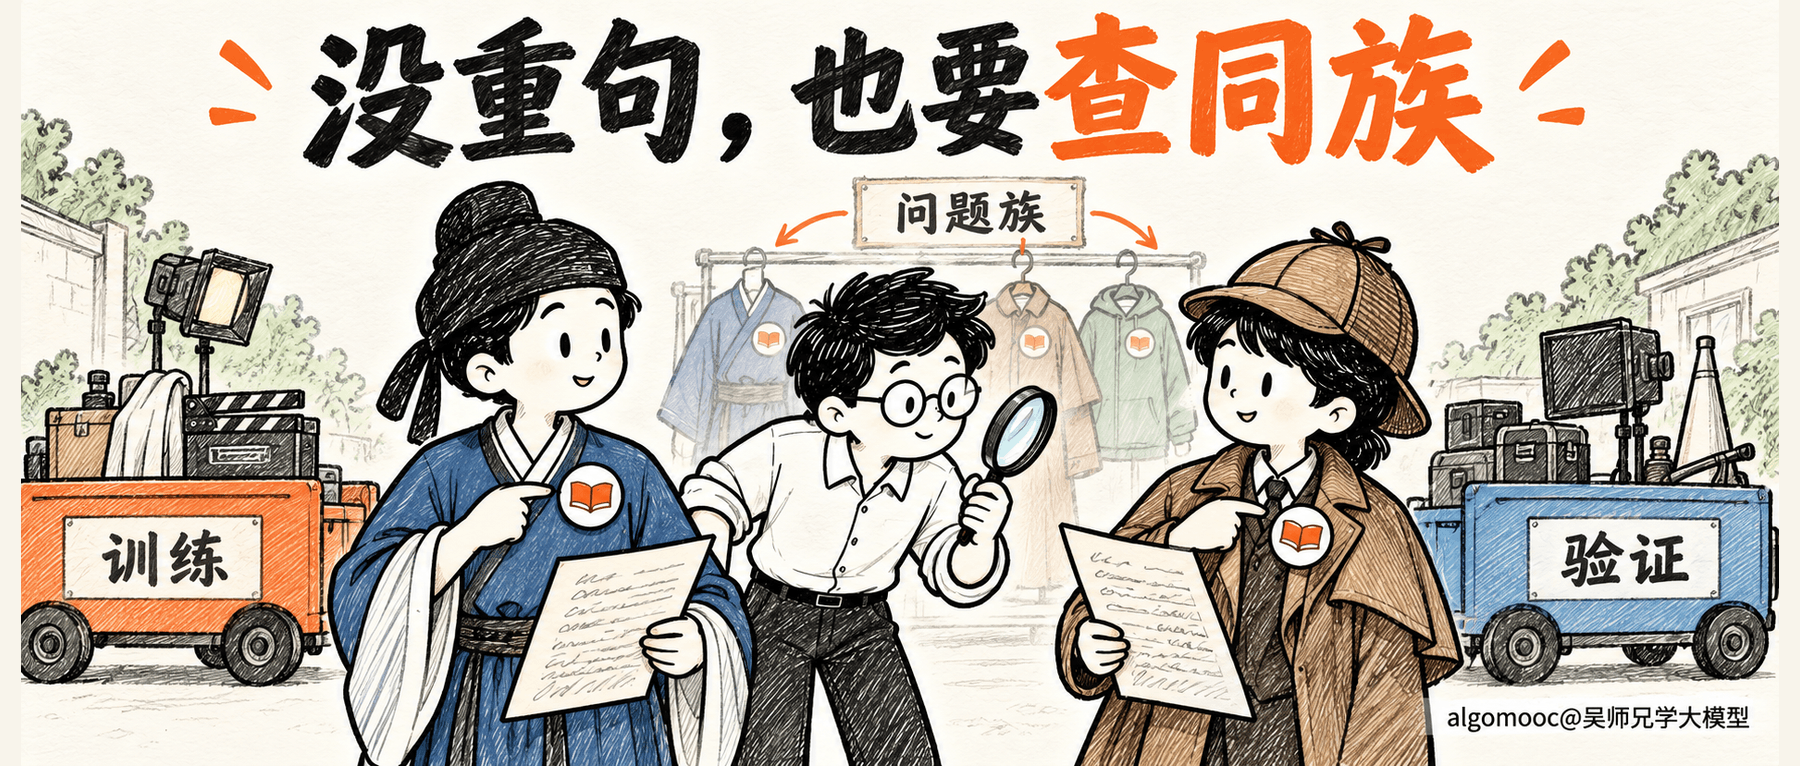
训练集与验证集做过题面去重,两边没有一句相同的话,是否就能说明验证题足够独立?先看两道问题:“订单签收三天后提出退款,应先核对哪项期限?”“顾客收货已过三日,退款入口开放吗?”
它们的文字不同,算出的哈希也不同。如果都来自同一个退款期限母题,只是换了说法,模型在训练时可能已经接触过相近的判断结构。验证时答对,究竟说明学会了新规则,还是能处理旧规则的新表达,需要先分清。
这两种能力都有价值。问题出在切分和评估各说各话:数据按单条随机或依序分配,报告却把结果解释成对全新问题的泛化。没有重复句子,只能排除最直观的一种重叠。
先说清验证集要考哪种能力
一个问题族,可以理解为同一母题衍生的一组问题。改写措辞、替换实体或调整参数,都可能仍在考同一种规则或求解路径。给它们分配共同的family_id,是为了记录这种来历,不是宣布它们的答案完全相同。
例如,退款期限问题把三天换成四天,答案可能改变,所需判断仍围绕同一条期限规则。相反,退款期限和退货运费都属于售后主题,却在检查不同条件。不能因为主题相同,就把所有售后题都放进同一个家族。
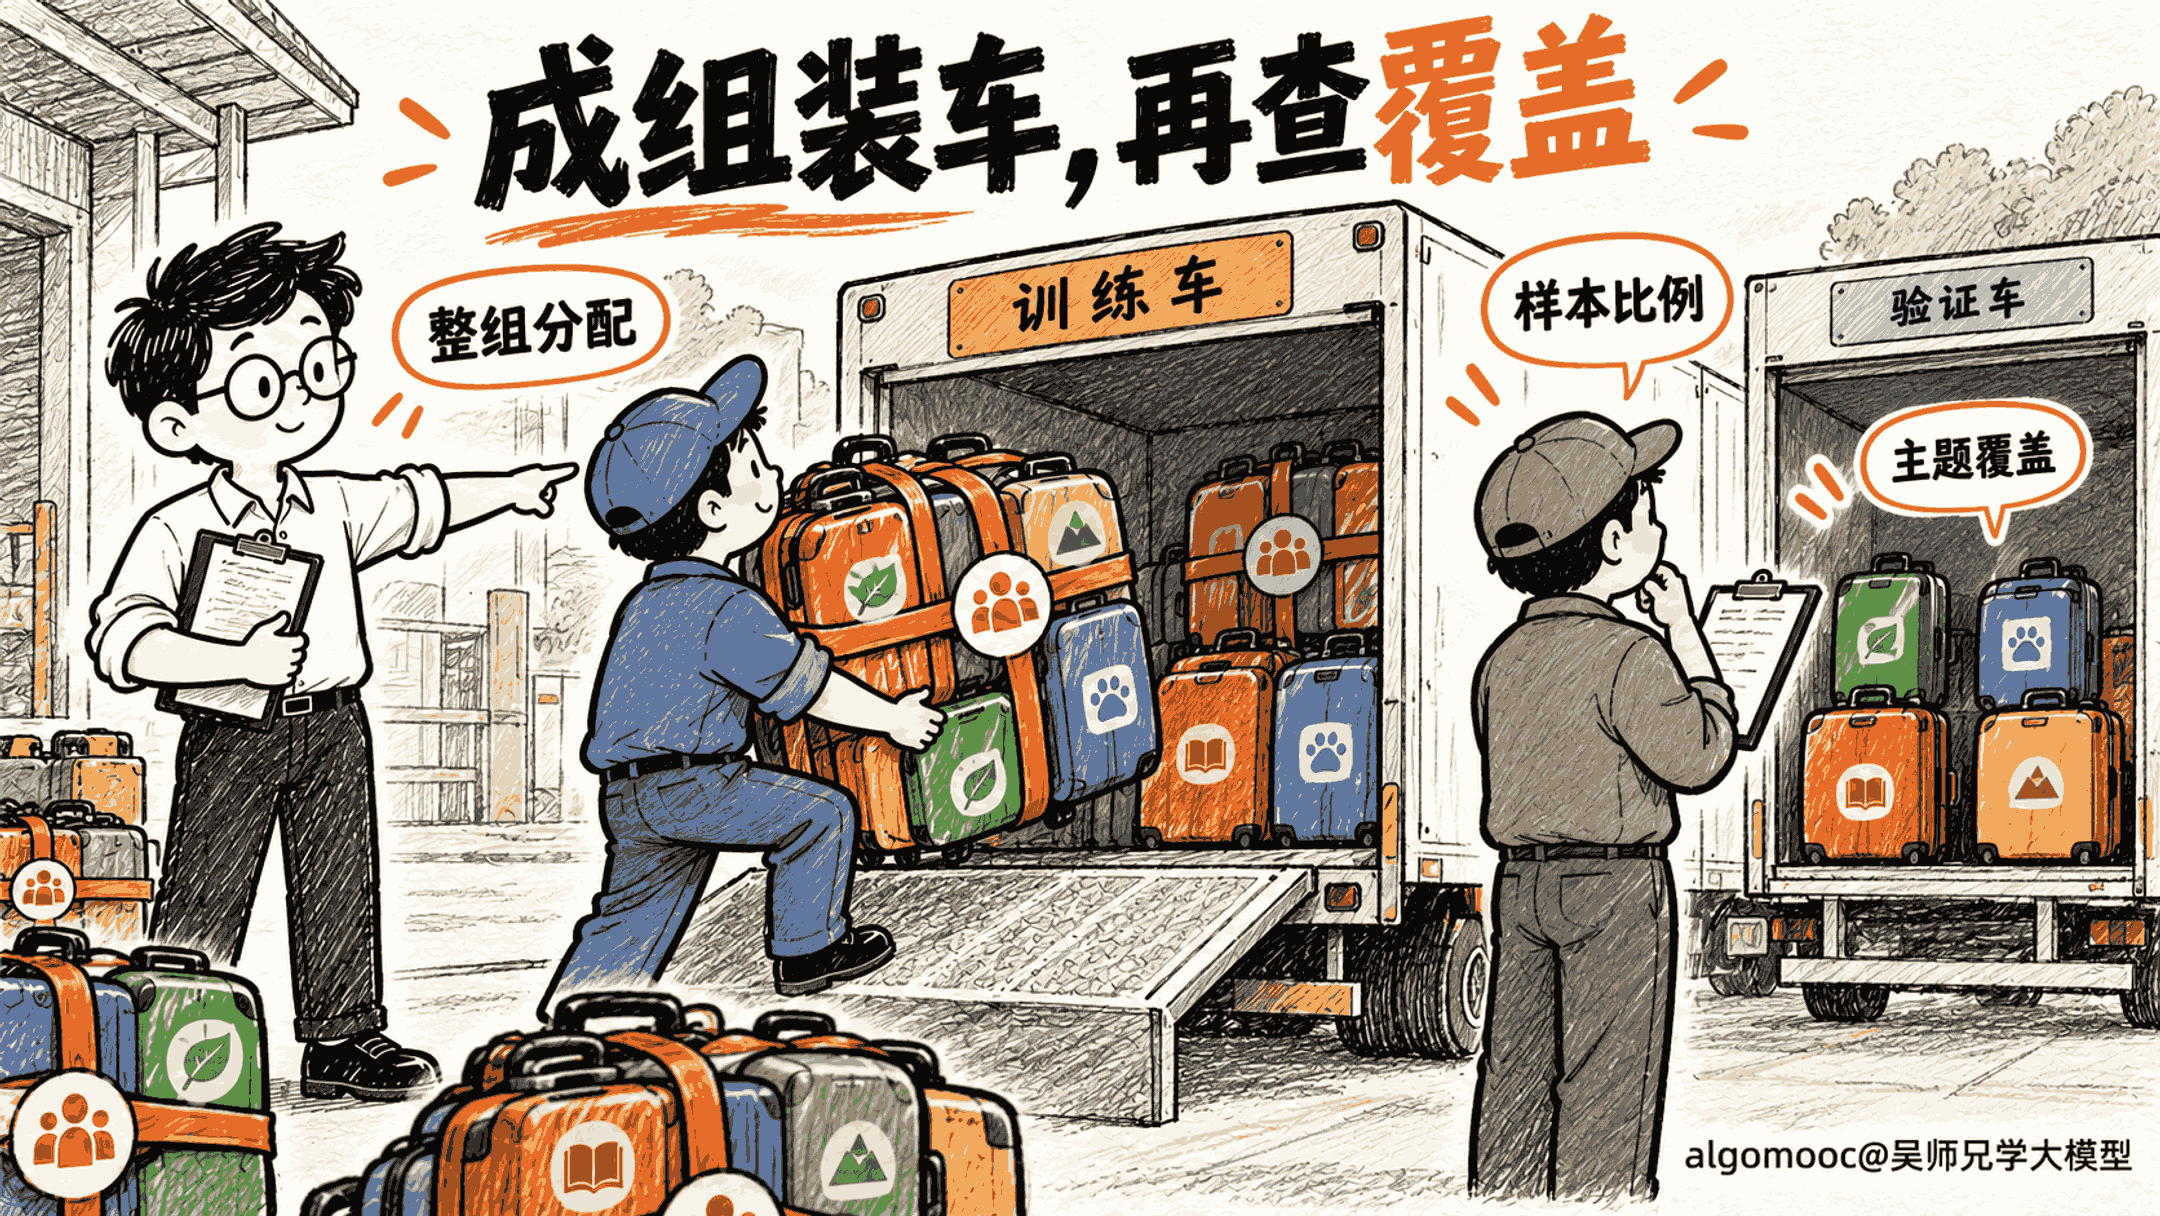
切分之前,需要先确定这次验证要回答什么。若目标是同一种规则下的新表达,可以允许同族变体出现在两边,但要说明验证的是这种能力。若目标是未见过的母题,则应让同一家族只进入一个集合。
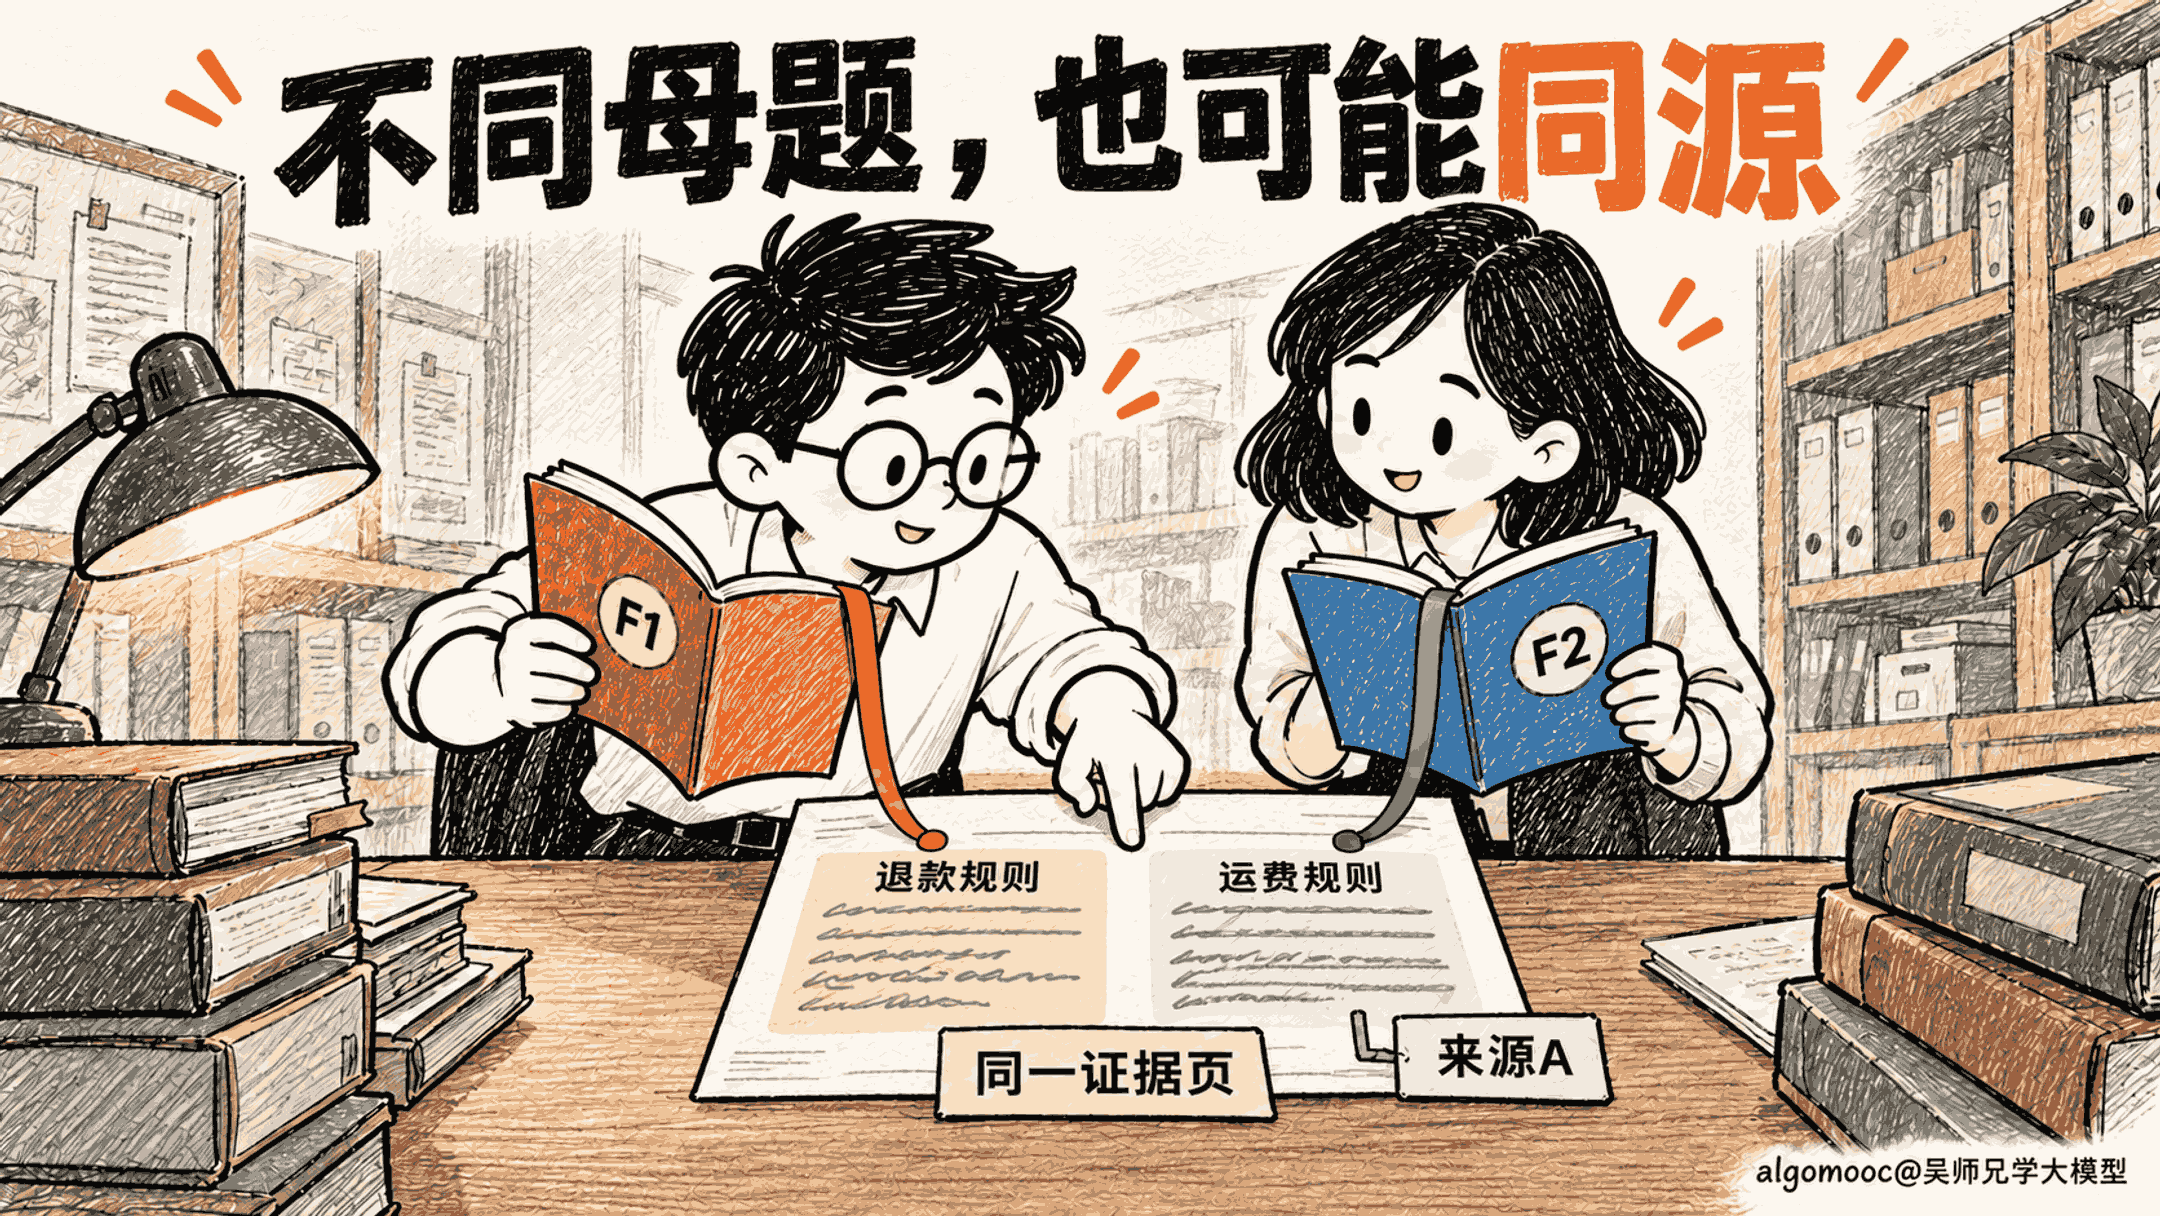
还有更进一步的目标:面对新的资料来源,模型能否完成任务。两个母题即使不同,也可能依赖同一页规则。只隔离家族,还不足以把来源一并隔开。这时需要来源组,记录问题具体依赖哪些证据页或证据路径。
这些边界没有统一最严格的答案。把所有相关题绑得很紧,会减少可以分配的独立组;拆得太细,又容易把想检验的新能力变成旧材料的再表达。先写清评估目标,才能判断哪种重叠值得保留,哪种会让结论失真。
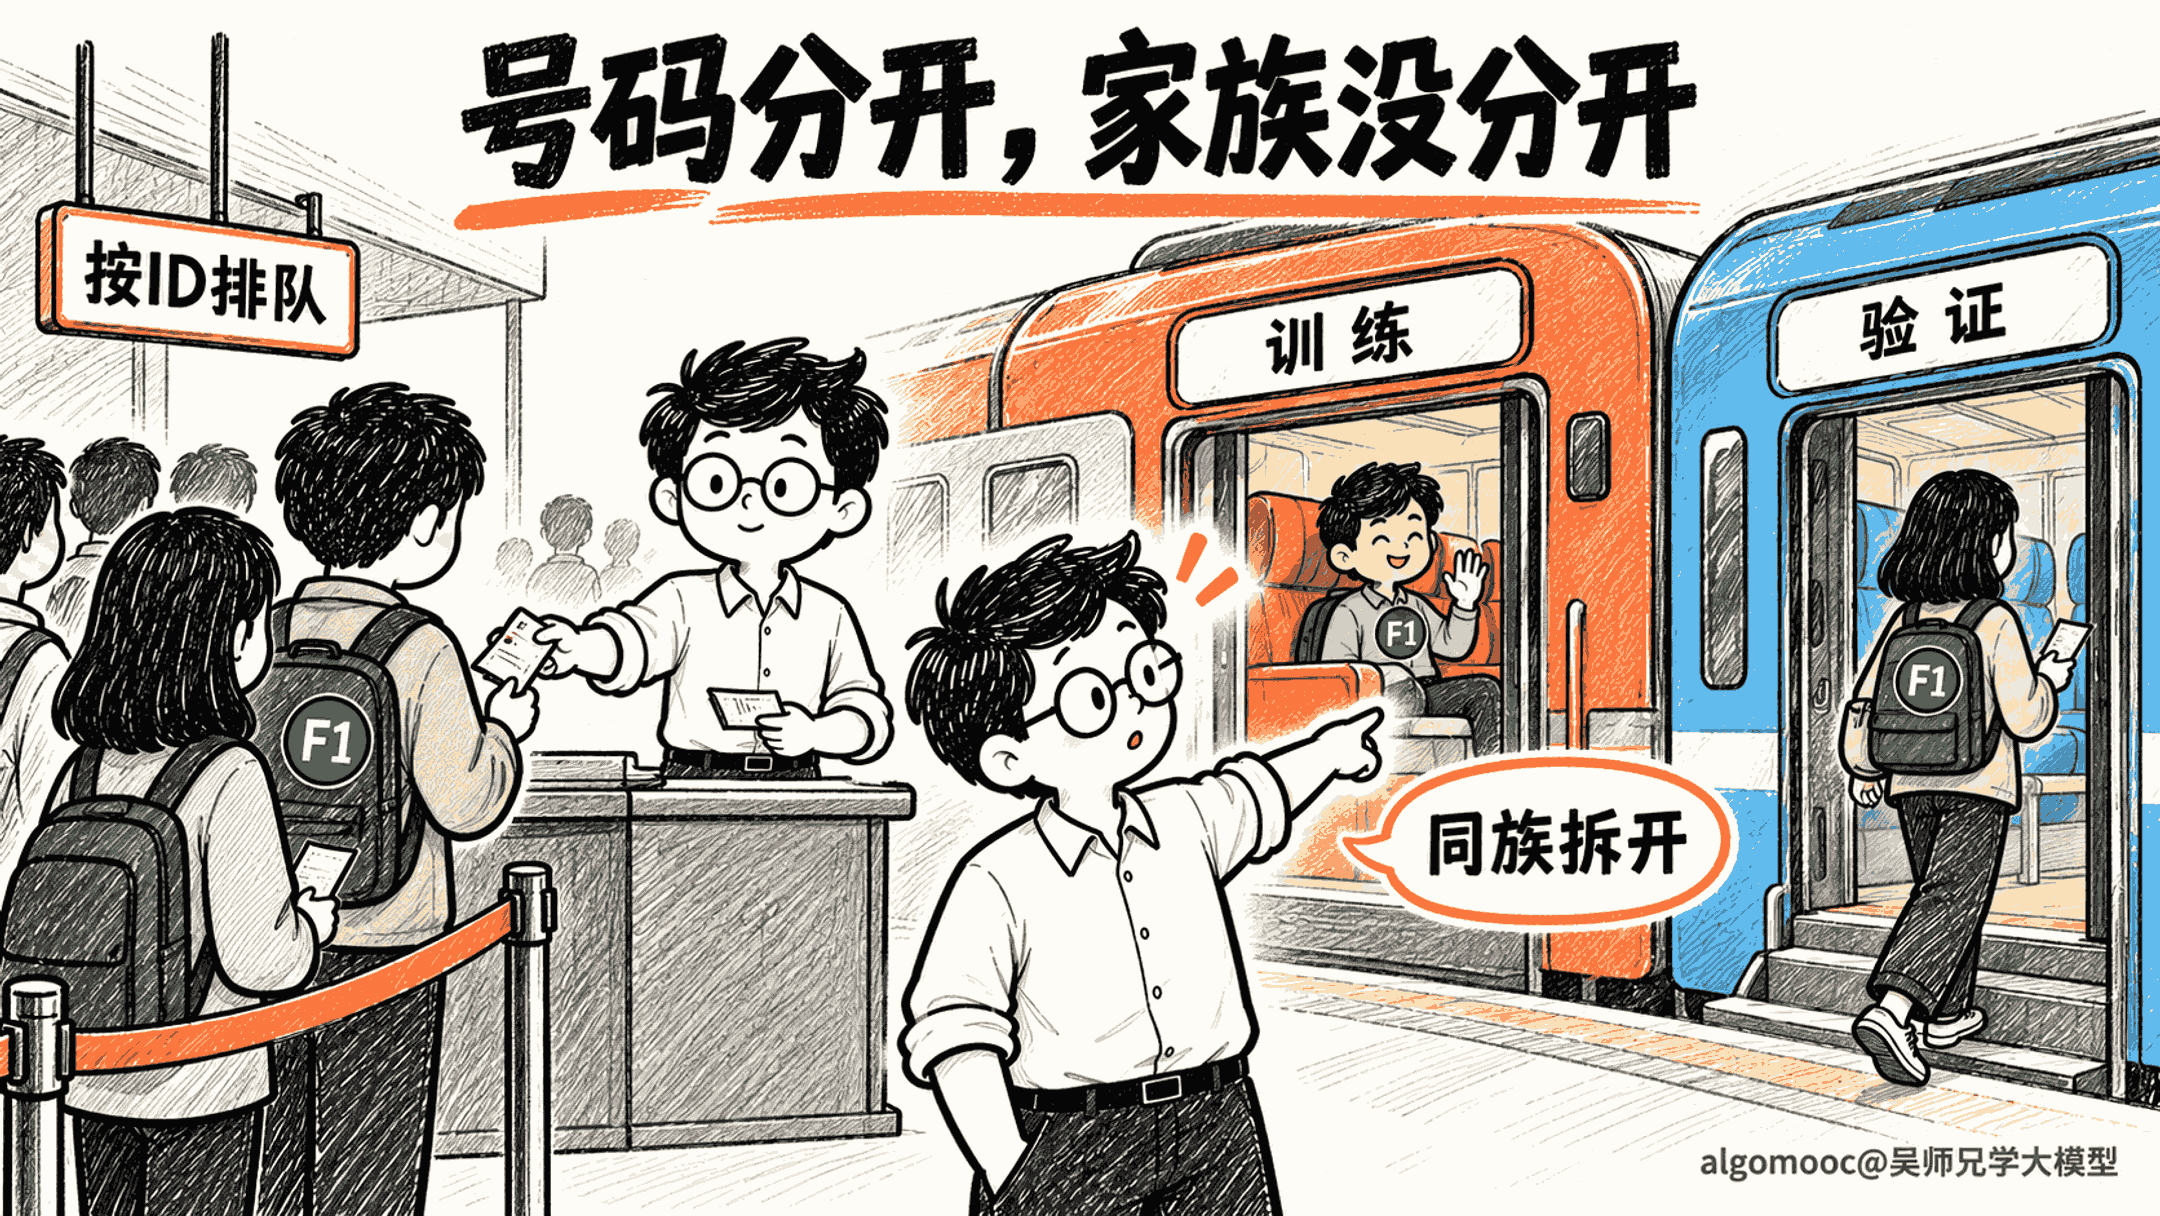
原代码按号码分配,没有读取家族
本机S5训练包的两个数据构造器提供了一个具体观察点。SFT构造器先按清单中的ID排序,再从0开始枚举,序号能被val_every整除的记录进入验证,其余进入训练。默认间隔是10,因此第0、10、20条进入验证。
GRPO构造器采用同样的排序与取模规则。两者生成的数据用途不同,但决定train或val的这一步,都没有根据问题族或来源组进行判断。后续保存主题、难度或来源文件,不会反过来改变前面已经作出的分配。
这种方式有清楚的好处:同一份清单,即使读取时顺序不同,排序以后仍会得到一致结果。数据构造容易重现,也方便按ID回查。但可复现描述的是分配规则是否稳定,家族隔离描述的是相关样本有没有被拆开,两件事需要分别验证。
只要同族记录的ID不同,它们就可能落到不同序号。号码本身没有义务表达母题关系。即使改成固定随机种子,单条抽签仍然可能把同一个家族分给两边,固定种子也不会替代分组。
确定性还依赖清单本身不变。新增一条ID排在前面的记录,后面样本的序号可能整体后移,原来的train或val归属也可能改变。重现切分时,应保存输入清单版本、分配参数与具体ID名单,不能只留一句“采用确定性切分”。