假设一次协作确认了这样的偏好:解释方案时先说明约束,再讲取舍。Agent 把它保存成一份记忆文件,文件名、正文都能在磁盘上找到。下一次会话开始时,系统却没有把这份文件的入口交给模型。
这时若直接追查模型为什么“记不住”,很容易跳过真正缺失的一步。文件保存回答的是内容是否落盘;新会话怎样发现内容,还取决于它从哪里开始读取。两件事由不同文件承担,就可能出现正文已经写好,入口仍然没有更新的状态。
当前这份 Agent 实现把记忆正文放在独立文件里,用 MEMORY.md 保存简短索引。沿着这两个位置看下去,可以把持久化、发现和读取三层分开,也能解释为什么补一条链接还没有完成全部工作。
文件已落盘,默认入口为什么还是空的?
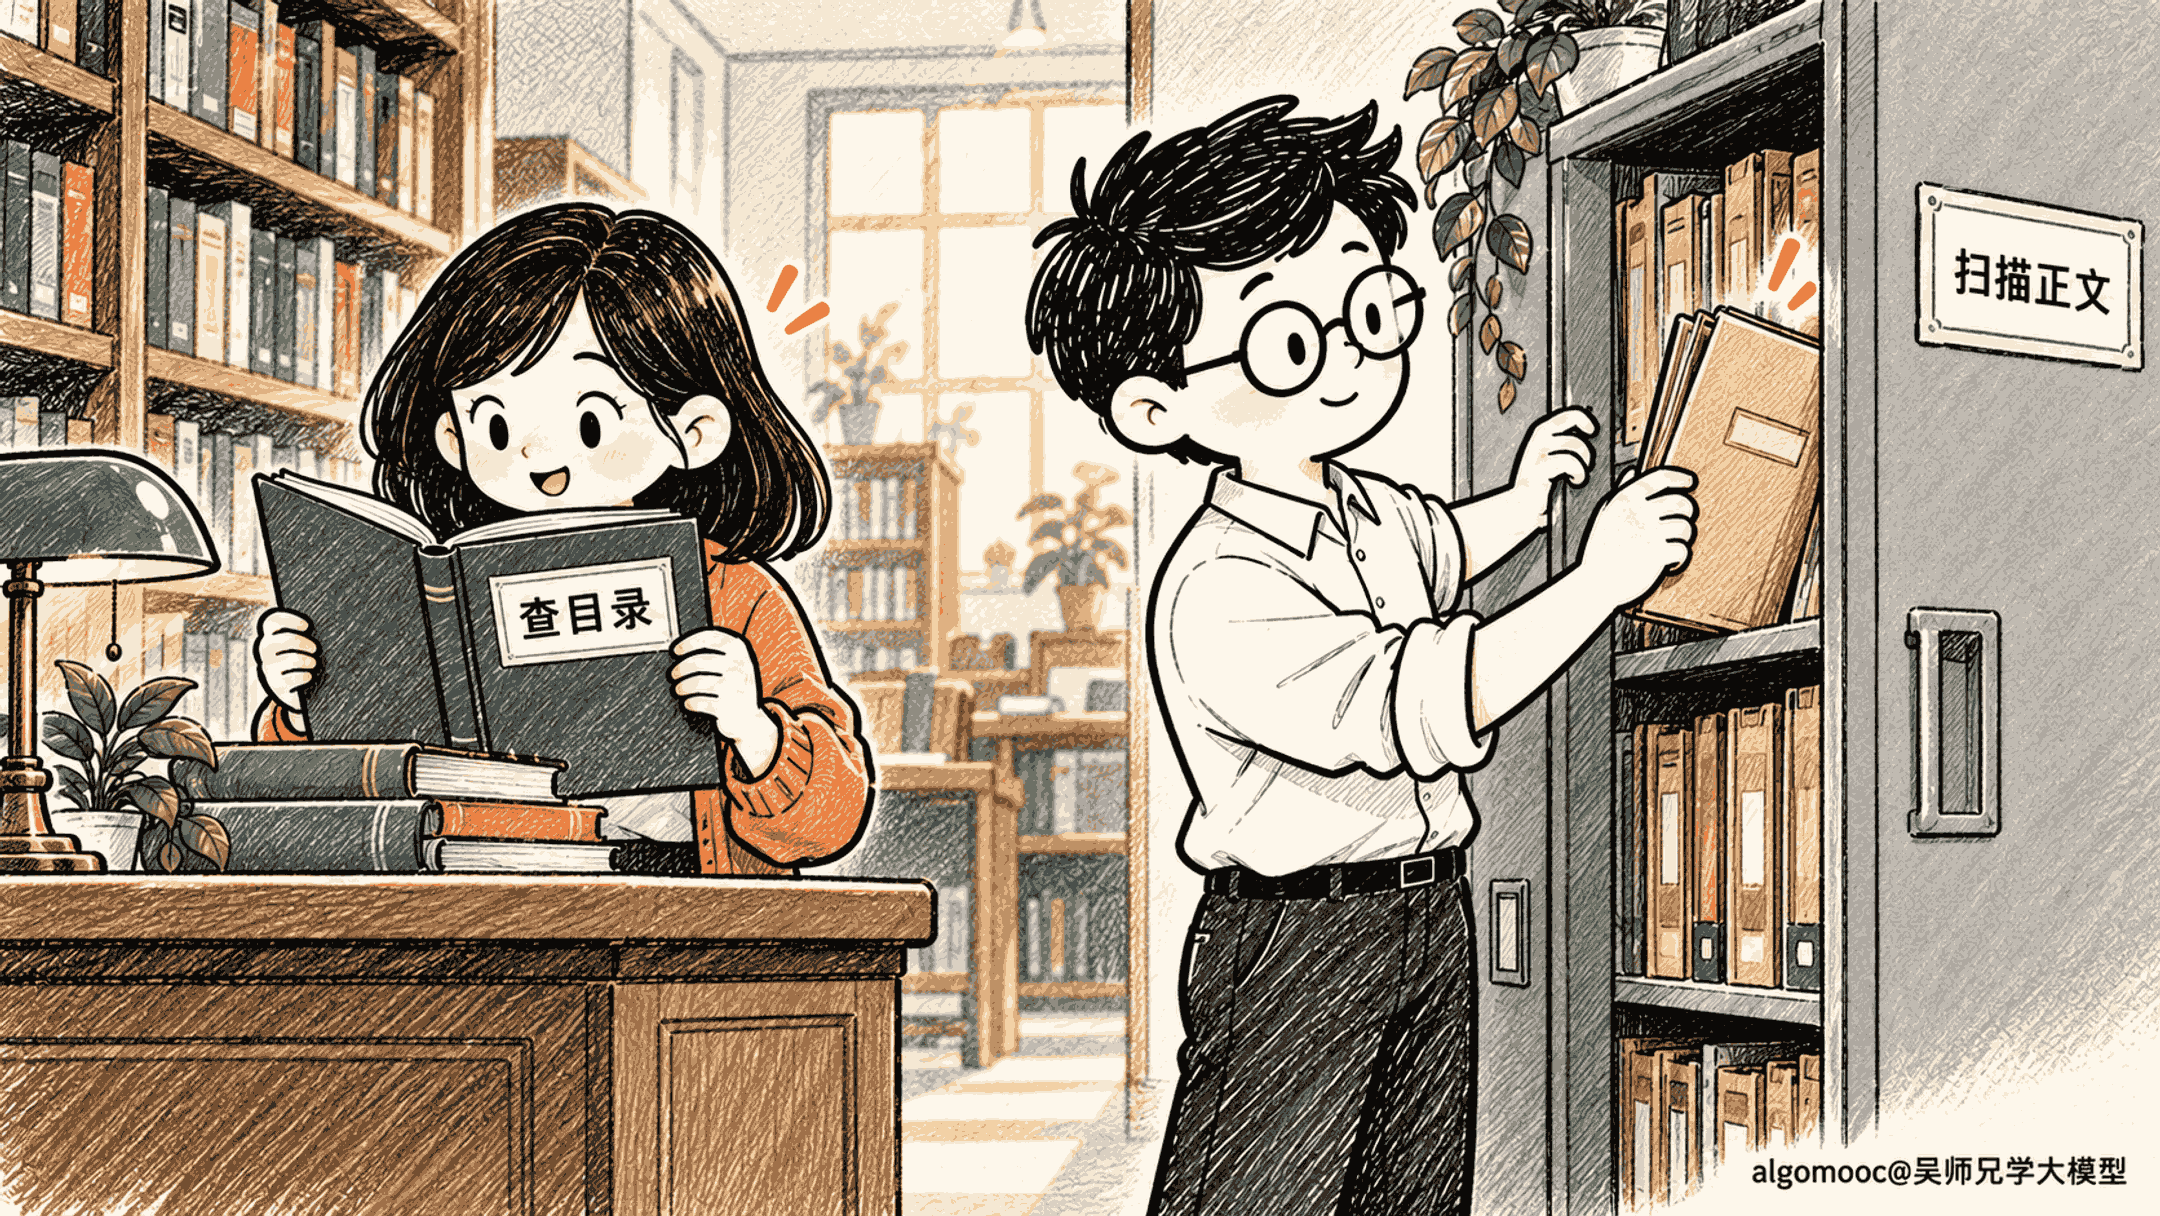
先看新会话实际拿到什么。主程序构建系统提示词时,会取得记忆目录的位置,再调用 load_memory_index 读取索引内容,交给提示词构建器。构建器加入记忆的使用说明和当前索引;它没有顺着所有链接,把每份正文自动展开进去。
这条入口使索引承担了很具体的职责:告诉模型有哪些可用材料,大致记录什么,应该去哪里读。目录位置和使用规则提供背景,索引里的书名与链接才指向某一份具体记忆。即使目录本身存在,也不能据此判断条目已经可见。
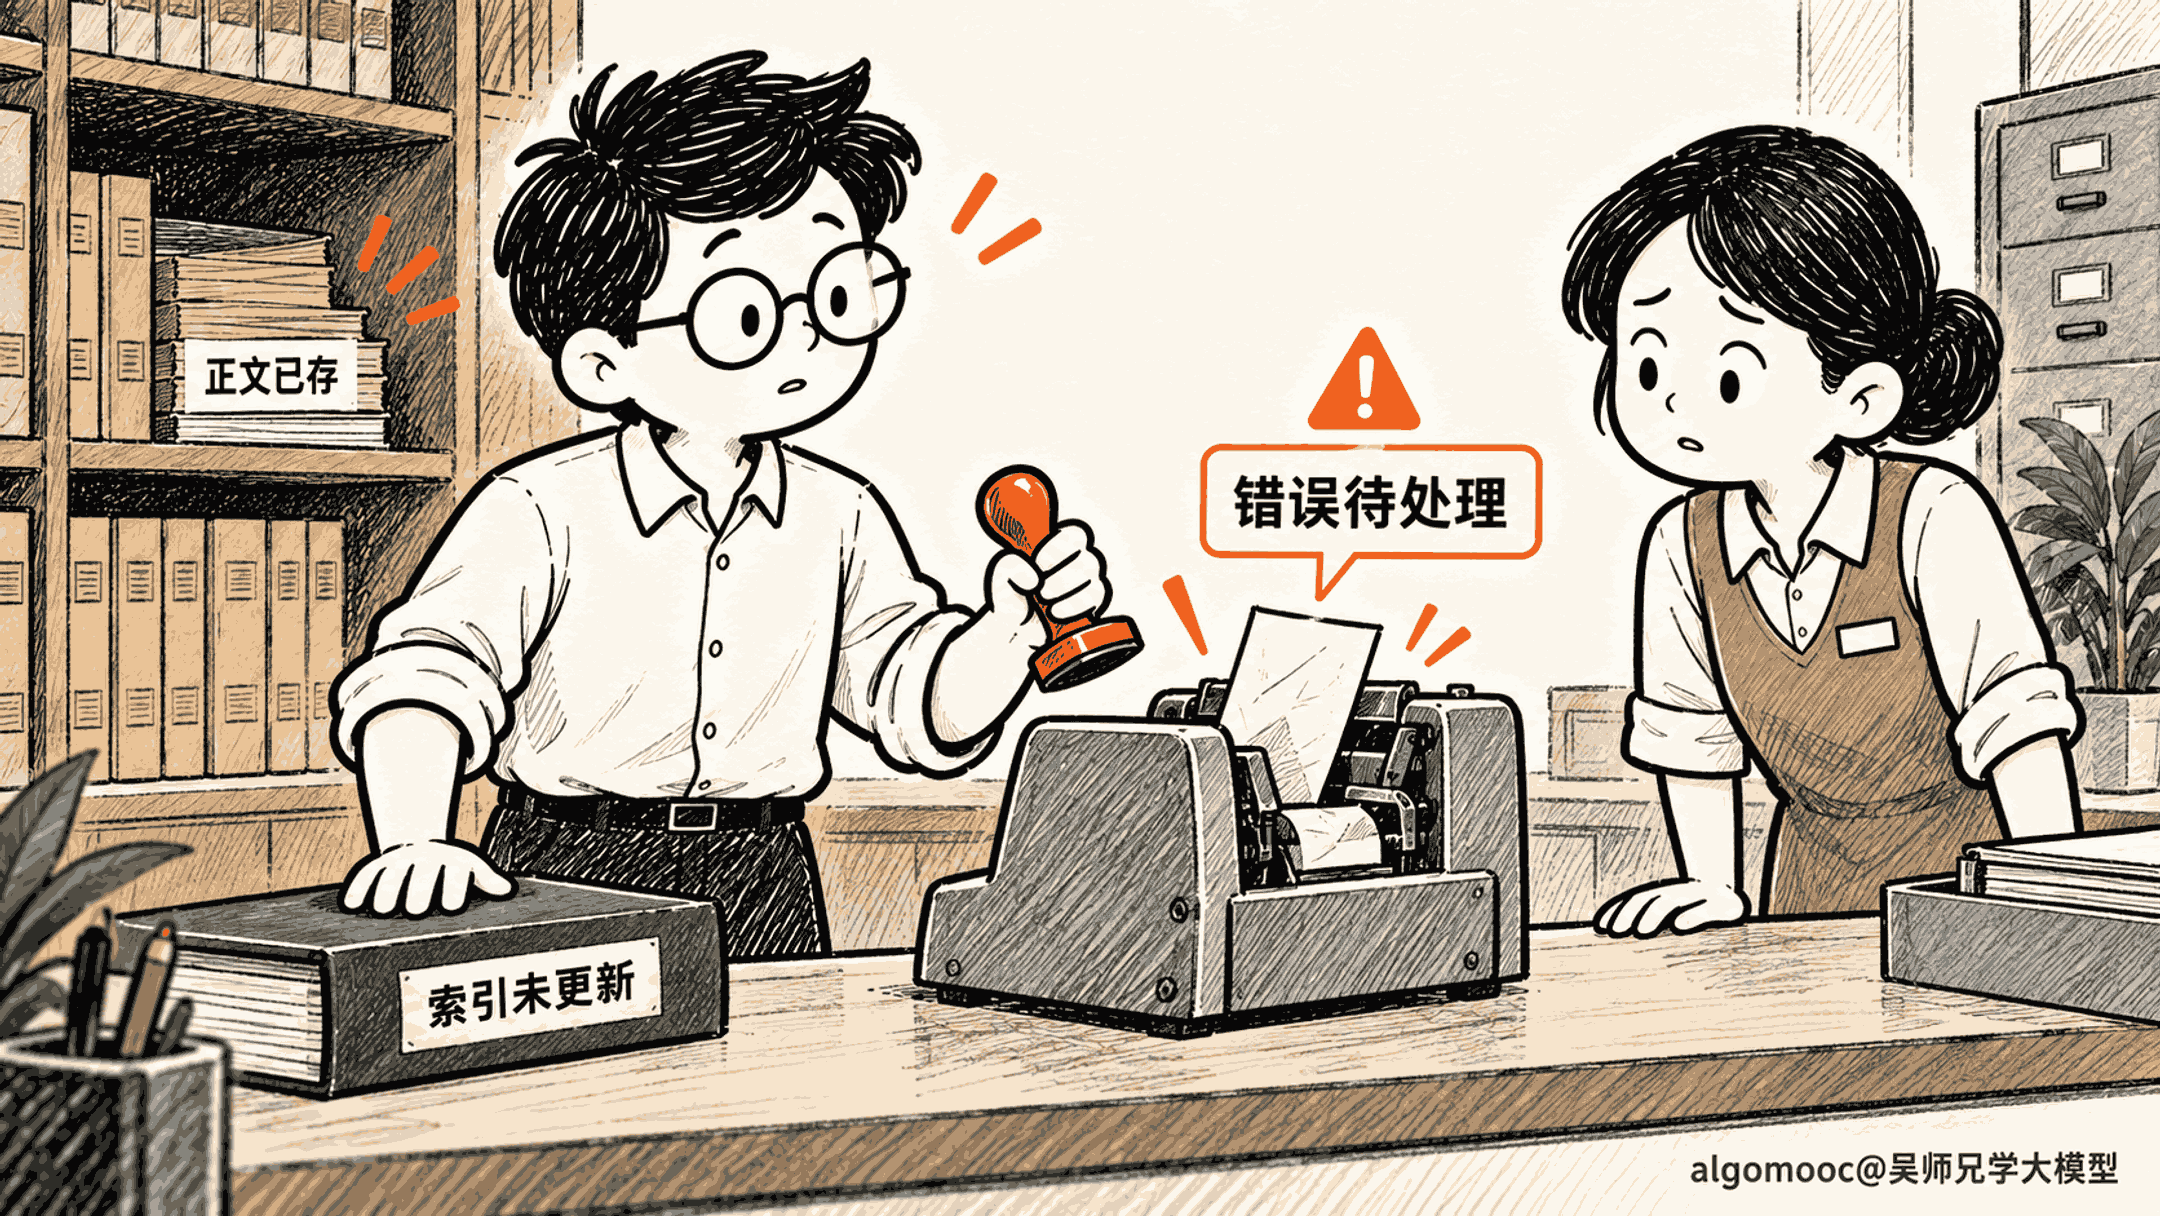
保存正文用的是另一个函数 save_memory。它建立需要的目录,整理文件名,然后把内容写入独立的 Markdown 文件,返回文件路径。调用结束时,正文确实已经保存;这个函数没有顺便修改索引。
因此,只执行这一步,下一次按默认入口构建提示词时,仍可能读到空索引。系统并没有丢掉磁盘上的内容,主会话只是没有从这份目录册拿到它的指针。文件管理器里看得到正文,无法替代对实际提示词输入的检查。
这个差别可以用很小的样本观察。准备一份沟通偏好正文,在里面放一个唯一标记;文件名和准备使用的索引描述都不含这个标记。所有读写都指向新建临时目录,调用原保存函数后,再分别检查文件、索引和构建出的提示词。
实际看到的是:正文内容完整,索引读取返回空值,提示词没有该文件的链接,也没有正文标记。这只说明默认装配入口缺少这条记忆,尚不能把它解释成模型已经看到却没有遵守。
唯一标记放在正文内部,是为了排除另一种混淆:如果文件名或描述本来就写着同一段内容,提示词里搜到它,也可能只是索引行出现了。验证入口时,需要把用于定位的名字与用于确认全文的内容分开,否则很容易把指针当成正文。
扫正文的反例,限定了“找不到”的范围
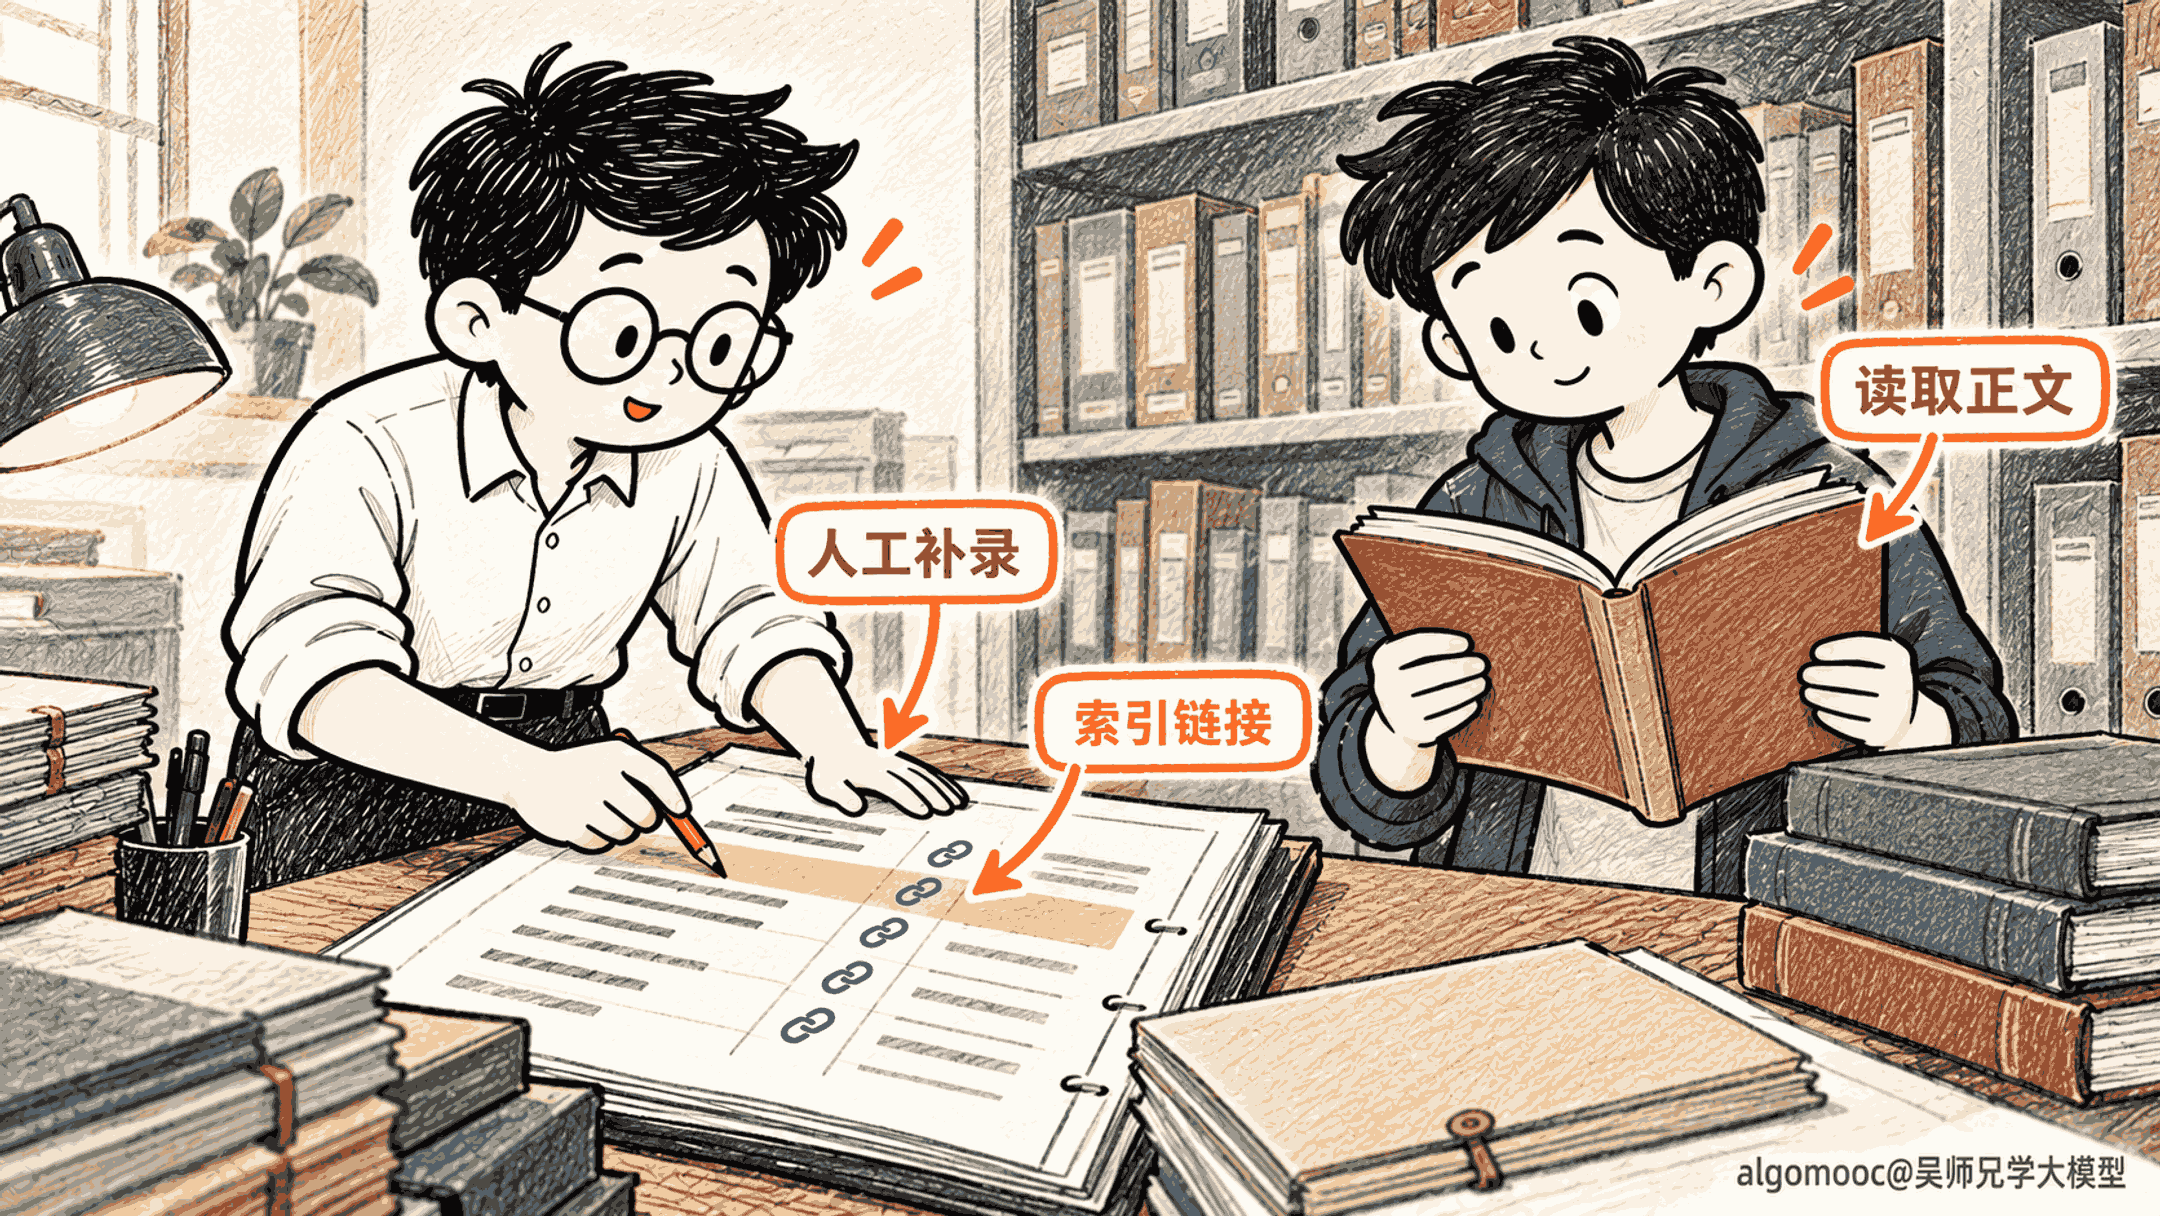
沿默认入口发现缺项之后,还需要反过来问:文件是否能从其他路径找到?如果把“索引没有它”扩大成“模型永远不可能读取它”,结论就越过了这段代码能支持的范围。
同一实现里还有 load_memories。它直接遍历记忆目录下的正文文件,跳过索引,读取其他 Markdown 的内容。这个函数和索引加载承担不同工作,不能因为名字相近,就把它们当成同一个入口。
记忆提取器恰好使用了正文扫描。它准备提取上下文时,会加载已有记忆,把每条内容的前一百个字符放进给提取模型的材料,帮助判断是否重复。这条路径不要求正文事先登记在索引里。