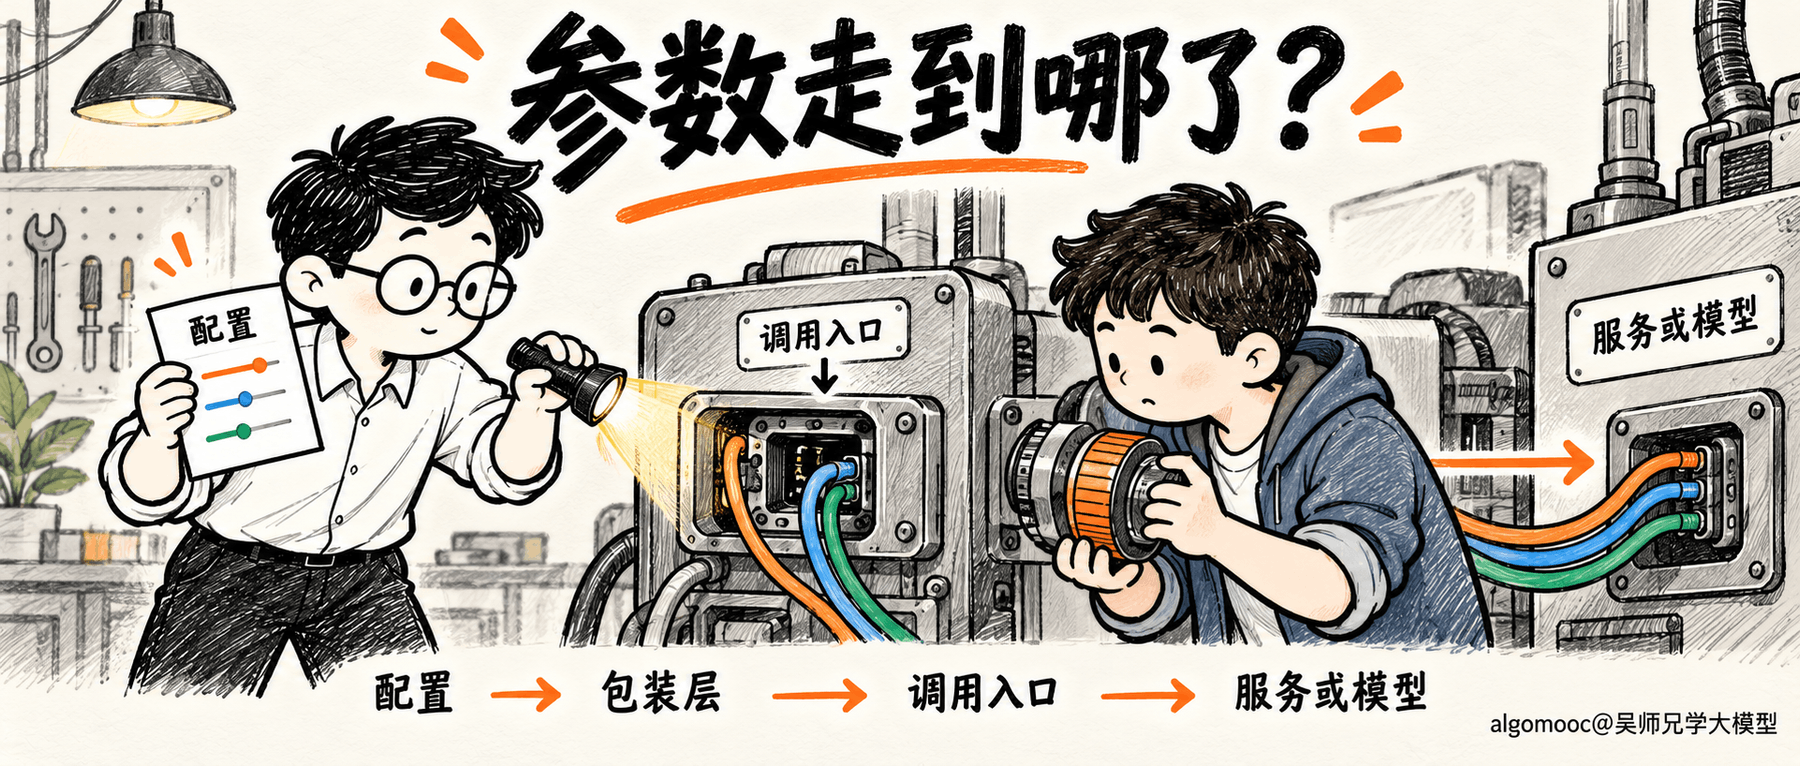
遇到模型复读,开发者很容易先去改解码配置:加上重复惩罚,限制重复片段,再看输出有没有变化。假如日志里已经出现了这两个参数,回答却仍然重复,接下来该怀疑参数力度,还是先确认它们走到了哪里?
本机一份微调材料就给出了加入 repetition_penalty 和 no_repeat_ngram_size 的建议。建议可以提供排查方向,具体工程里还要多核对一层:配置字典经过模型适配器以后,究竟有多少内容进入了下一次调用。
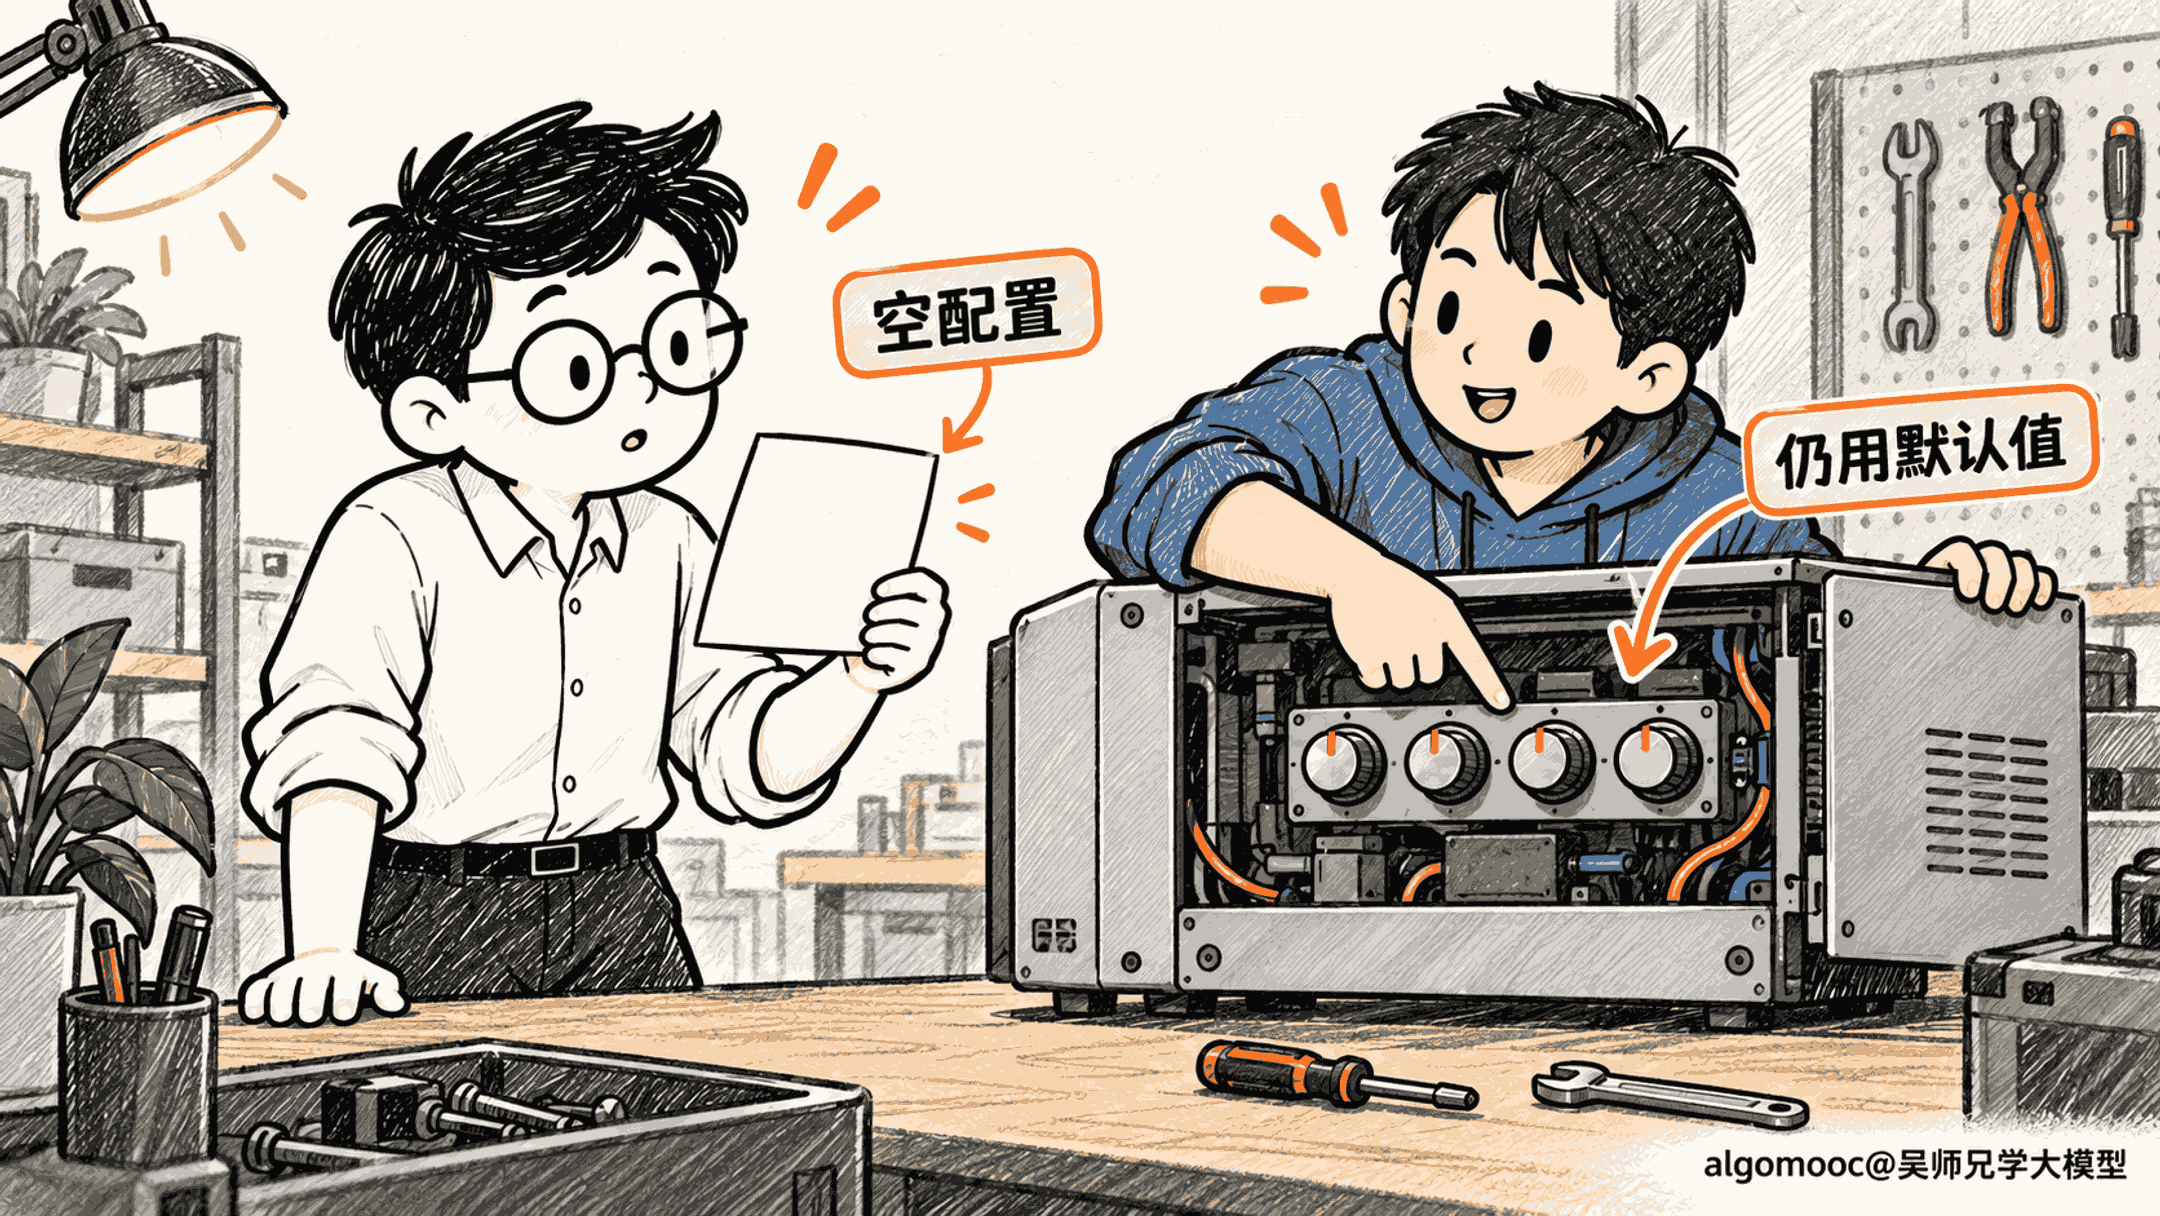
沿当前这份 Agent 训练项目的本地 HF 与 API 两条实现检查,会看到一个容易误判的地方:返回日志保留的配置,可能比实际函数入参更完整;日志里没有写出的默认值,又可能正在参与调用。
排查从调用口开始,别停在配置回显
先看本地路径的职责。LocalHFProvider 接收对话或文本、采样配置和工具说明,在内部准备模型输入,再调用底层的 generate。上层统一使用这个接口,调用方因此不必直接处理不同后端的细节。
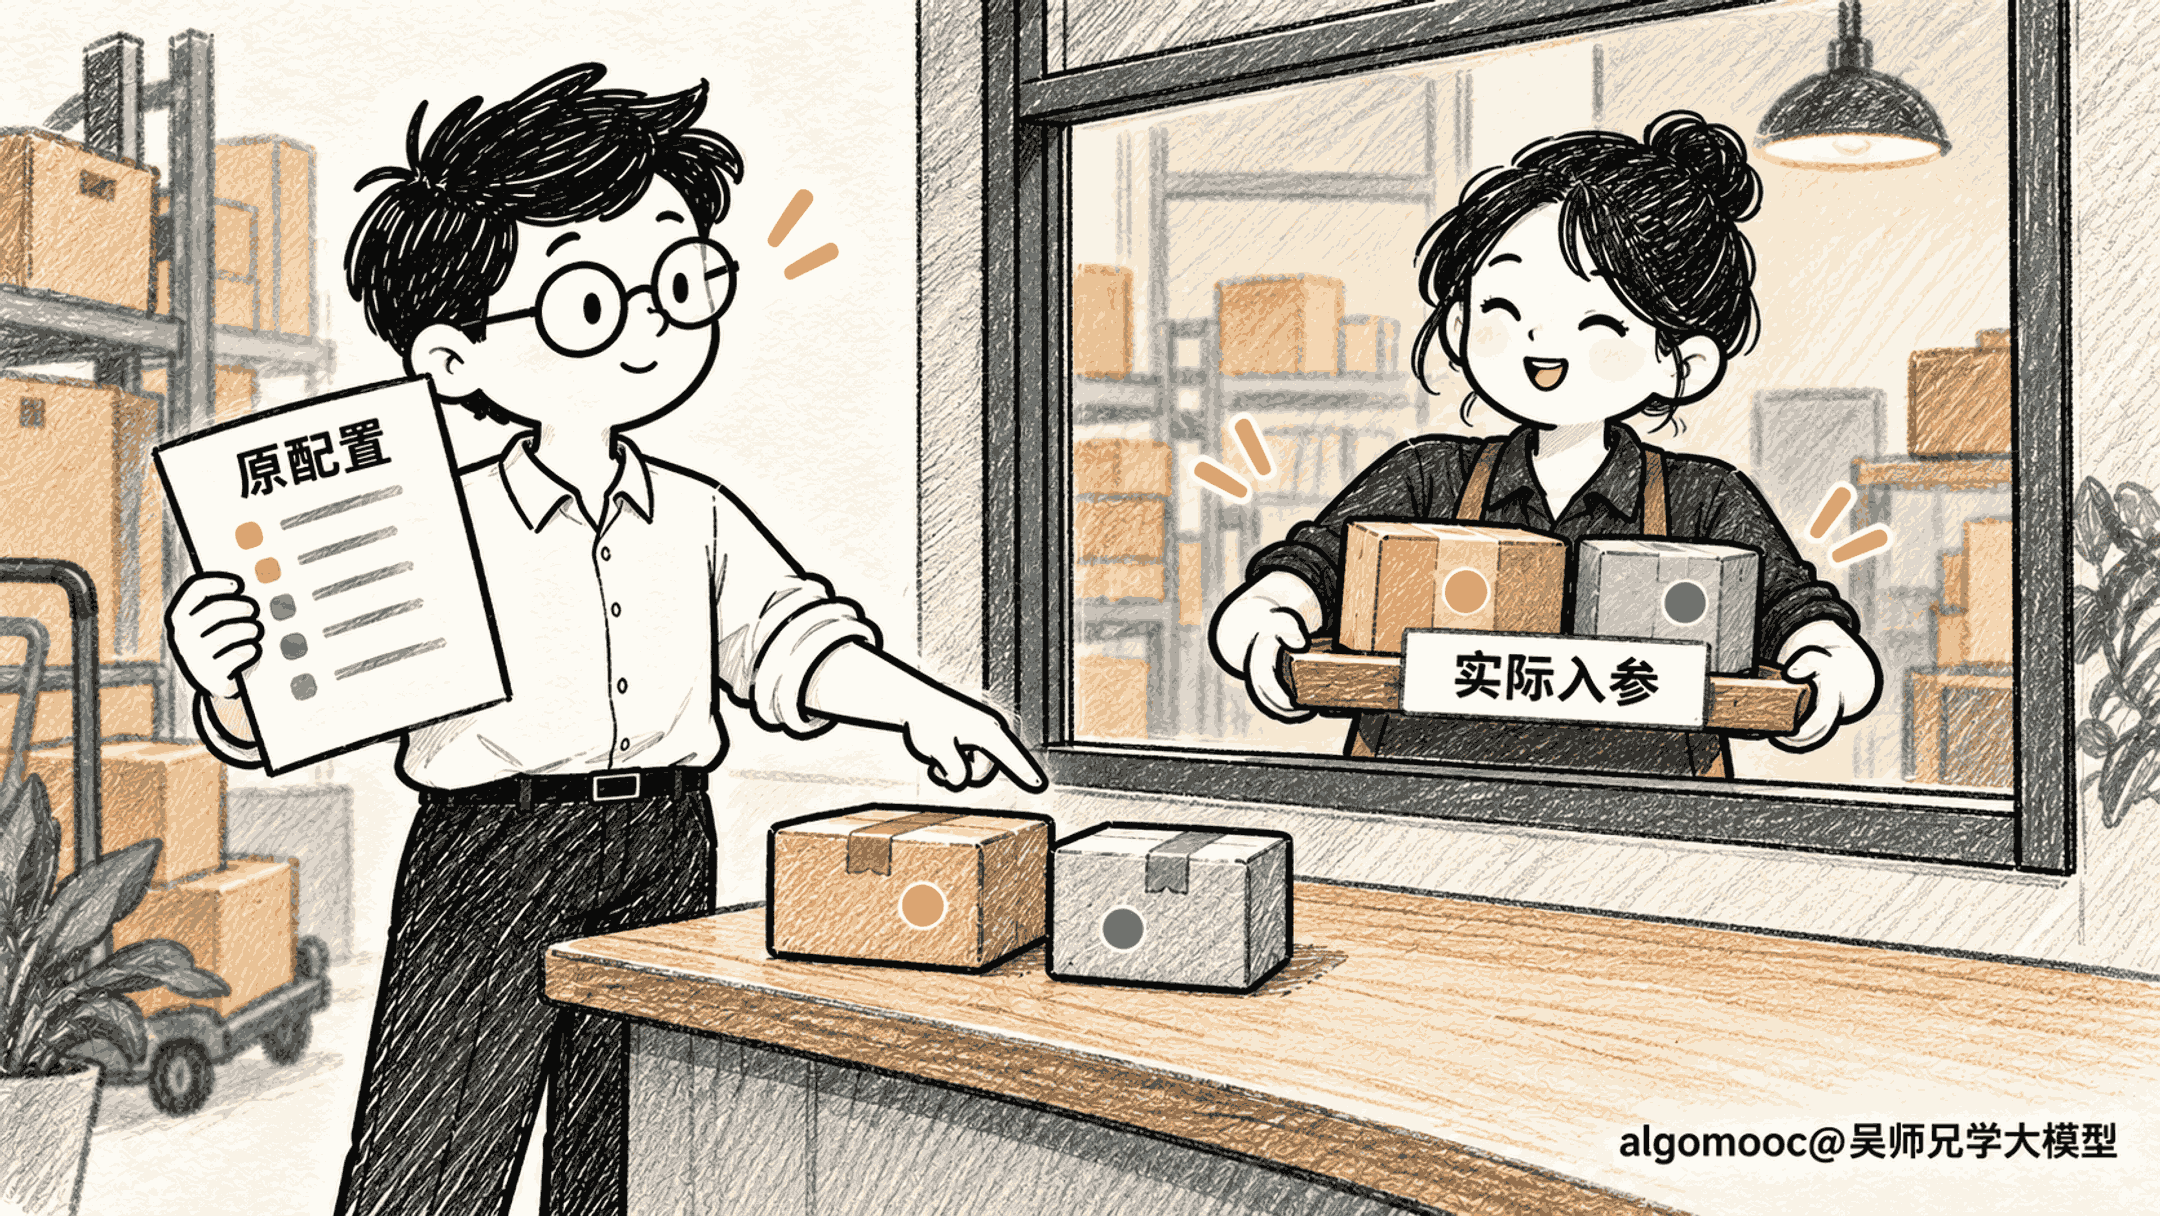
这一层也有自己的选择。原函数从配置里显式取出四个键:新增长度、是否采样、温度和核采样范围,分别对应 max_new_tokens、do_sample、temperature 和 top_p。它把这些值作为独立参数交给下一层,没有把整个配置字典展开传入。
所以,把重复控制的两个键加到字典里,并不会让这份包装代码自动多传两个参数。这里需要区分配置表达的意图与包装层实际完成的动作。参数名字写得正确,仍可能停在调用方与适配器之间。
为了核对这一步,可以让原函数接一个只记录入参的模型替身。验证中选取原始函数节点,保持逻辑不变,用内存对象替代分词器和模型;输入是固定文本,返回也是固定标记,没有加载权重、张量库或执行真实生成。
人工配置里放入四个已选键,再加上两项重复控制。记录函数实际拿到的采样入参,确实只有前四项;返回对象的 sampling_config 却仍保留六个键。对同一次调用,两份记录给出了不同范围的信息。
固定返回文本是有意的。这里要回答的是传递边界,不能让一次碰巧不重复的输出替参数转发作证,也不能让一次仍然重复的输出掩盖调用口已经缺项的事实。先确认请求了什么,后面才有条件比较生成行为。
继续追日志来源,差别就更清楚了。ModelOutput.metadata 把返回对象里的配置放进元数据;运行循环又把这份元数据写入逐步输出记录,并在首步保存模型元数据。同一个键在几处日志重复出现,可能只是同一份回显沿链路复制。
这不能算多次独立确认。要证明包装层传了某个键,应在实际调用边界取证。日志依旧有价值,但需要说明它记录的是调用方意图、适配后的参数,还是服务返回的事实。
字段注释也需要同样核对。返回结构把采样配置描述为本次使用的参数,但真正的赋值来自原配置字典。读代码时,注释可以帮助定位设计意图;当它与实际赋值范围不同,解释运行结果应以执行路径为依据。