代码解释器的演示很容易让人放心:模型写一段 Python,系统删掉危险导入,再把代码交给一个只保留少数名字的字典,最后收集打印结果和图表。门口有检查,房间里也只摆了允许的工具,看起来已经像个沙箱。
项目面试真正要追问的,却是门外的事:运行这段代码的进程,究竟拥有什么权限?任务超时以后,那个进程真的结束了吗?
DeepResearch 里的 CodeWizard 要把模型计划变成计算结果,执行器就会碰到这层边界。限制源码拼写、限制直接可见的名字、限制实际运行环境,分别约束不同的东西。把前两项做好,不能顺手宣布第三项也成立。
本文沿一份本地代码解释器教程,只做三个无害验证。输入全是作者固定的小样本,文件全在新建临时目录里,子进程只短暂睡眠。先看这些证据到底能支持什么,再决定项目应该怎样描述自己的保护。
误拒发生在执行之前,先定位字符串规则
教程的检查函数先扫描禁止导入的模块拼写,再查找几个危险函数名和调用片段。命中就返回错误,全部没命中才继续执行。它适合展示一个清楚的准入流程,也能给直观误用提供反馈。
但这层检查读的是字符,不知道一段字符在程序里扮演什么角色。同一个拼写,可以是一次调用,也可以只是说明文字中的一部分。
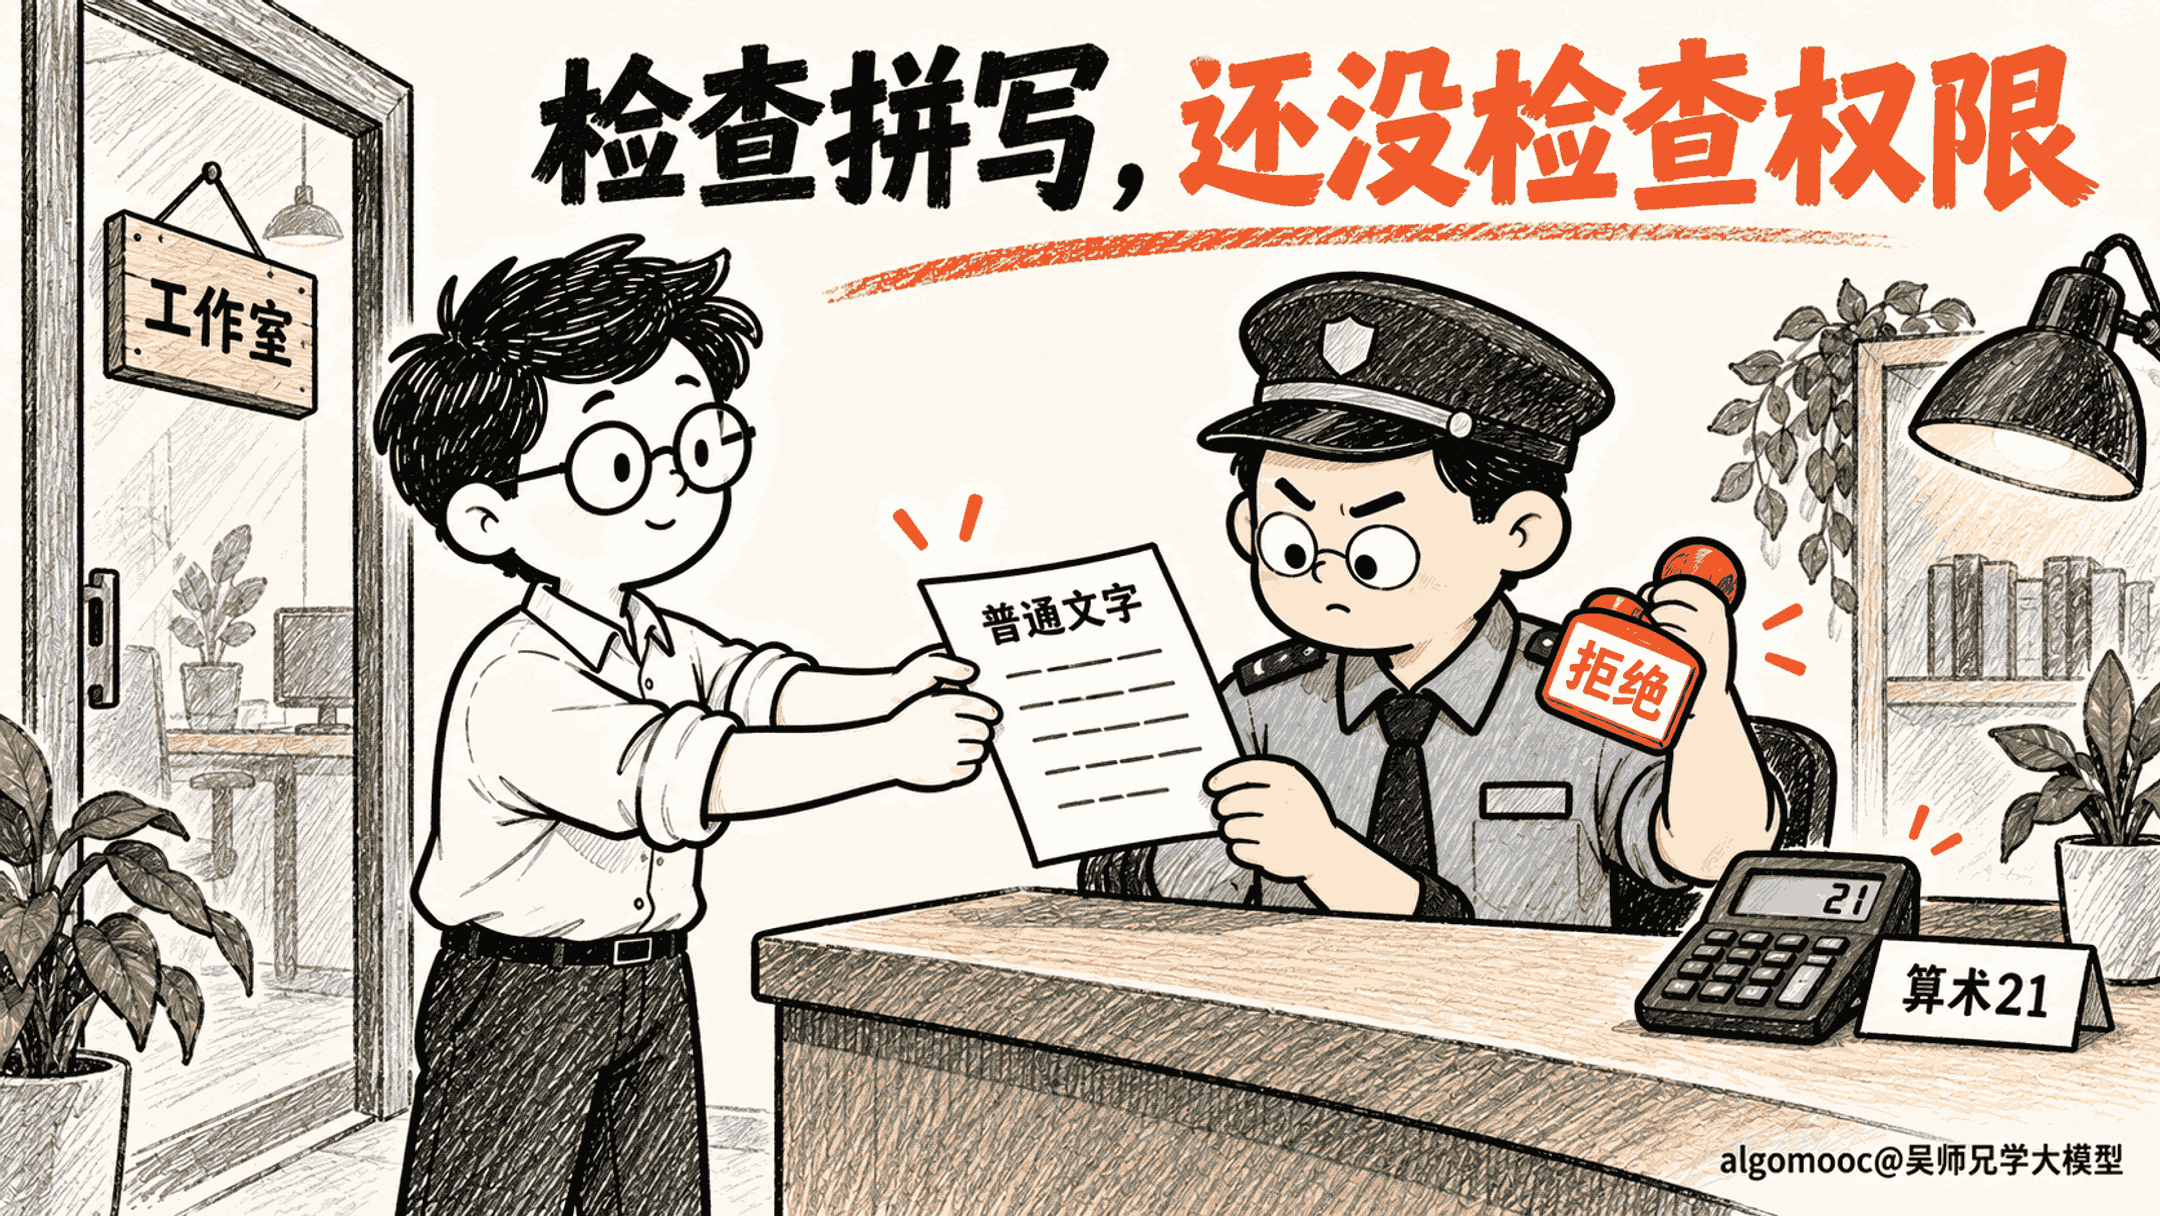
我按教材展示的规则做了对照。第一份输入把一到六相加并打印,检查允许,在受控子进程里得到二十一。第二份输入只打印一句说明,其中提到了 open( 这个拼写;它没有尝试打开文件,却因为字符串命中被拒绝,也就没有进入执行阶段。
这个结果无需任何绕过技巧。仅用普通文字,就能看到规则的粒度:拒绝原因来自源码里出现了什么字符,并不等于程序真的申请了相应权限。
误拒普通文字会影响可用性,而“没有命中”也只表示这组模式没出现。要把允许结果解释成安全结论,还缺运行时行为和权限的证据。不能用几条被拒的演示,推出其他所有代码都已经受到完整约束。
因此,检查记录应保留命中的规则和拒绝阶段。这个普通文字样本没有执行,不能记成“运行后发现它没有危害”;算术样本则确实进入执行并产生结果。把准入和执行的观察分开,才能判断到底是规则过严,还是运行保护缺了一层。
换成语法树,可以更准确地区分字符串内容与调用节点,也方便限制允许的语法。但它仍是一层代码分析。依赖对象具体做什么、操作系统允许进程做什么,不会因为解析方式更精细就自动变成已验证事项。
教材还有另一层:给 exec 提供受限的 safe_globals,显式设置内置名字,只保留打印、求和等函数,并放入预加载的库对象。这里确实缩小了直接入口,并非完全没有约束。
Python 官方文档同时明确,改写内置名字不是安全机制。名字空间规定怎样找名字,并没有创建另一个操作系统身份、另一套文件权限或独立网络环境。