假设你给 Agent 一个任务:读取销售 CSV,整理成一页汇总报告,销售额和退货额分开展示。它装了两个 Skill,一个负责汇总报告,一个负责活动海报。当前任务只需要前一个,海报里的配色、标题和版式规则可以先留着。
于是,你打算先给模型一份短目录,等它选中汇总报告,再读取具体说明。这通常被称为渐进披露:需要的信息随着任务推进,逐步进入上下文。
可你打开项目代码,发现启动时已经逐个调用 read_text,把所有 SKILL.md 的全文都存进了管理器。既然全文早就读了,渐进披露到底体现在哪里?
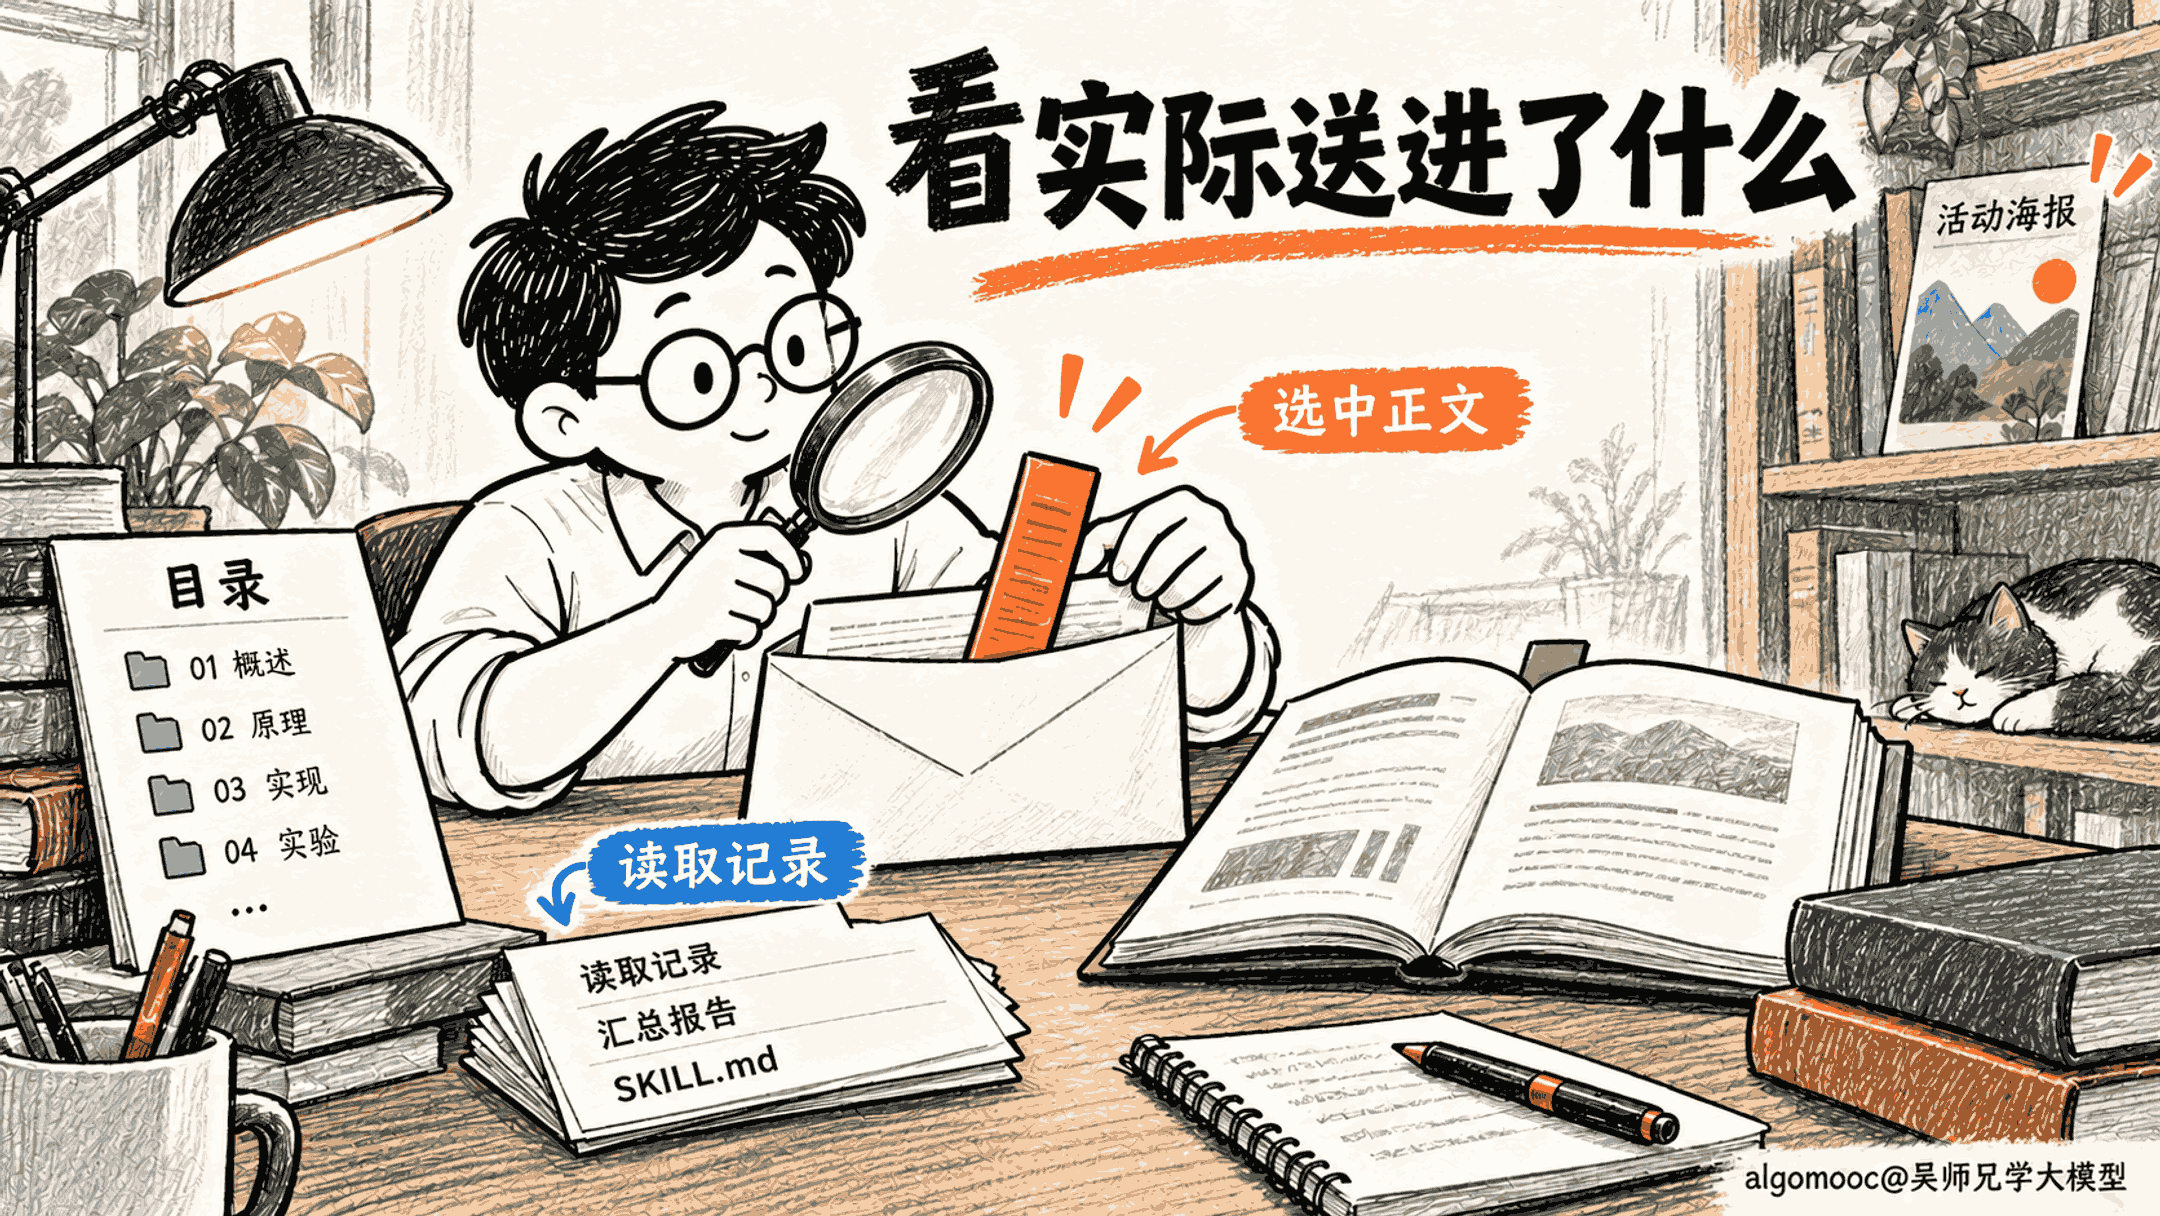
答案藏在“加载到哪里”。磁盘上的文件被读进应用进程,不等于全文已经发给模型。 要判断 Skill 是否按需披露,应该沿实际模型请求往下看,不能只数程序读了几次文件。
一次加载,可能指向三个位置
先把同一份说明书经过的位置分开。它最初是磁盘上的文件,管理器扫描后成为进程中的字符串,最后才有机会进入发给模型的请求。这三处保存的内容,不必完全相同。
在这份本地 AgentSkills 实现里,SkillManager 扫描每个技能目录,读取 SKILL.md,解析开头的元数据,再保存名称、描述、路径和完整内容。到这一步,进程确实已经拿到了两个 Skill 的全文。
接下来构建系统提示词时,代码没有把保存的 content 直接拼进去。它只逐个加入技能名称、描述和说明文件路径,并告诉模型:当任务匹配某个 Skill 的描述时,先通过读取工具查看对应文件。
所以,进程里可以同时存着汇总报告和活动海报两份长说明,第一次模型请求里却只有它们的短入口。管理器持有什么,与这次请求发送什么,是两个独立的实现选择。
这样做的直接作用,是让未使用的技能正文暂时不占当前模型输入。它并没有省掉启动扫描的文件读取,也没有减少管理器保存全文的内存。如果项目真正卡在扫描大量文件上,要另外考虑扫描与缓存的设计。
这也是面试里值得讲准确的地方。“按需加载”容易让人联想到文件需要时才读,而当前代码延迟的是全文进入模型上下文的时点。把两层混在一起,后面讨论启动时间和输入规模时,就会各说各的。