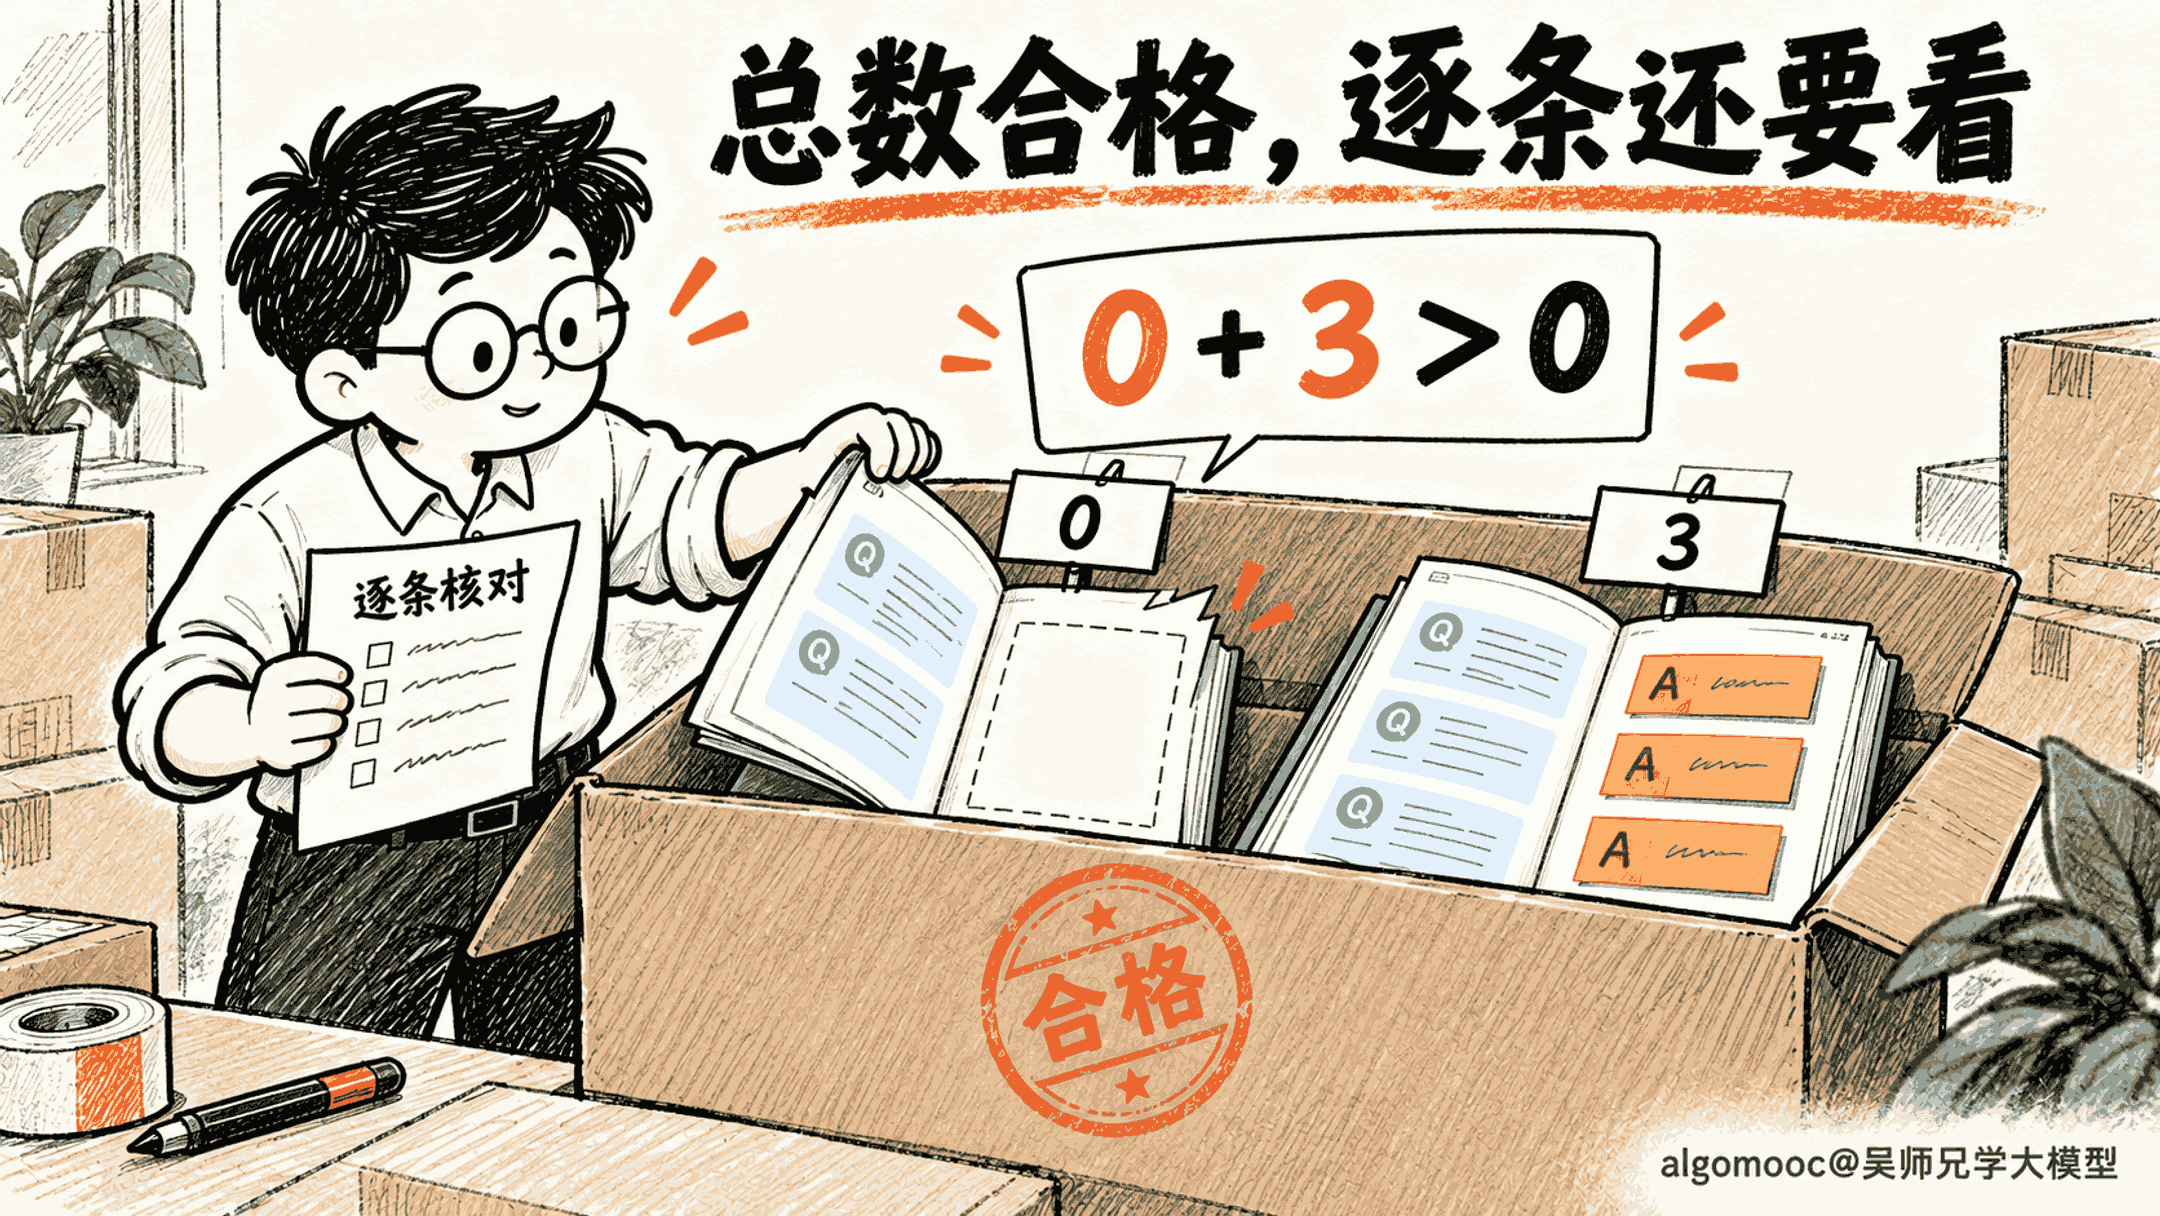
训练前的检查日志里,假如出现这样一组结果:两条样本,监督位置总数是3,最少的一条是0,最多的一条是3。脚本继续往下走了。你会把这批数据判断为可训练,还是先停下来看看那条0?
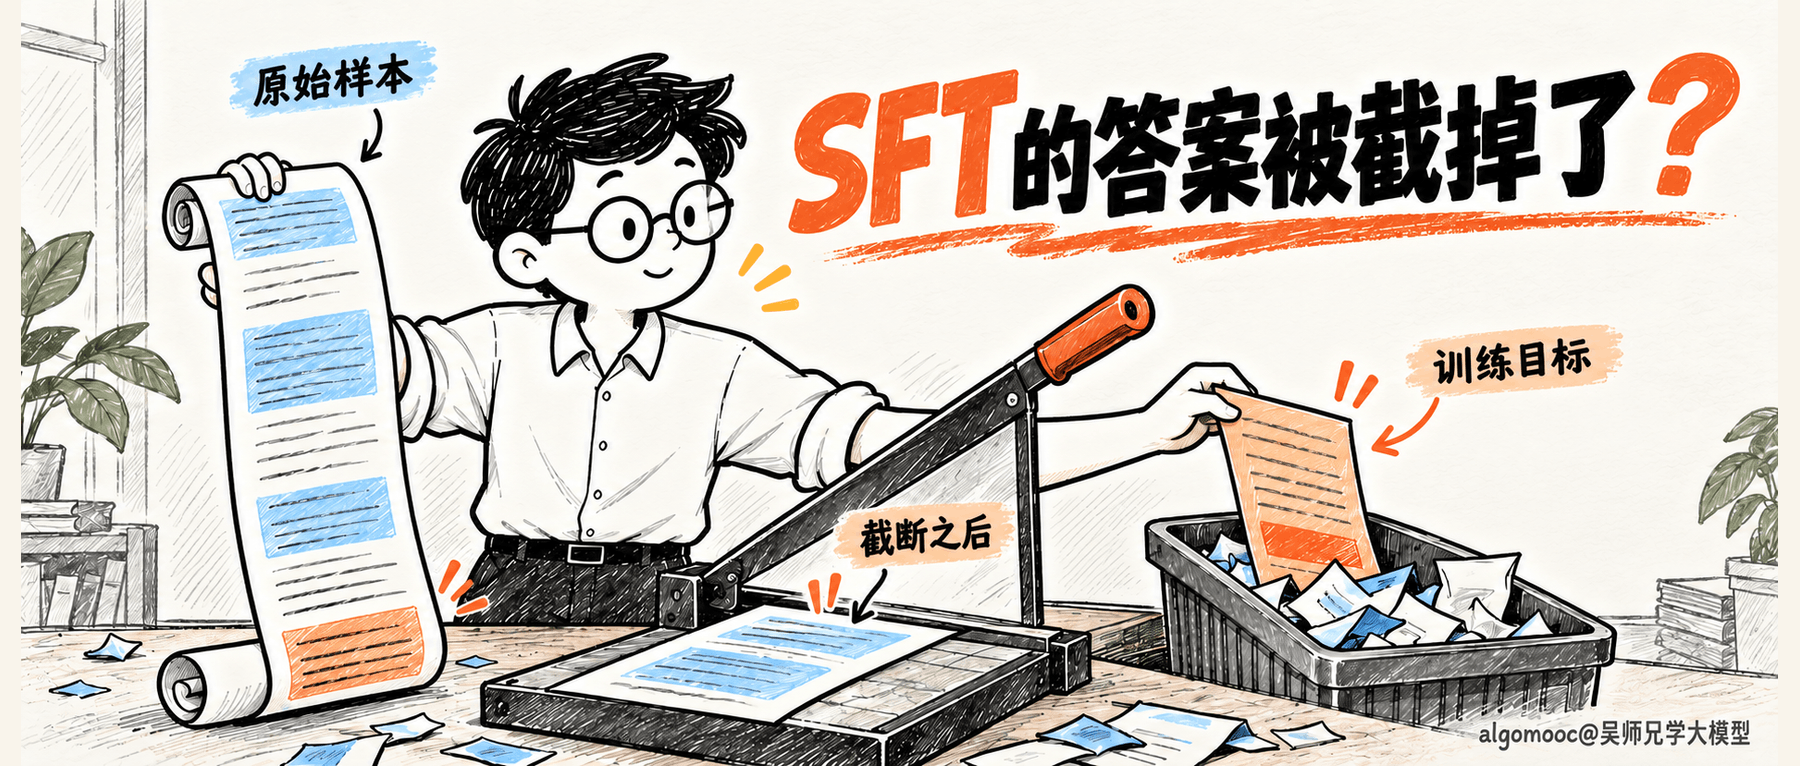
原始文件里,两条样本都可以有答案。打开对话,用户的问题在前,assistant的回答在后,内容完整,角色也没有写错。但模型接收到的是经过模板、分词和长度处理后的序列。原文里的回答存在,不等于进入训练的那一段还保留着回答。
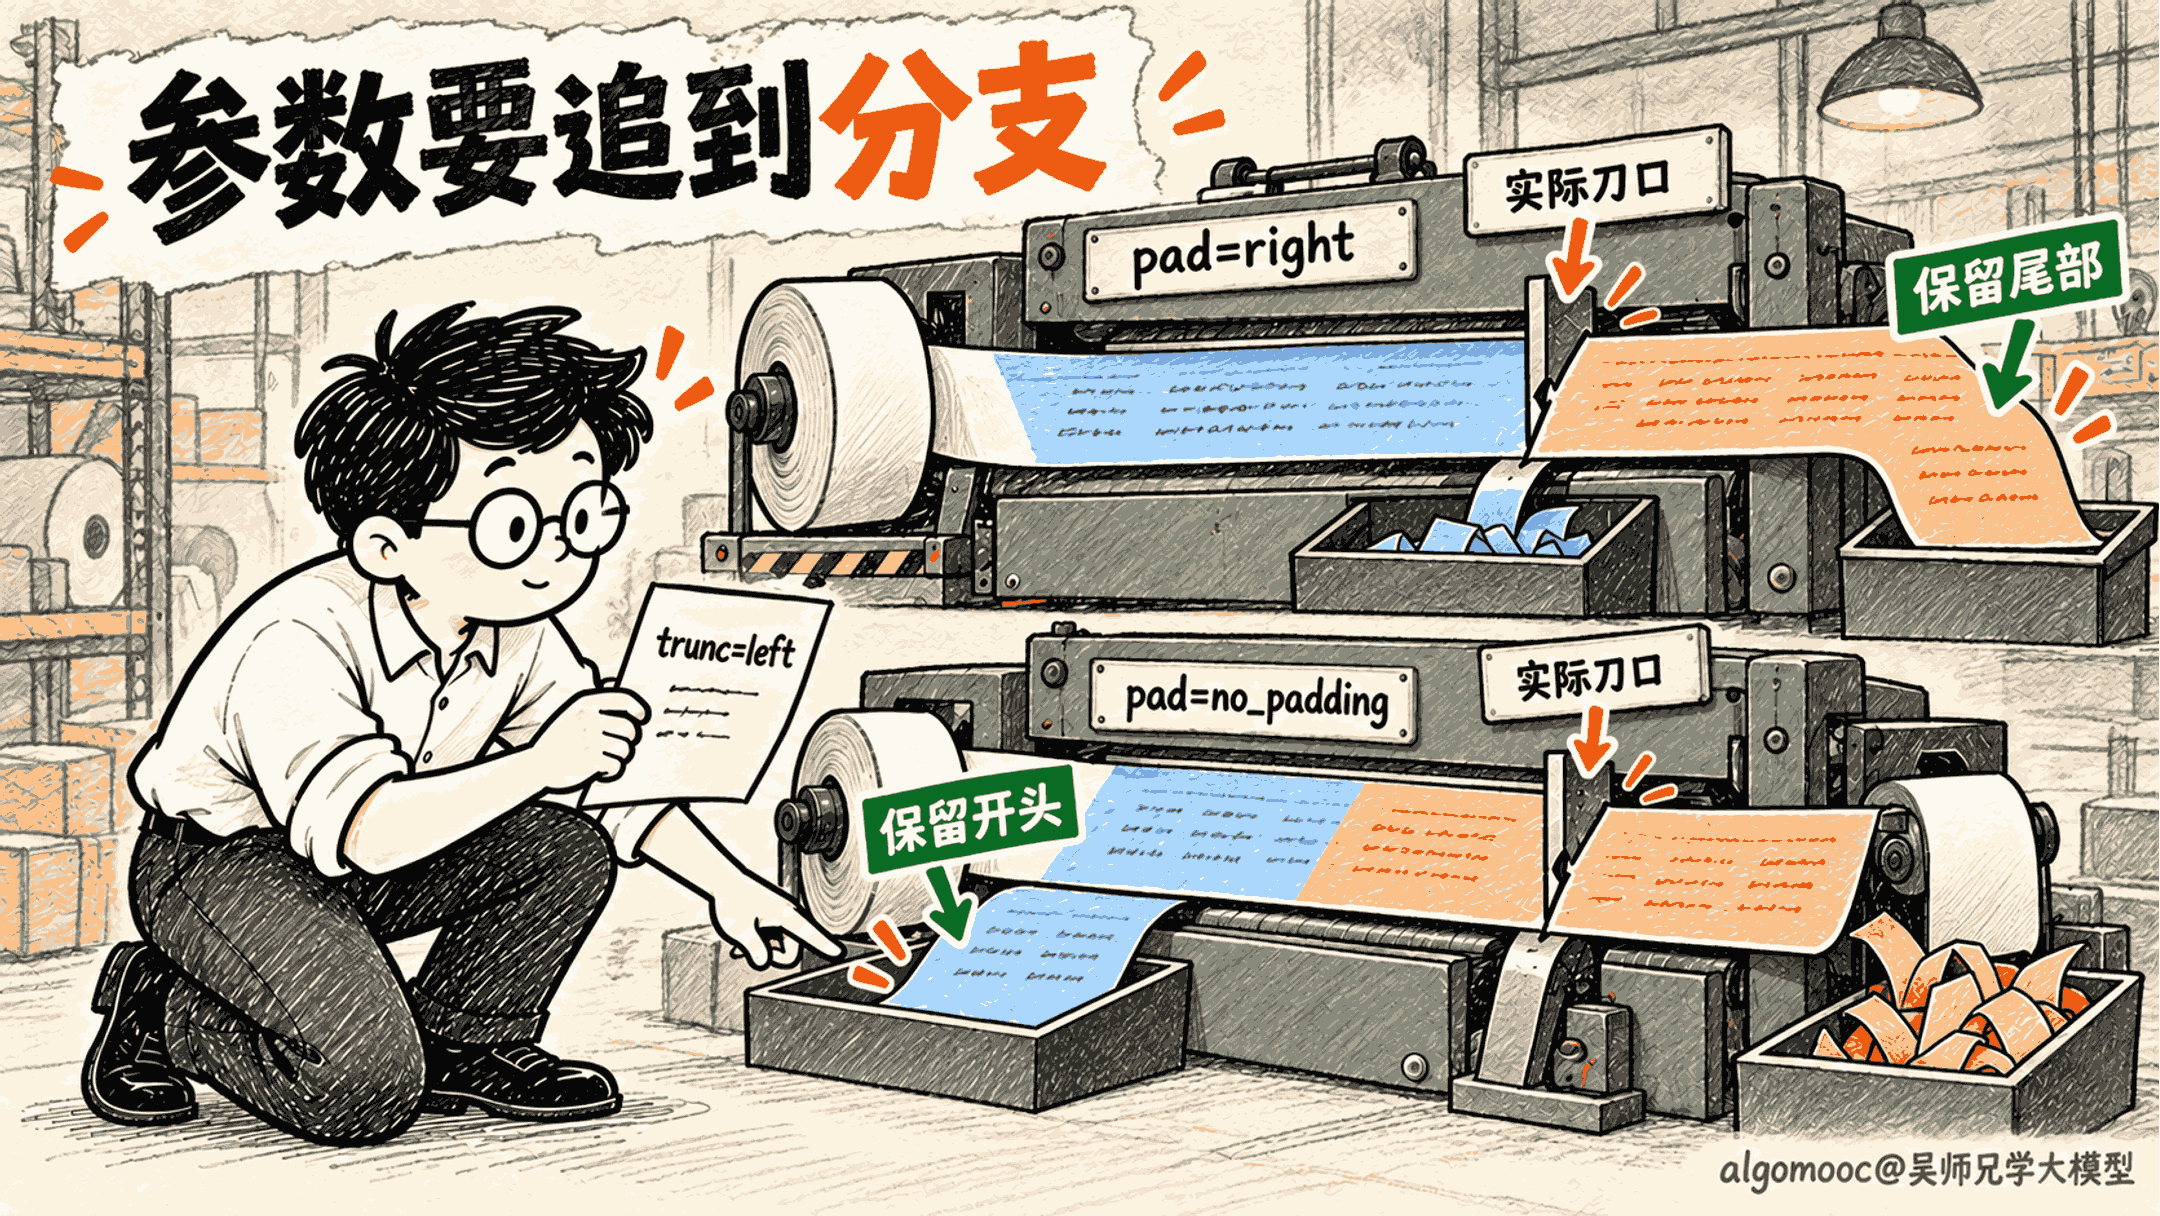
这个问题很容易被一个配置名掩盖:已经设了向左截断,答案在尾部,按理应该留下。再加上预检没有报错,就更像是数据已经过关。真正要核对的,是当前代码走了哪个分支,以及预检通过究竟检查到了哪一层。
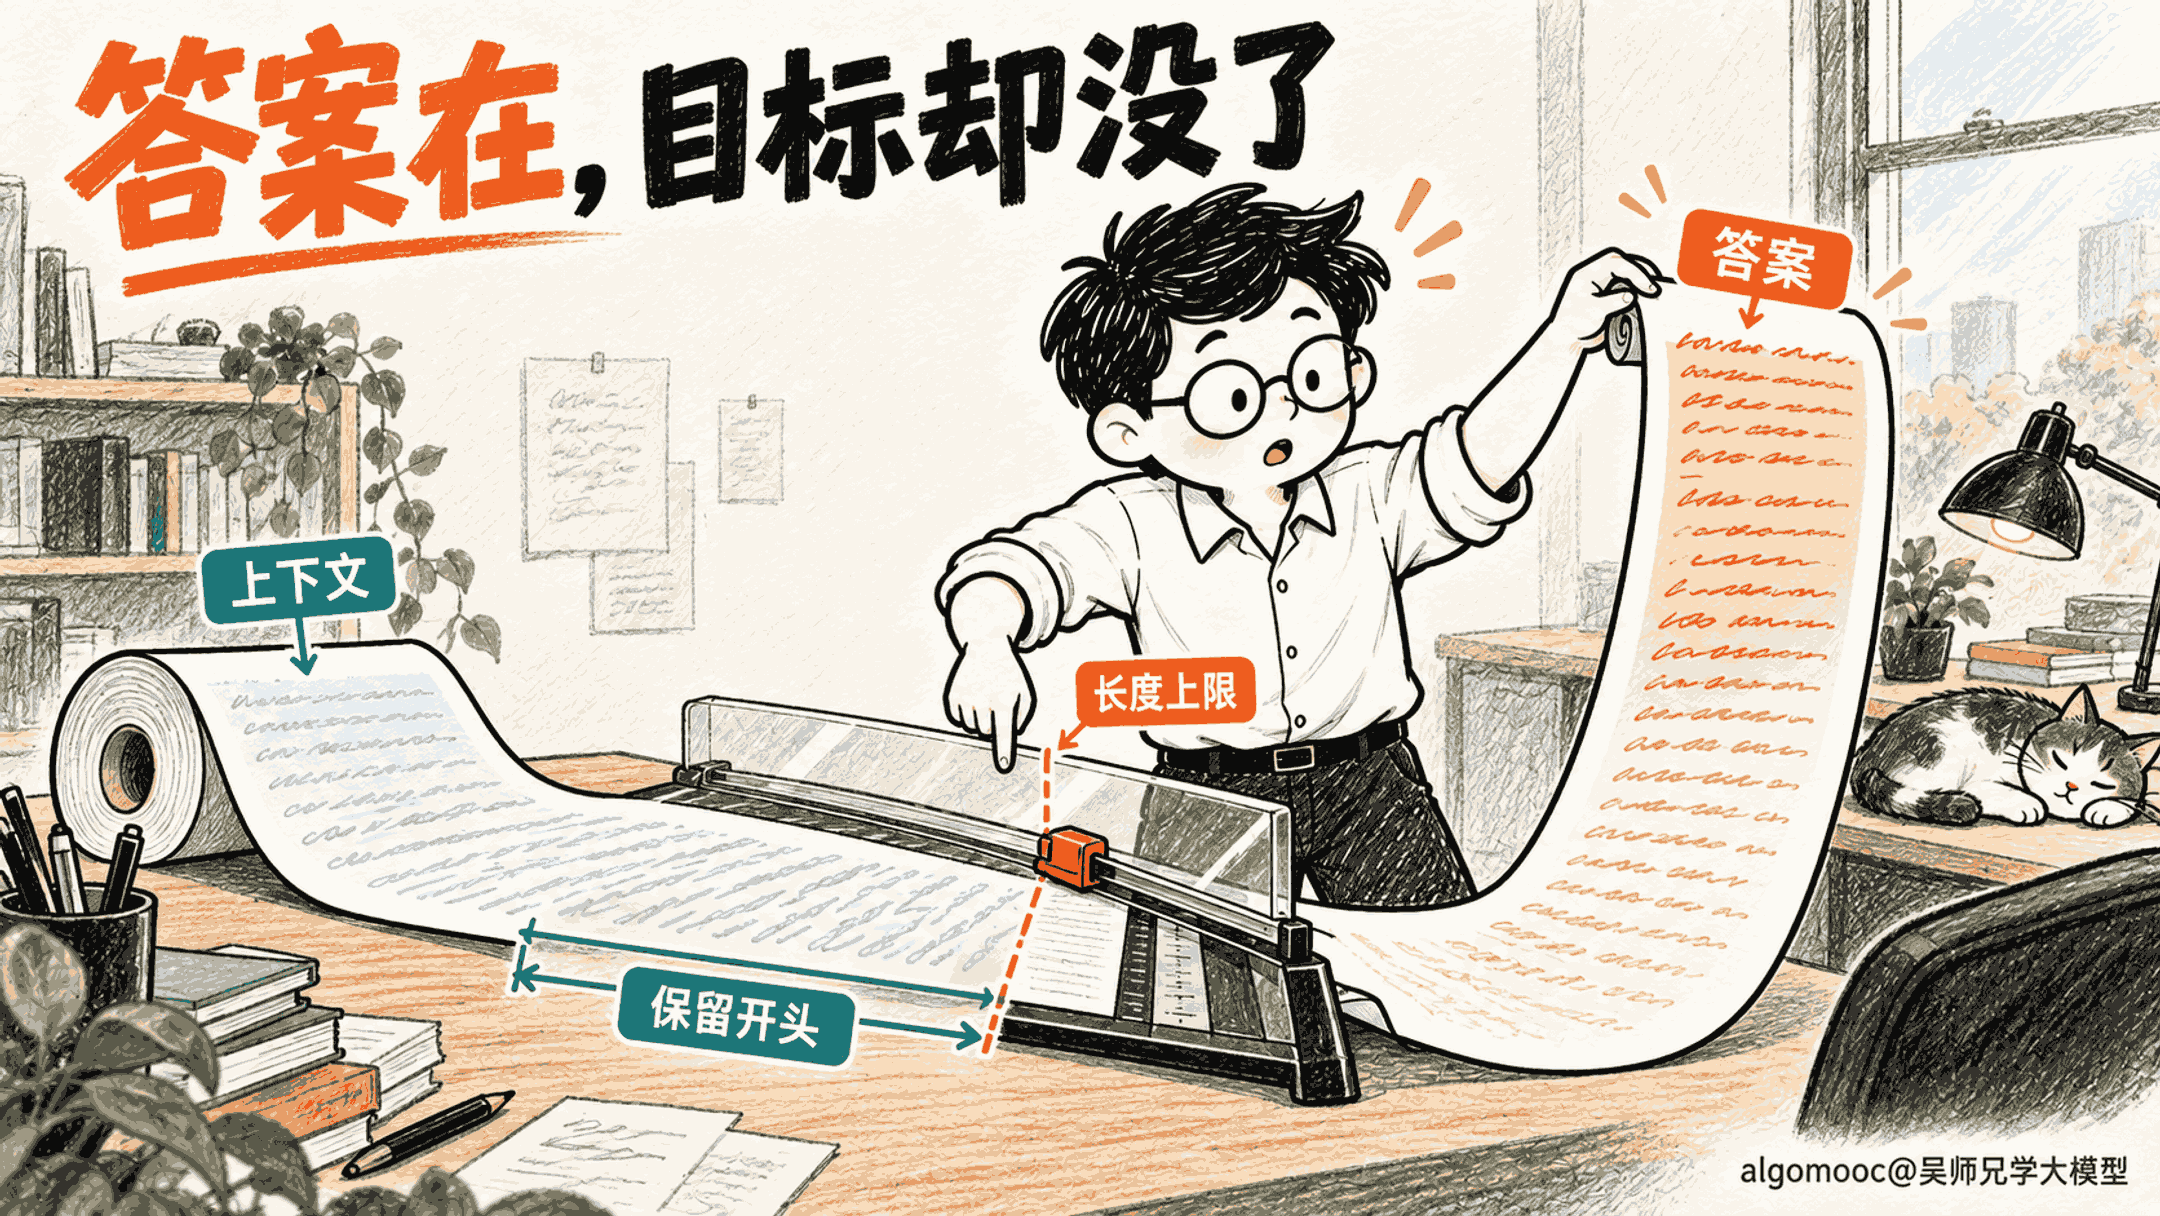
日志里的0,从哪里来?
SFT让模型学习给定上下文中的示范回答。对于多轮对话,输入里可能同时放着系统说明、用户问题和assistant回答,训练时需要区分哪些位置承载上下文,哪些位置作为学习目标。这里承担标记职责的是loss_mask。
在这份训练包的多轮数据集中,每条消息先经过聊天模板处理。assistant消息对应的掩码先置为1,再把回答开头的生成提示部分置为0;其他角色的消息置为0。各条消息的编号、掩码和注意力标记随后拼接,形成同一条序列。
所以,统计对话里有几条assistant消息,只能说明原始角色结构。真正用于检查监督是否存在的,是处理后的掩码里还剩多少个1。输入中置0的前文仍然承担上下文作用,不能因为它不作为直接回答目标,就认为这部分内容没有必要保留。
先把规模缩小。假设处理后的序列一共10个位置,前7个都是上下文,最后3个才是答案目标。为了看清裁切关系,我们把长度上限设为6。保留开头6个位置,得到的全部是上下文;保留结尾6个位置,则留下3个上下文位置和3个答案位置。
两种结果长度相同,都没有超限。区别在于,第一种结果的监督数量是0,第二种是3。仅检查输入是否非空、长度是否合规,无法把它们区分开。原始文件里那份完整答案,此时甚至还好好地躺在磁盘上。
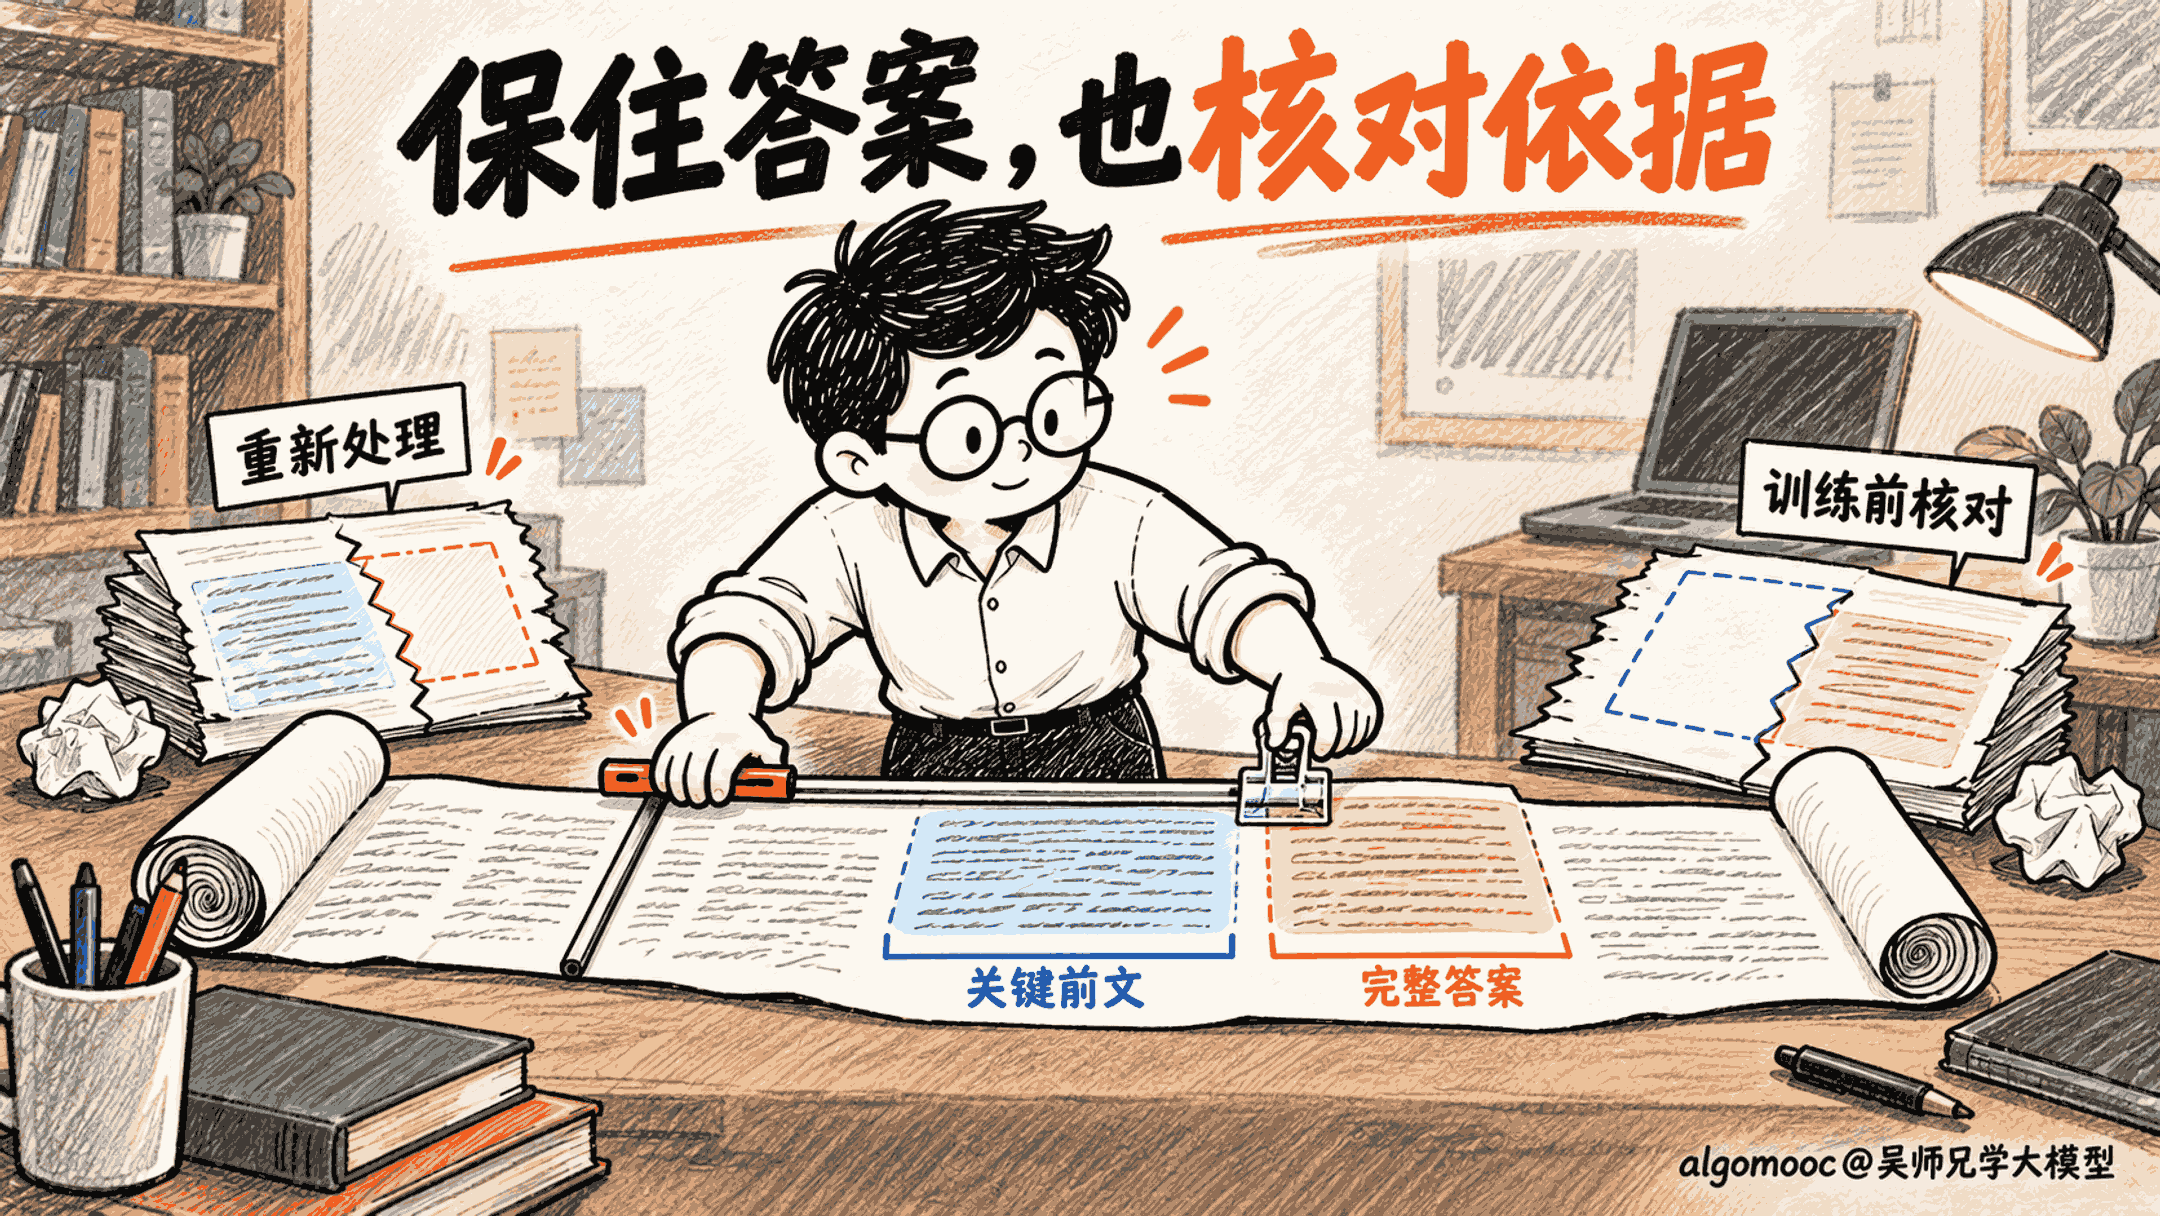
这也是排查时应该打开中间结果的原因。把截断后的输入和对应掩码放在一起看,才能知道当前样本准备让模型学什么。只读原始答案,或者只打印序列长度,都绕过了决定训练目标的那一步。
长度也应在模板处理之后计算。角色标记、生成提示以及随输入带入的工具定义,都可能占用序列位置。原文看起来只有几段,并不能说明经过分词后仍在预算内。沿实际输入处理路径统计,才能让长度上限和最后留下的答案落在同一个口径上。
向左截断,为什么会留下开头?
我核对的是本机S5训练包中随包保存的一份verl实现。它的多轮SFT数据集按pad_mode分成两条处理路径。这个参数决定填充方式,也决定长度处理代码进入哪个分支,因此不能只看truncation的名字。
在分支里,短序列会在右侧补齐;遇到超长序列,再判断截断方向。设置时去掉左边,保留尾部;设置时去掉右边,保留开头。输入编号、注意力标记、监督掩码和位置编号一起取相应区间。