正确段落就在知识库里,Reranker也正常返回了分数,最后选出来的内容却没有它。这时换一个更大的重排模型,看起来很有道理:既然排得不好,就换个更会判断相关性的模型。
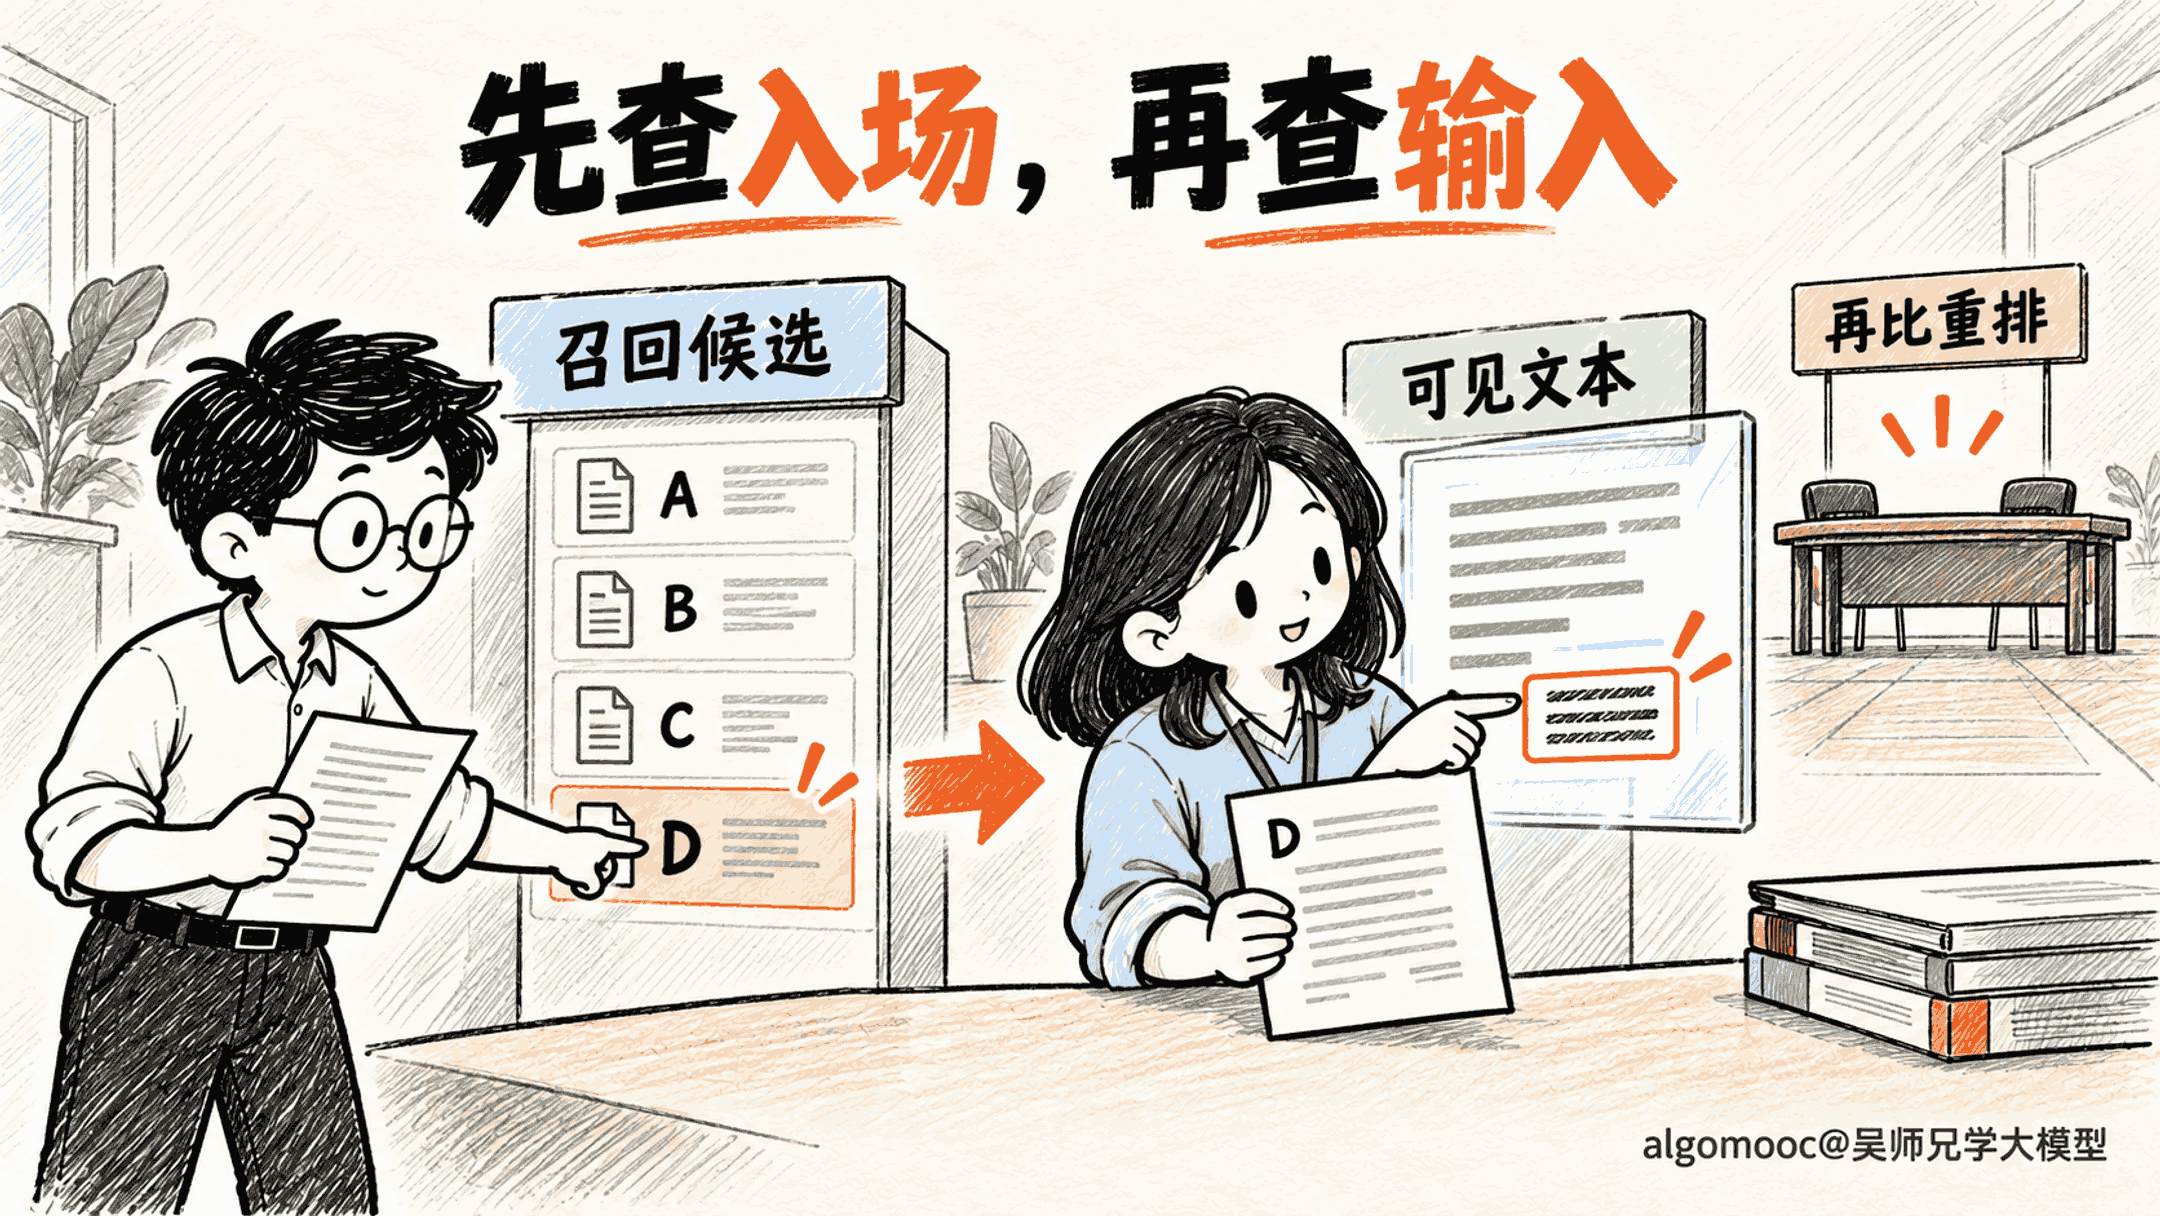
但先别急着换。需要确认的第一件事是,那条正确段落有没有被交给Reranker。第二件事是,它虽然在候选名单里,真正输入的文本是否还保留着回答问题所需的句子。两层都过关,排名高低才进入模型能力的讨论。
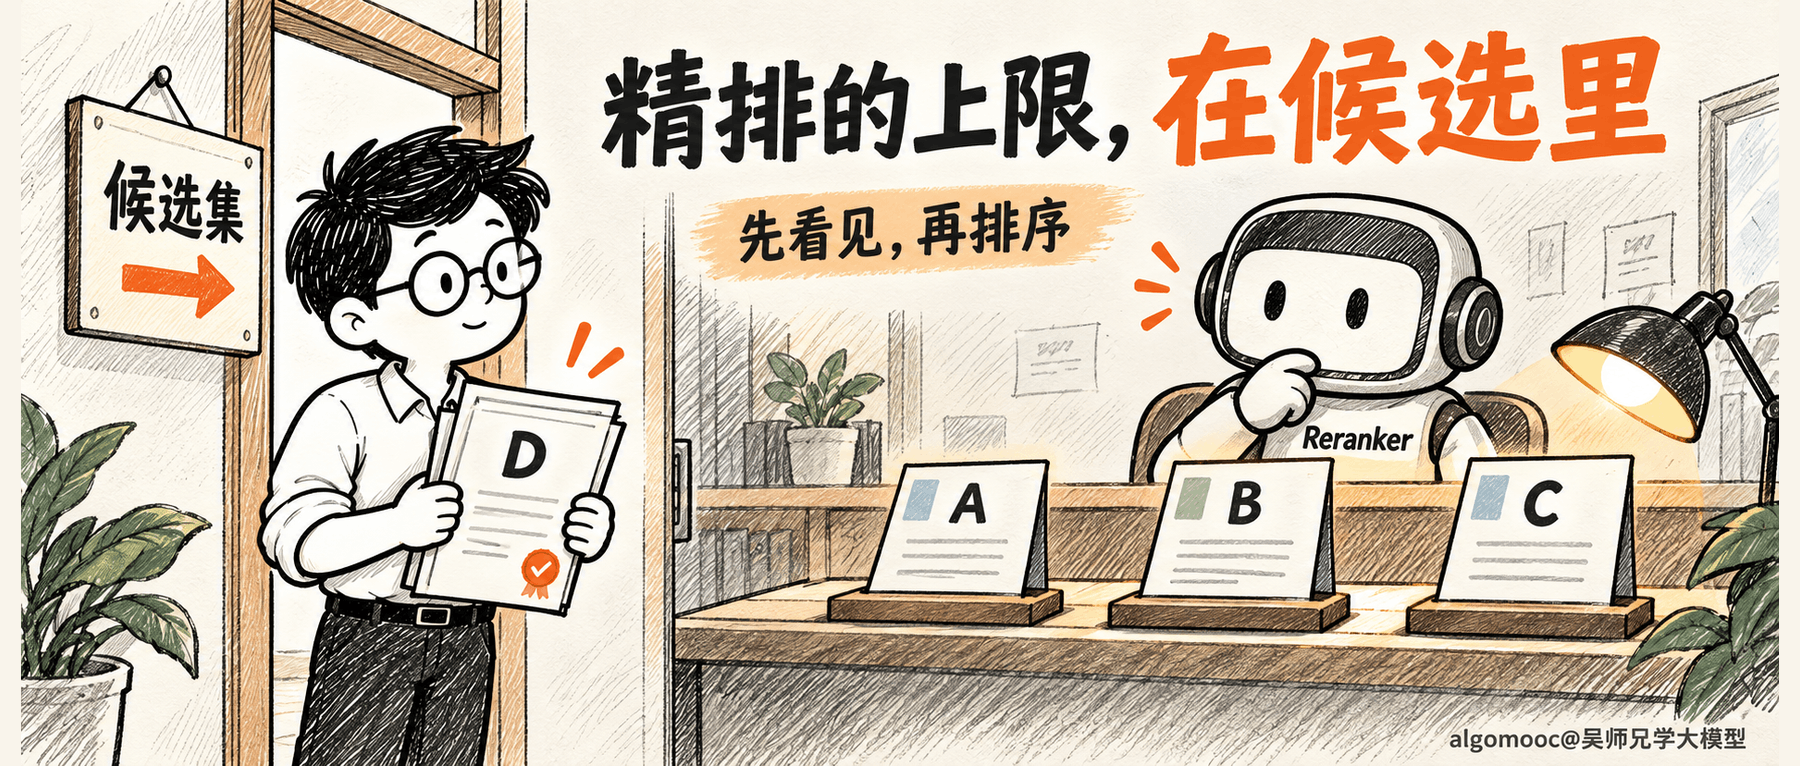
Reranker通常对问题与候选文本联合打分,再从这些候选里调整顺序。它能细看已经送到面前的材料,却不会因为模型更强,就自动从知识库其他地方找回缺席的段落。候选集和输入表示,先划定了这次排序的工作范围。
我们用一份合成报销资料把这个范围看清楚。下面的名单、问题和证据位置都由人工给定,只检查候选与可见文本,不加载模型,也不把字符串检查当成真实相关性预测。
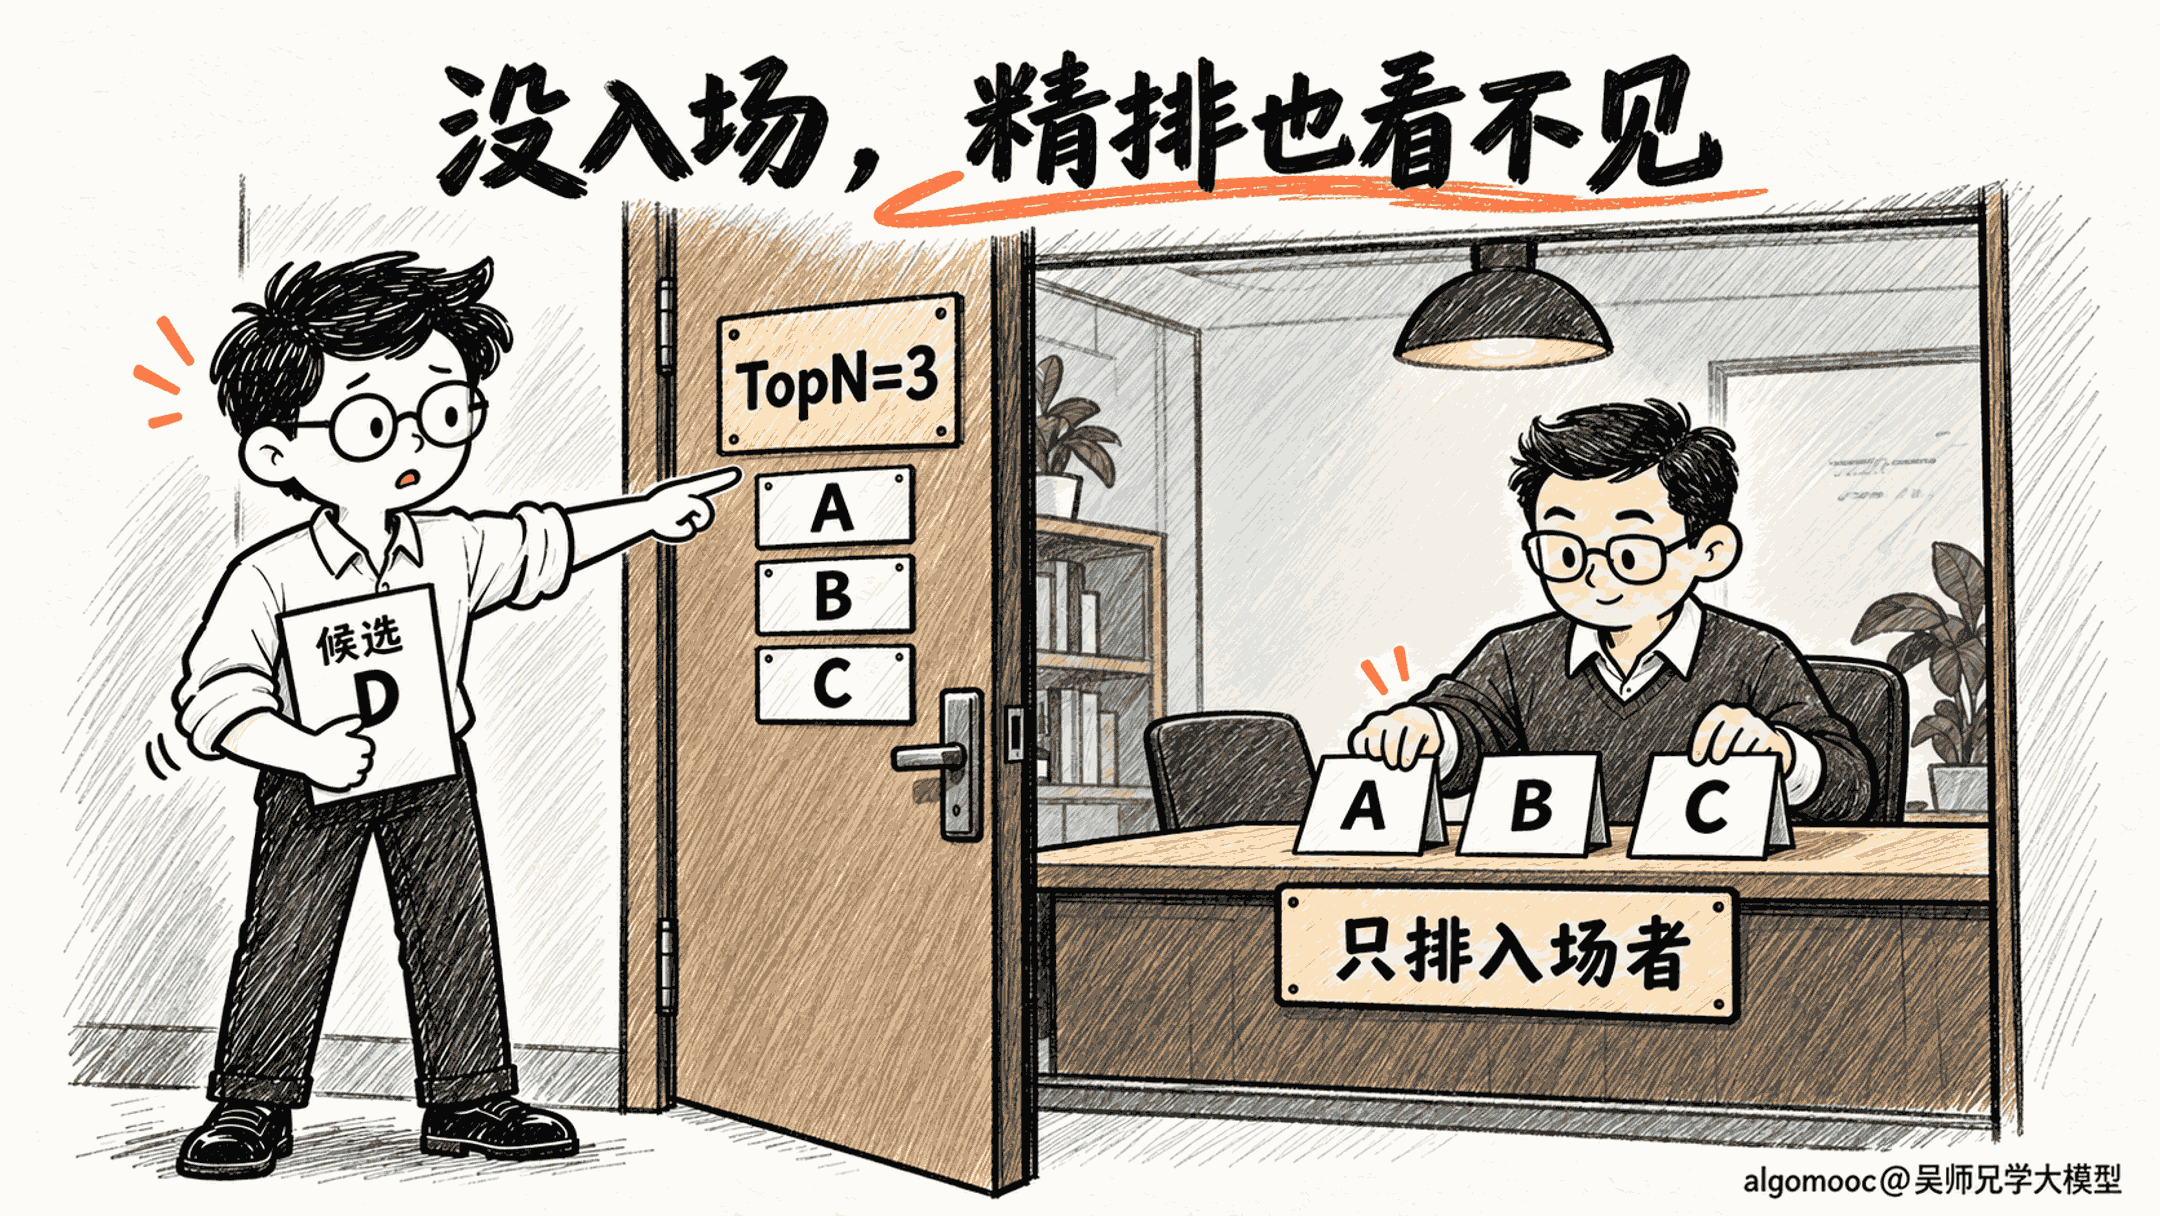
TopN只有三条,D不在可选范围
问题是:“夜间打车报销要先审批吗?”资料中有一句关键规定:“夜间打车报销必须先取得主管审批。”这句话在段落D的尾部,D前面还有通用的资料归档和凭证核对说明。
粗召回名单固定为A、B、C、D、E、F。A讲通用出差申请,B讲市内交通资料,C讲发票与凭证,D才包含目标审批句。这里冻结顺序,是为了先区分候选截断和重排,避免一边改模型,一边把召回结果也换了。
第一种状态,只把前三条交出去。无论怎样调整A、B、C的顺序,D都不会出现在结果里。程序尝试把D写入输出时,候选标识校验直接拒绝:它不属于本次输入名单。
这个校验并不负责判断段落好不好,只守住选择范围。对于只排序、筛选传入候选的重排环节,最终保留的TopK应当是输入TopN的子集。若某个系统还会补搜新资料,那部分是额外的召回能力,应单独记录新增候选来源。
所以,“正确段落已入库”和“这次请求的候选中有正确段落”不能混为一谈。段落可能被过滤条件排除,也可能在粗召回中位于截断位置之后。此时先查它为什么没进入名单,缩小最终K或更换重排器都不会把D补进来。
原课程材料将快速召回与Cross-Encoder重排分成前后两步,也提出扩大候选供重排处理。这个设计给了后者选择空间,同时提醒我们:减少候选量是在改入口范围,不能只把它记为一项省时优化。
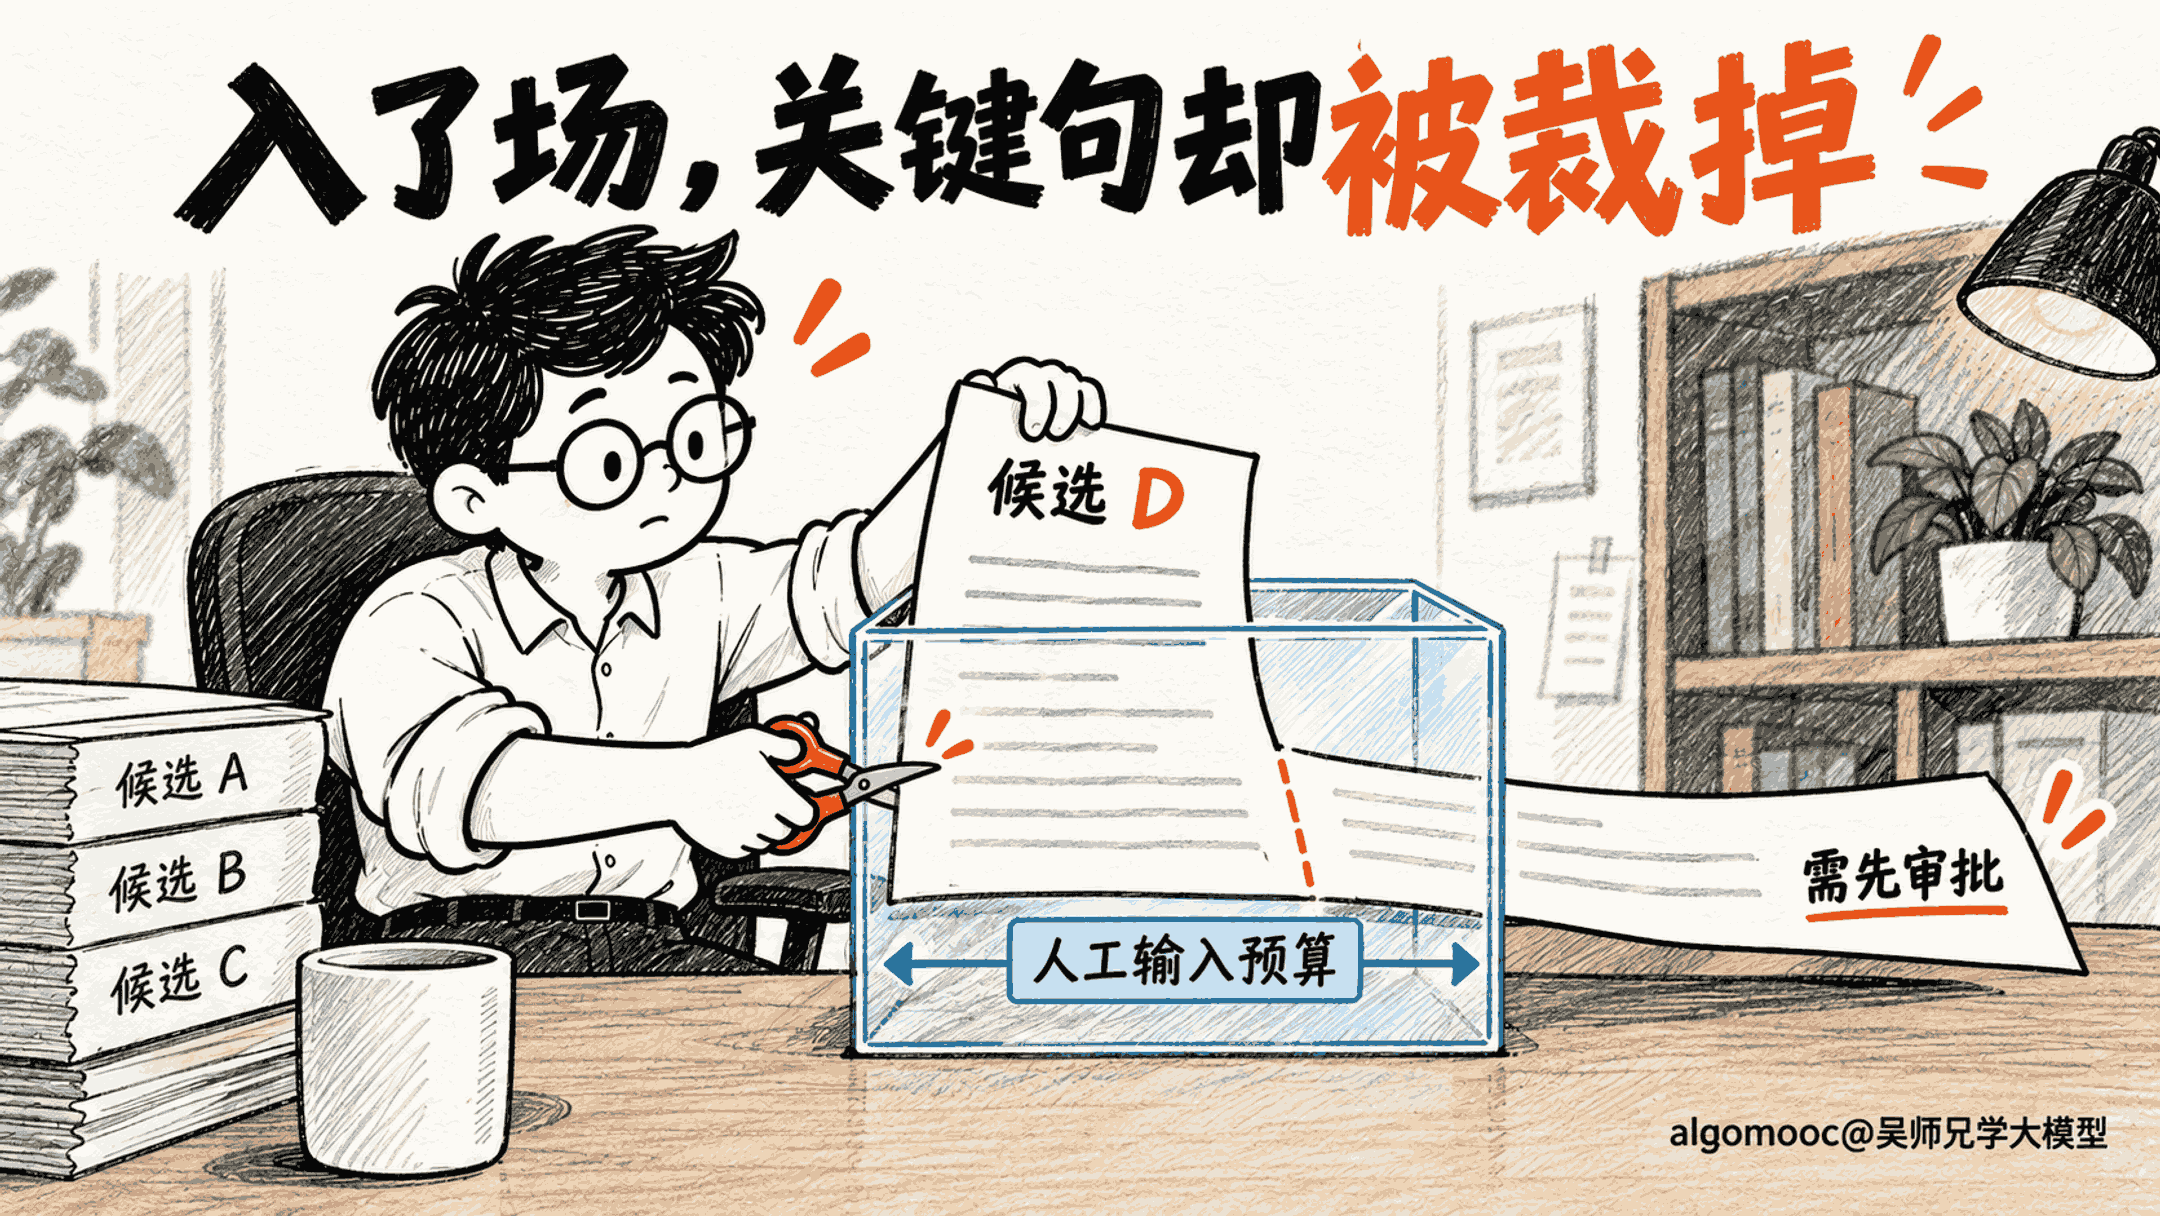
同样四条候选,64字符窗口裁掉尾句
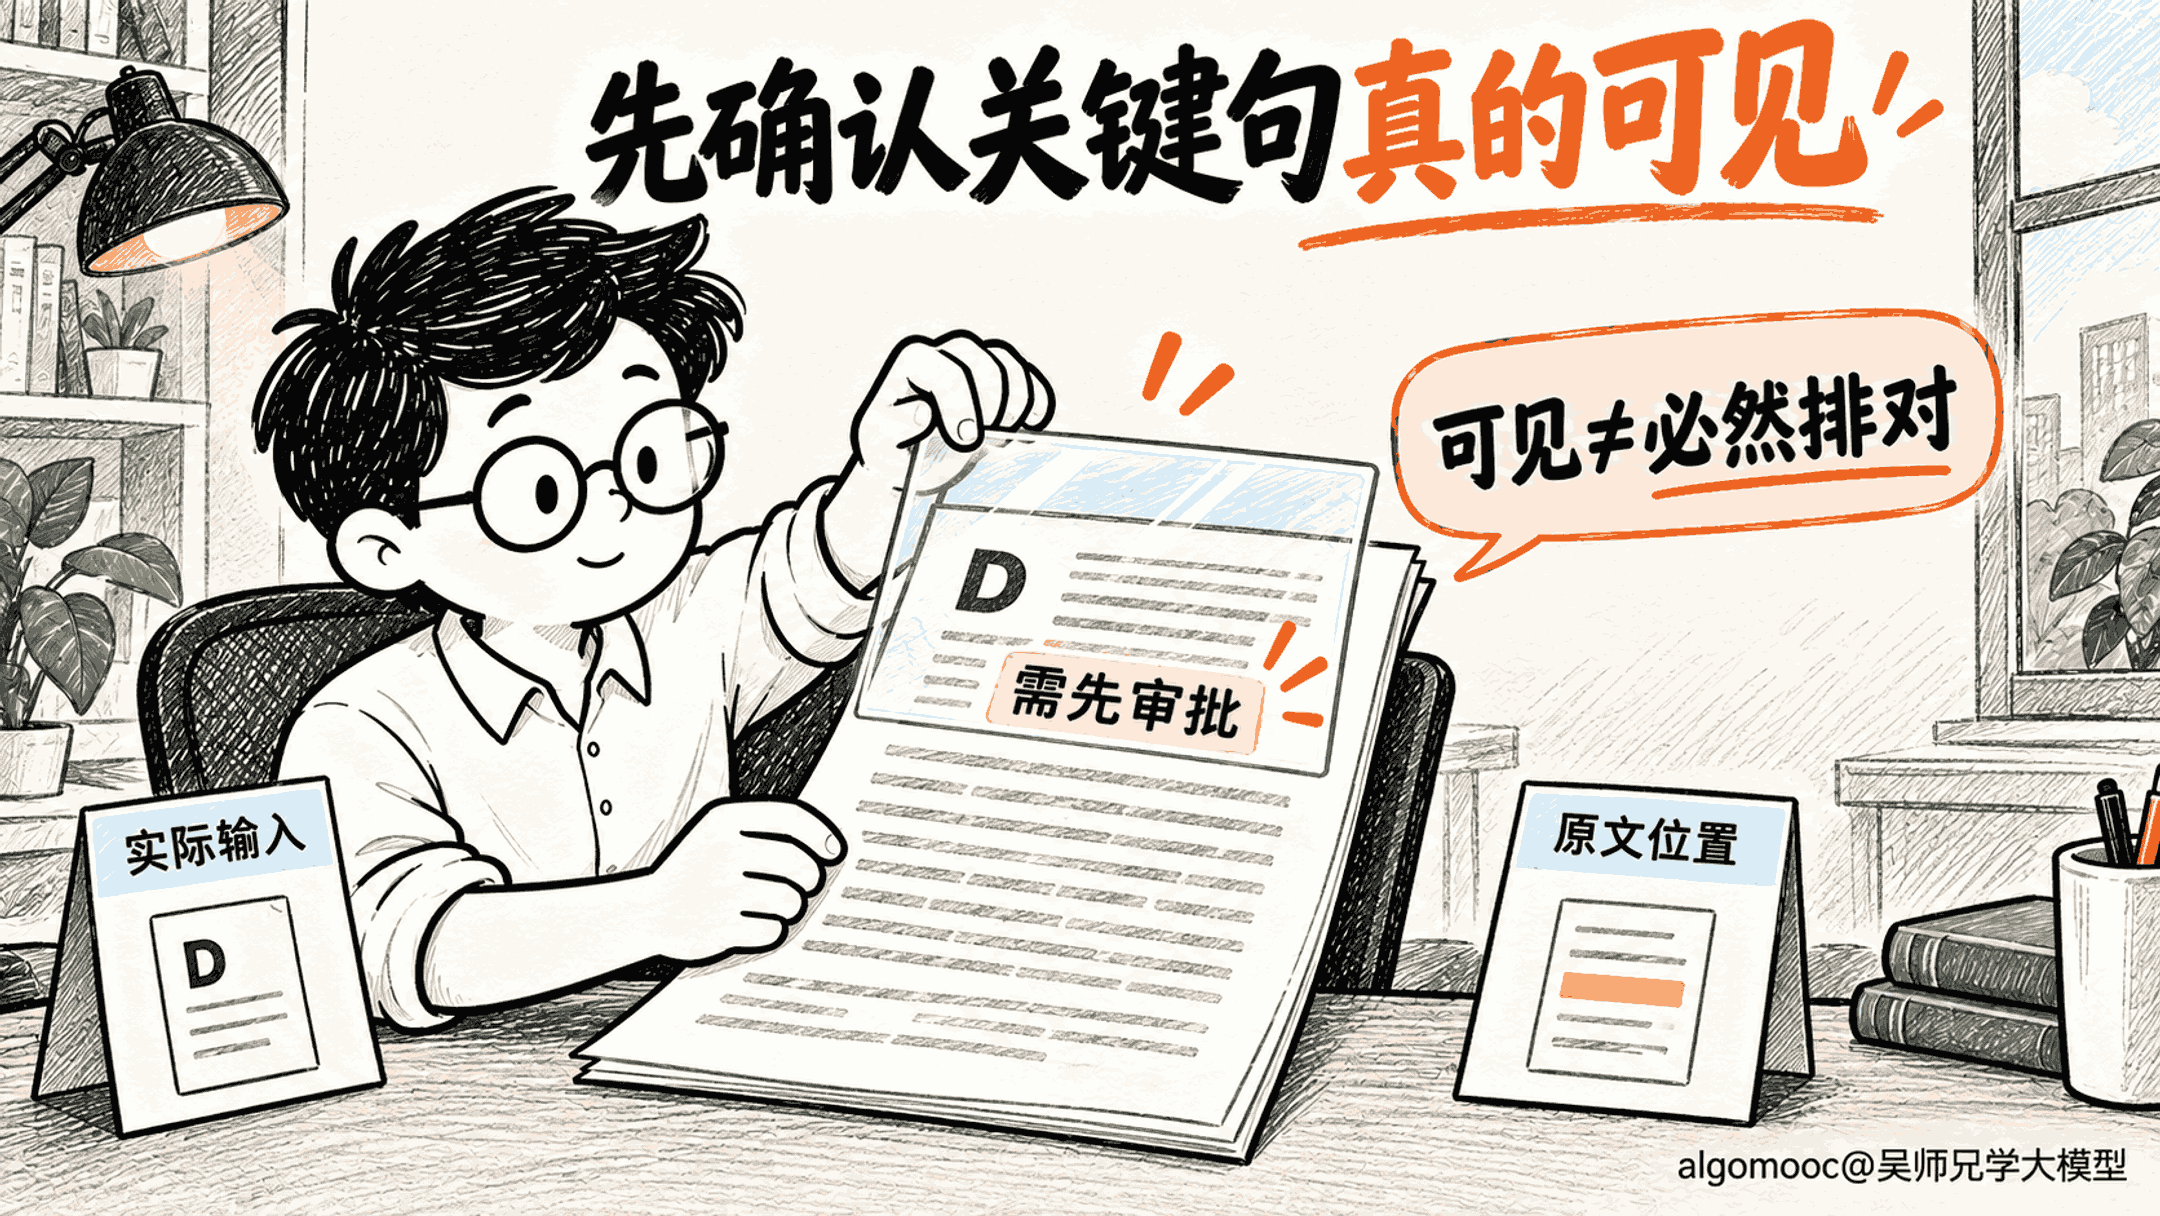
第二种状态把N扩大到四,D终于在名单里了。但名单里有D,还不等于Reranker看到了D的完整信息。标题、问题和正文如何拼接,长度上限作用在哪一侧,都会影响实际输入。
为了把可见性单独拿出来检查,我设置了一个人工字符预算。每对输入由问题、固定分隔符和候选正文组成,上限64个字符;问题与分隔符占17个,留给正文47个。D原文103个字符,审批句的区间记为[87,103),索引从零开始、左闭右开,完全落在保留范围之外。
这一次,D的标识、来源和原始文本都在,拼接后可见的却只有开头归档说明。若只看候选日志,目标已经命中;若打开实际输入,才发现用于判断审批要求的句子没有送进去。问题应先定位到输入,而不能直接解释为模型不懂规定。
第三种状态保持同样的A、B、C、D以及相同原文哈希,只把人工预算扩大到256。D的实际成对文本为120个字符,审批句完整可见。扩大的是上限,不代表每对输入都要填满256个字符。
这组实验使用字符切片,没有运行tokenizer。真实模型的输入长度通常按token计数,问题、候选以及特殊标记如何占用预算,还取决于实际封装。不能把这里的64字符说成64个模型token,也不能由这次尾部裁切推断某个模型一定采取相同策略。