假设你在做设备借用知识库。一页指南分成两栏:左栏是办理步骤,依次提交申请、审核通过后领取、用完归还;右栏是申请材料,列着工号证明、审批记录和设备清单。
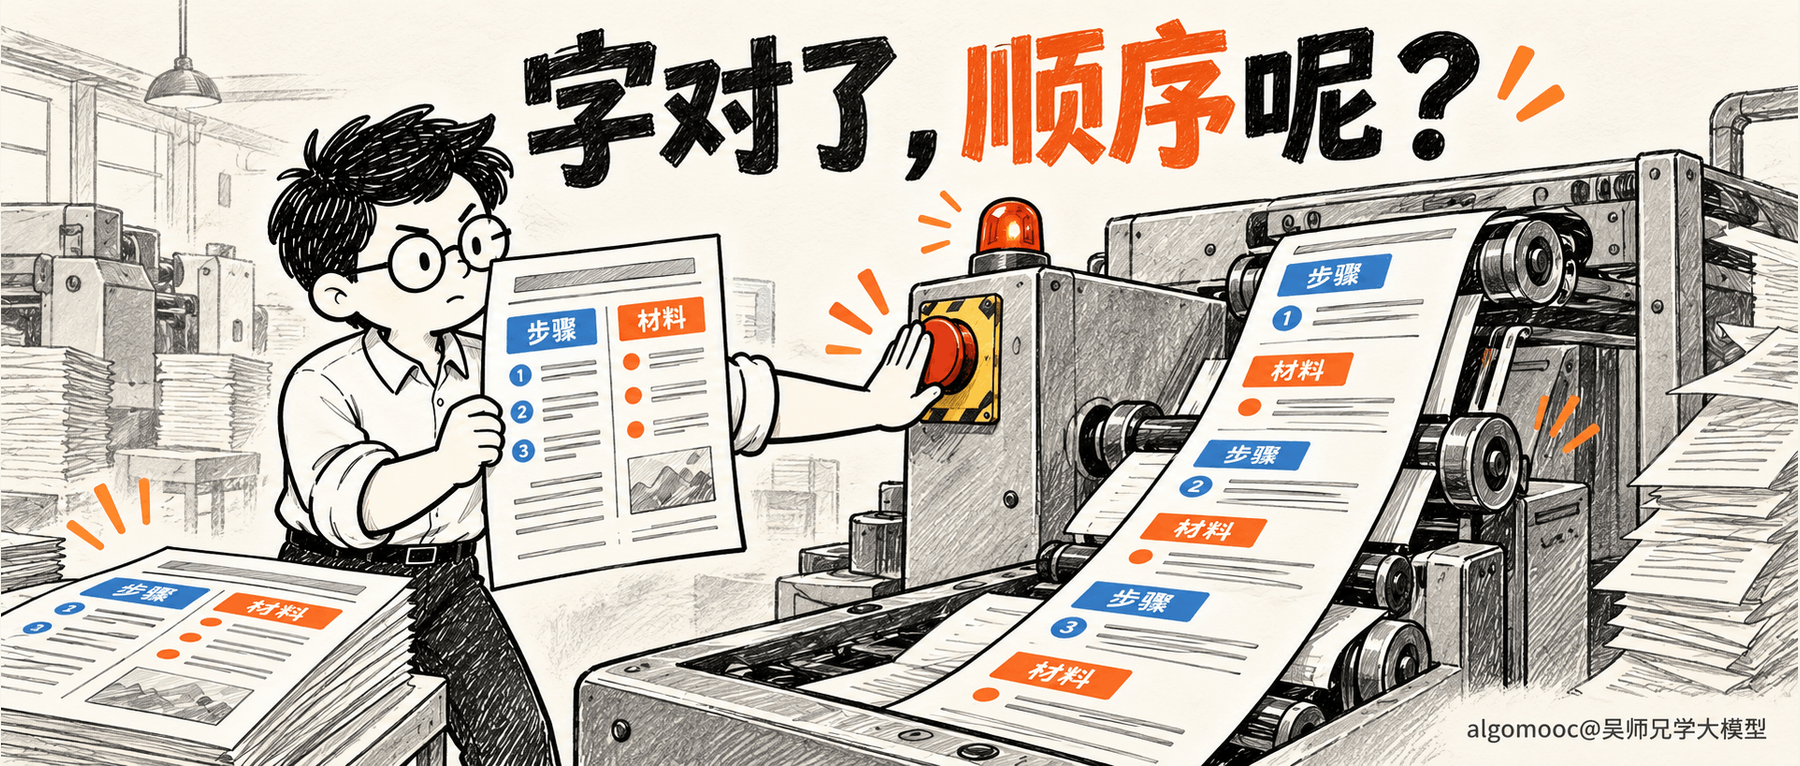
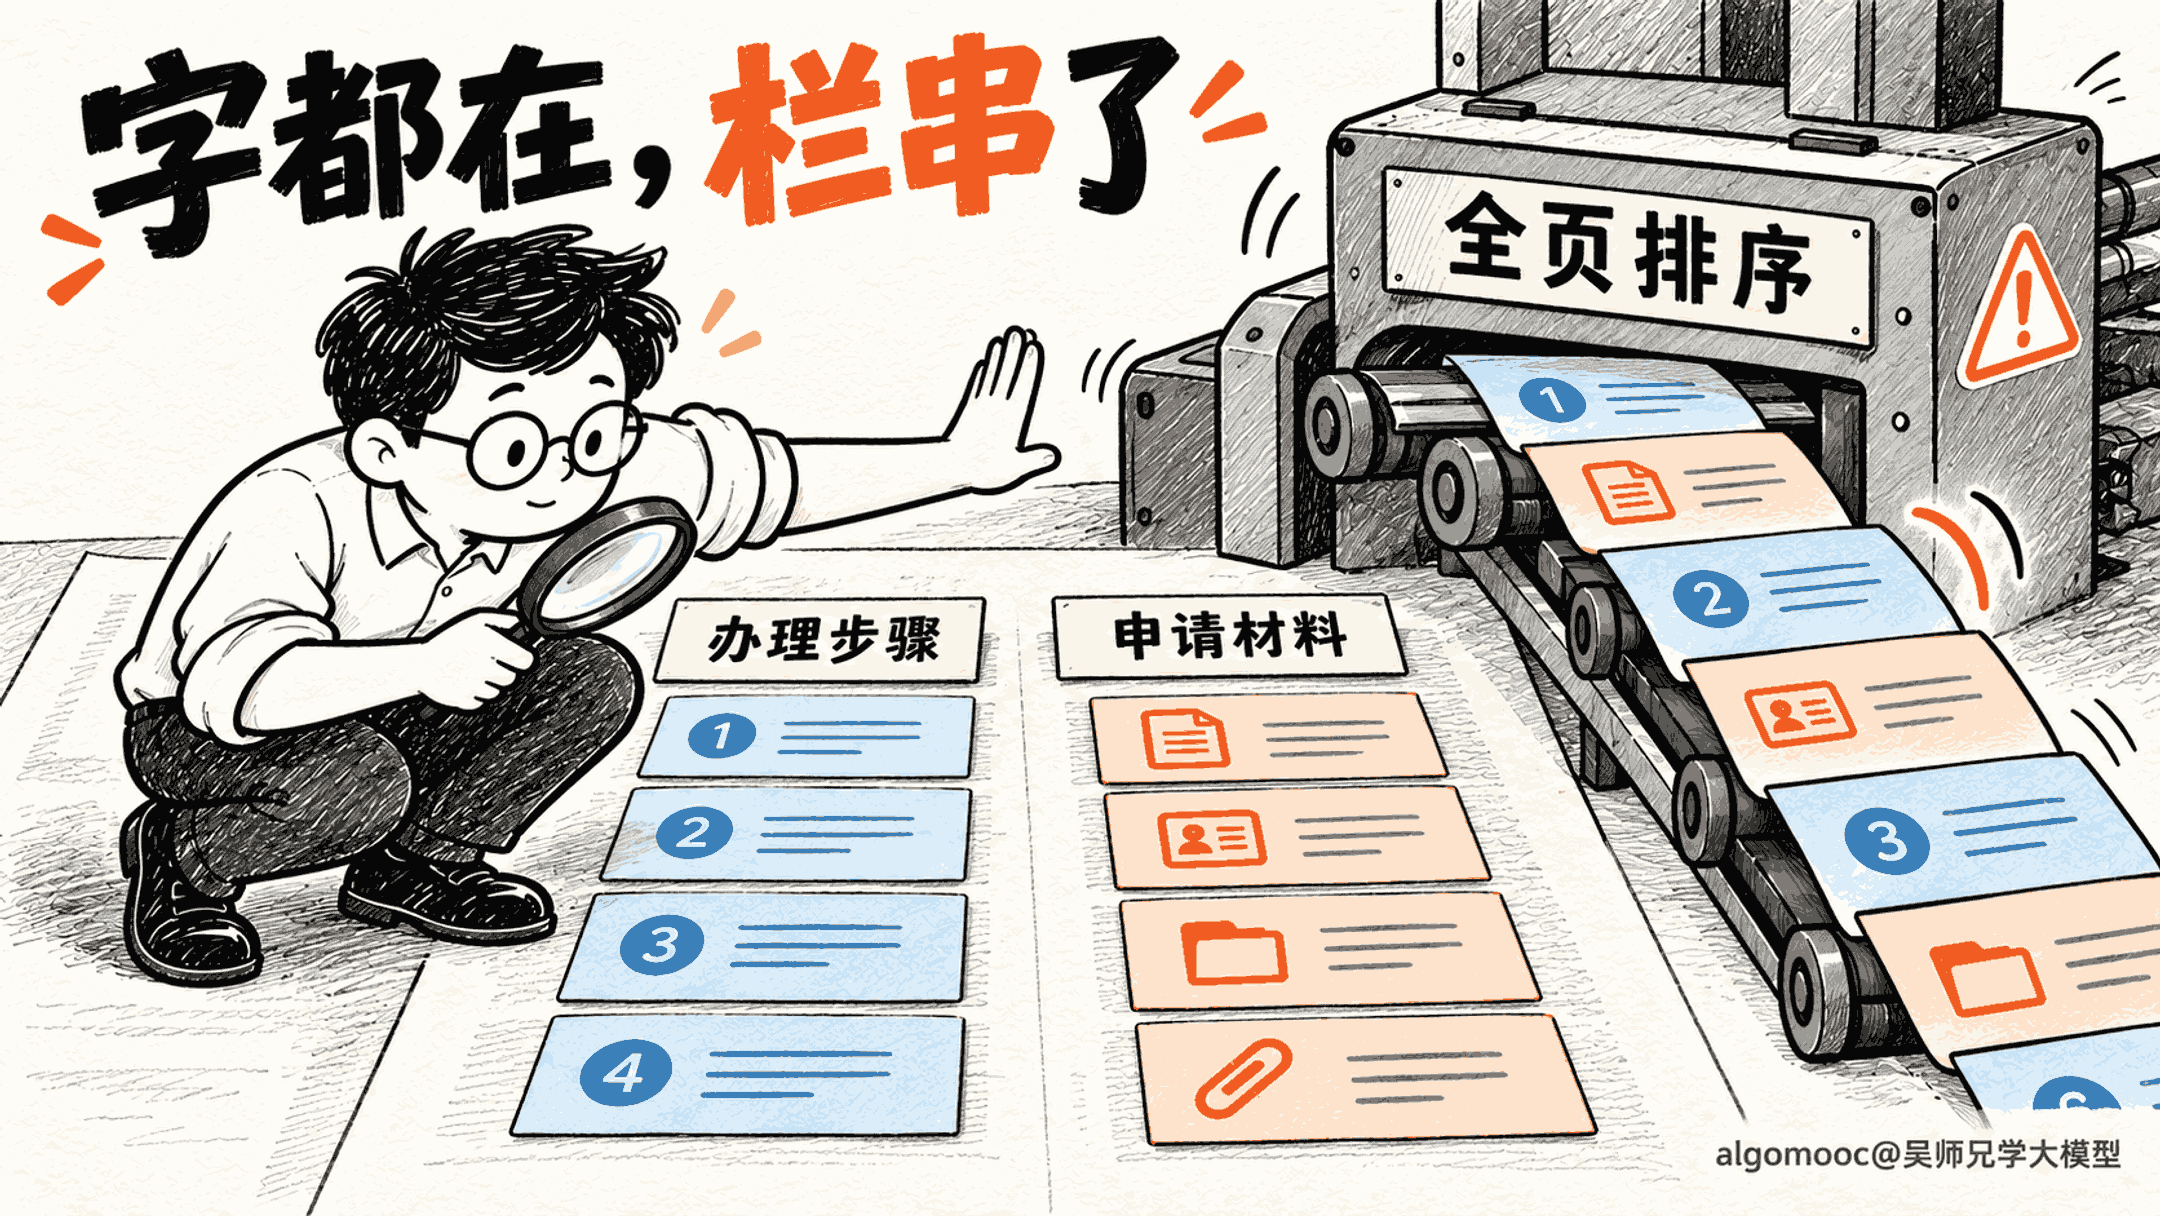
人读这页纸,通常会先沿左栏把流程看完,再去右栏找材料。解析后的文本却可能变成“提交借用申请、工号证明、审核通过后领取设备、审批记录、用完后办理归还、设备清单”。
每个字都能在原页找到,内容也与设备借用高度相关。办理动作和申请材料已经混成一条队伍。把它切成段落送进知识库,后面的模型就得面对一份关系错位的输入。
排查这类问题,我会先看文字是怎样排起来的。识别出了什么,按什么顺序组织,以及组织以后属于哪个栏目,是三个不同的问题。只抽检几个字,无法检查它们之间的关系。
九个块都在,流程仍然可以串栏
为了看清这件事,我把这页指南简化成九个区域块:一个跨两栏的总标题、两个栏目标题,以及两边各三块正文。文字、区域类型和矩形坐标都直接给定,只比较排序过程。
坐标原点放在页面左上角,向下时纵坐标增加。左右栏目标题处于同一高度,左右第一块正文也处于同一高度,后两行照此安排。页面中间留着清楚的栏间空白。
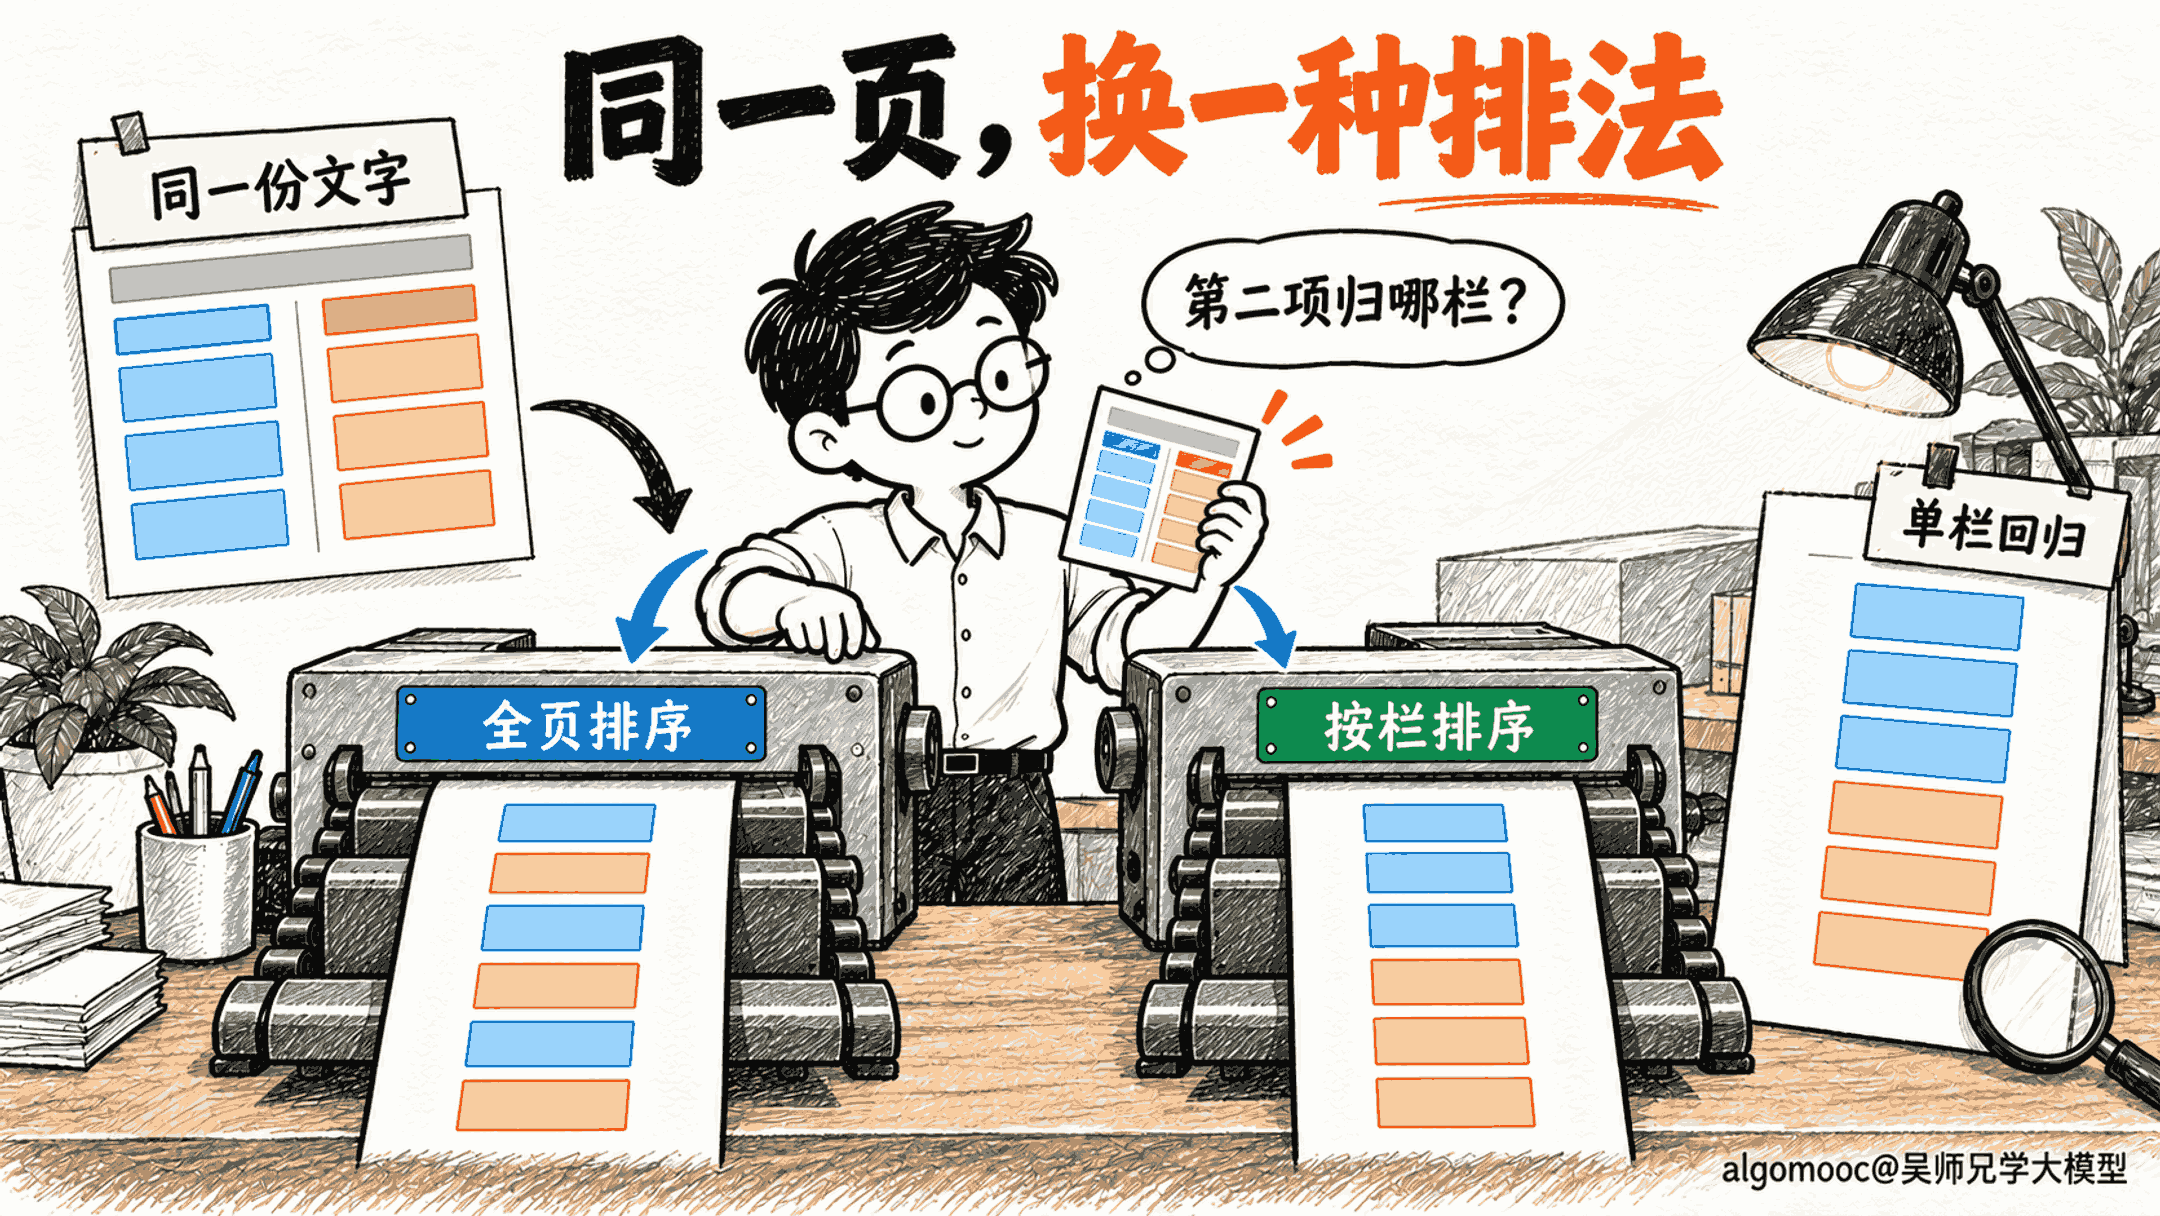
第一种排法很直接:所有块先按纵坐标排,纵坐标相同时再按横坐标排。它得到的开头是总标题、办理步骤、申请材料,然后左右正文交替出现。
麻烦发生在两个栏目标题这里。如果后处理沿着这条序列组织章节,遇到标题就开启新栏目,那么“办理步骤”刚出现,马上就被“申请材料”接替。随后六块正文全被装进材料栏目,步骤栏目反而空了。
第二种排法先取出顶部跨栏标题,再按已知栏界分开左右区域。左栏内部从上到下排完,接着处理右栏。这样得到的栏目关系,才与这页指南的预期一致。
两种排法用的都是同一批文字和坐标,九块内容也全部保留。区别出在块的先后,以及标题对后续内容的管辖关系。字符完整的检查,两种方案都能通过;栏目归属的检查,结果却不同。
我还按栏目做了两个确定性查询:“办理步骤的第二项是什么”“借用需要准备哪些材料”。全页排序后,步骤栏目取不到第二项,材料栏目混入了三个动作。按栏排序后,第二项是审核通过后领取设备,材料栏目只包含那三项材料。
这里没有让模型回答,也没有运行文字识别。九块文字本来就正确,查询只是读取组装后的栏目。把这些变量固定,才能看清错误是否由排序引入,避免把原因笼统归到模型理解能力上。
先判断区域关系,再决定谁排在谁前面
这个小例子容易让人得到另一个过快的结论:以后都先读左边,再读右边。实际页面没有这么统一。
有些双栏是两段独立正文,适合读完一栏再读另一栏;有些左右排列的是问题与解释,应该逐行配对。表格里的列关系也不能套用正文栏位的顺序。页面看起来像两栏,不等于它们承担同一种关系。
在设备借用指南里,左边有“办理步骤”,右边有“申请材料”,两个标题分别统领下方内容。栏间空白、区域范围和标题位置共同支持这种划分。排序程序需要先知道正在处理的是两个栏目,而非一张左右对应的表。
所以我会把版面恢复拆成两件事:先形成可解释的区域,再建立区域之间的阅读关系。区域内部可以利用纵向位置,但全页不能只靠一个坐标排序完成。
总标题也要单独处理。它横跨两栏,说明的是整页内容,把它硬塞进左栏,会让右栏失去共同的上级主题。两个栏目标题则分别属于自己的栏,不能因为处在同一高度,就连续写成两个互相接替的标题。