做了两路召回,一路用BM25找字面匹配,一路用向量找语义相近。接下来怎么排?你可能会写下一个很自然的公式:BM25占一半,向量占一半,两路分数加起来,取前几名。
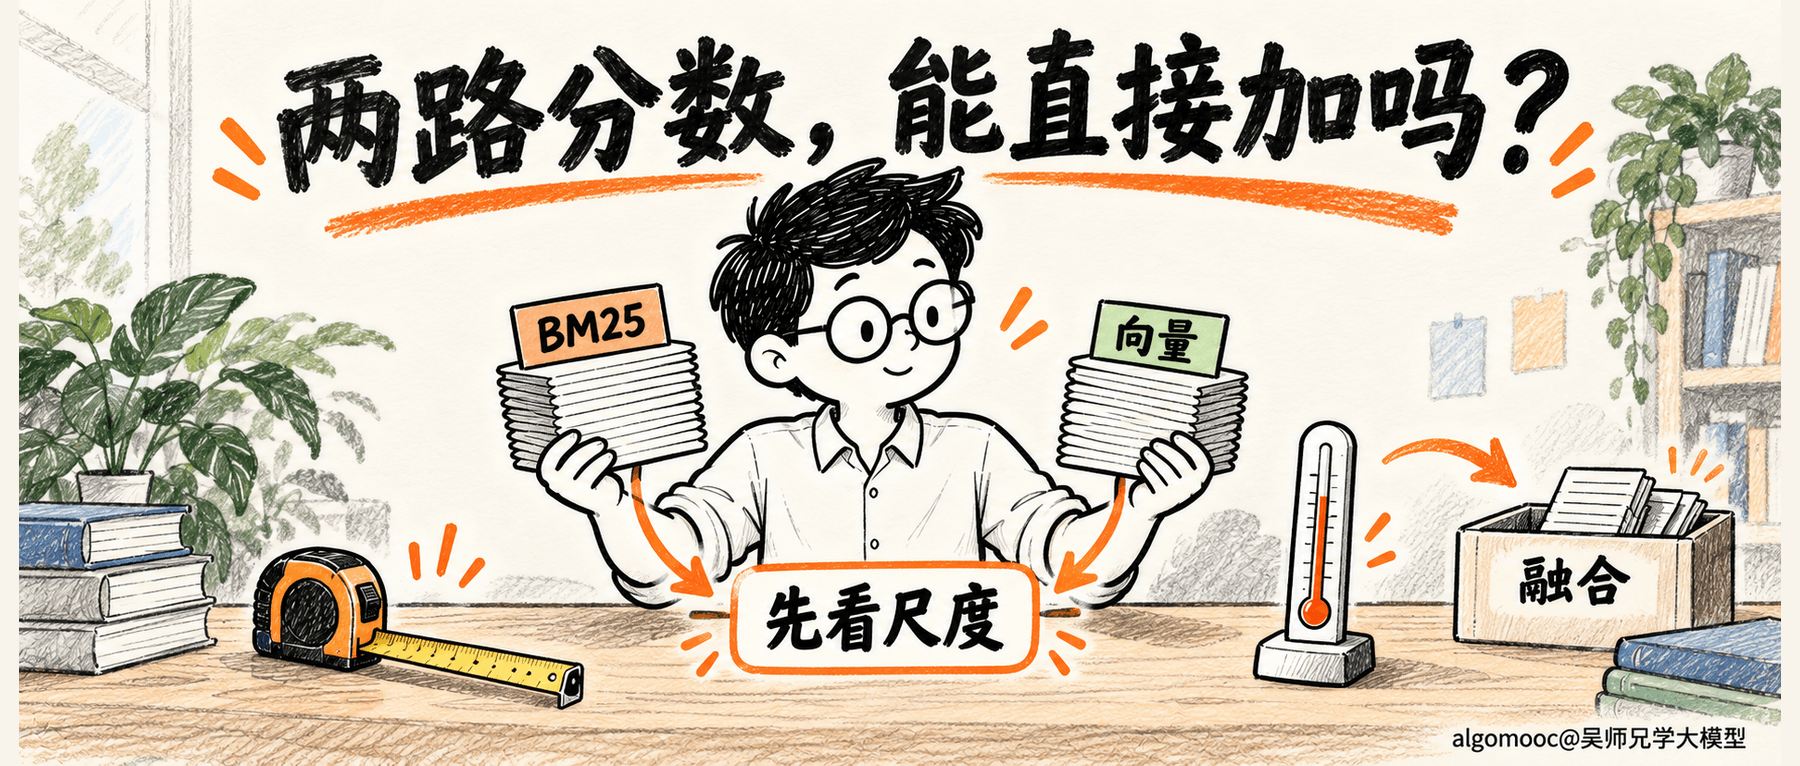
面试官追问:“为什么各占一半?”你说希望兼顾关键词和语义。再追问:“BM25给50分,向量给0.9分,这两个一半,实际贡献一样吗?”这时,权重选择还没开始,分数可比性就已经成了问题。
它像两个裁判,一个拿米尺,一个拿温度计。工具读数都能写成数字,但不能因为各乘0.5,就认为可以放到同一张成绩单上。检索分数当然不是米或摄氏度,这个类比强调的是:不同机制产生的数值,缺少天然统一的解释。
训练营企业级RAG项目把混合召回列在检索链路中。要把这一步讲清楚,先不用搬出很长的架构图。固定两张候选名单,改一次分数尺度,就能看见直接相加到底依赖什么。
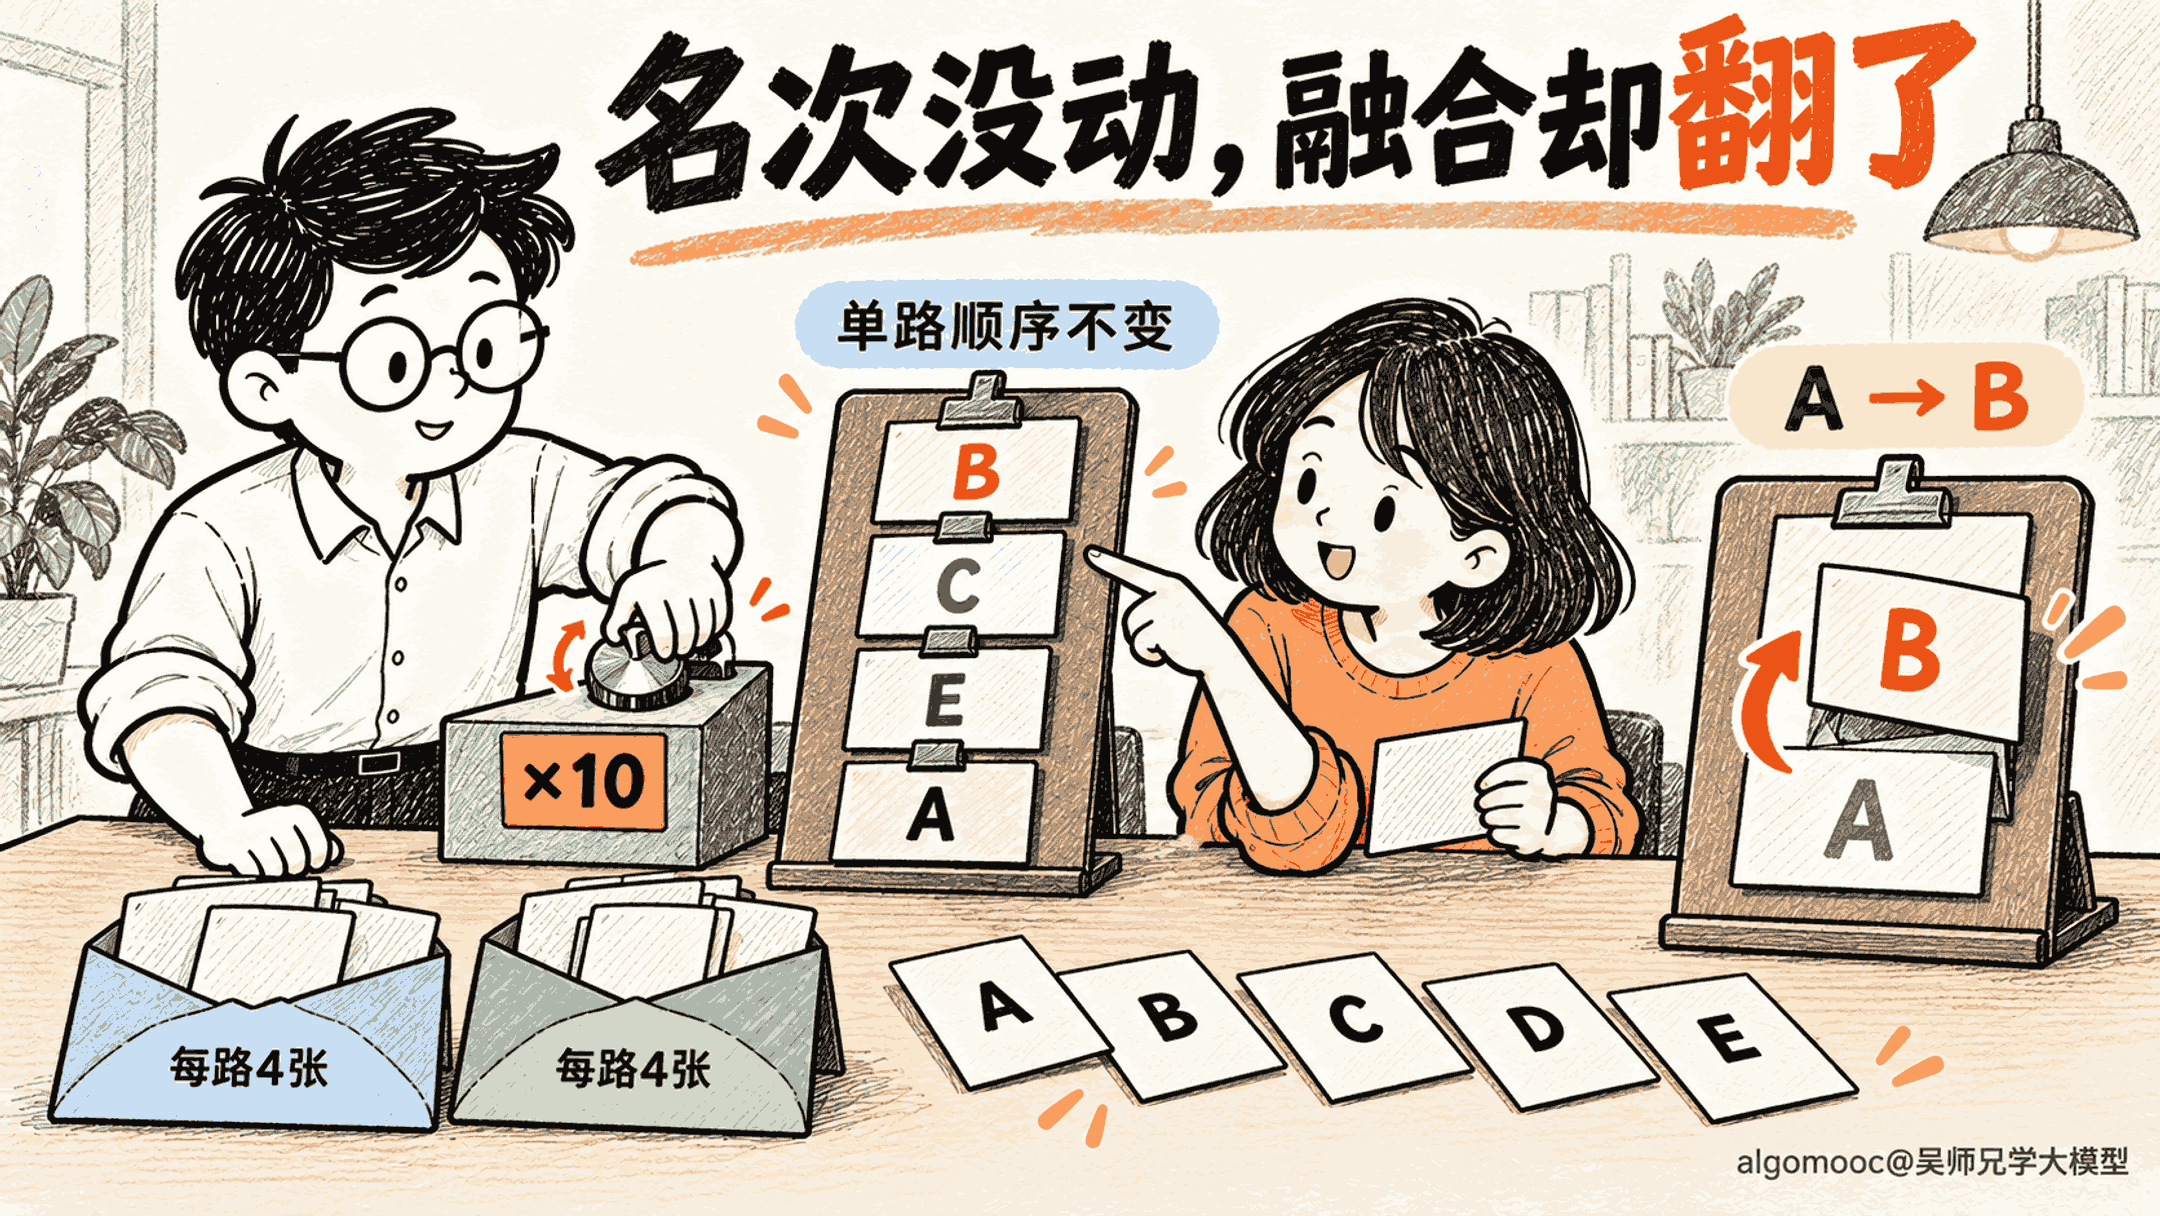
把向量分数乘十,第一名换了
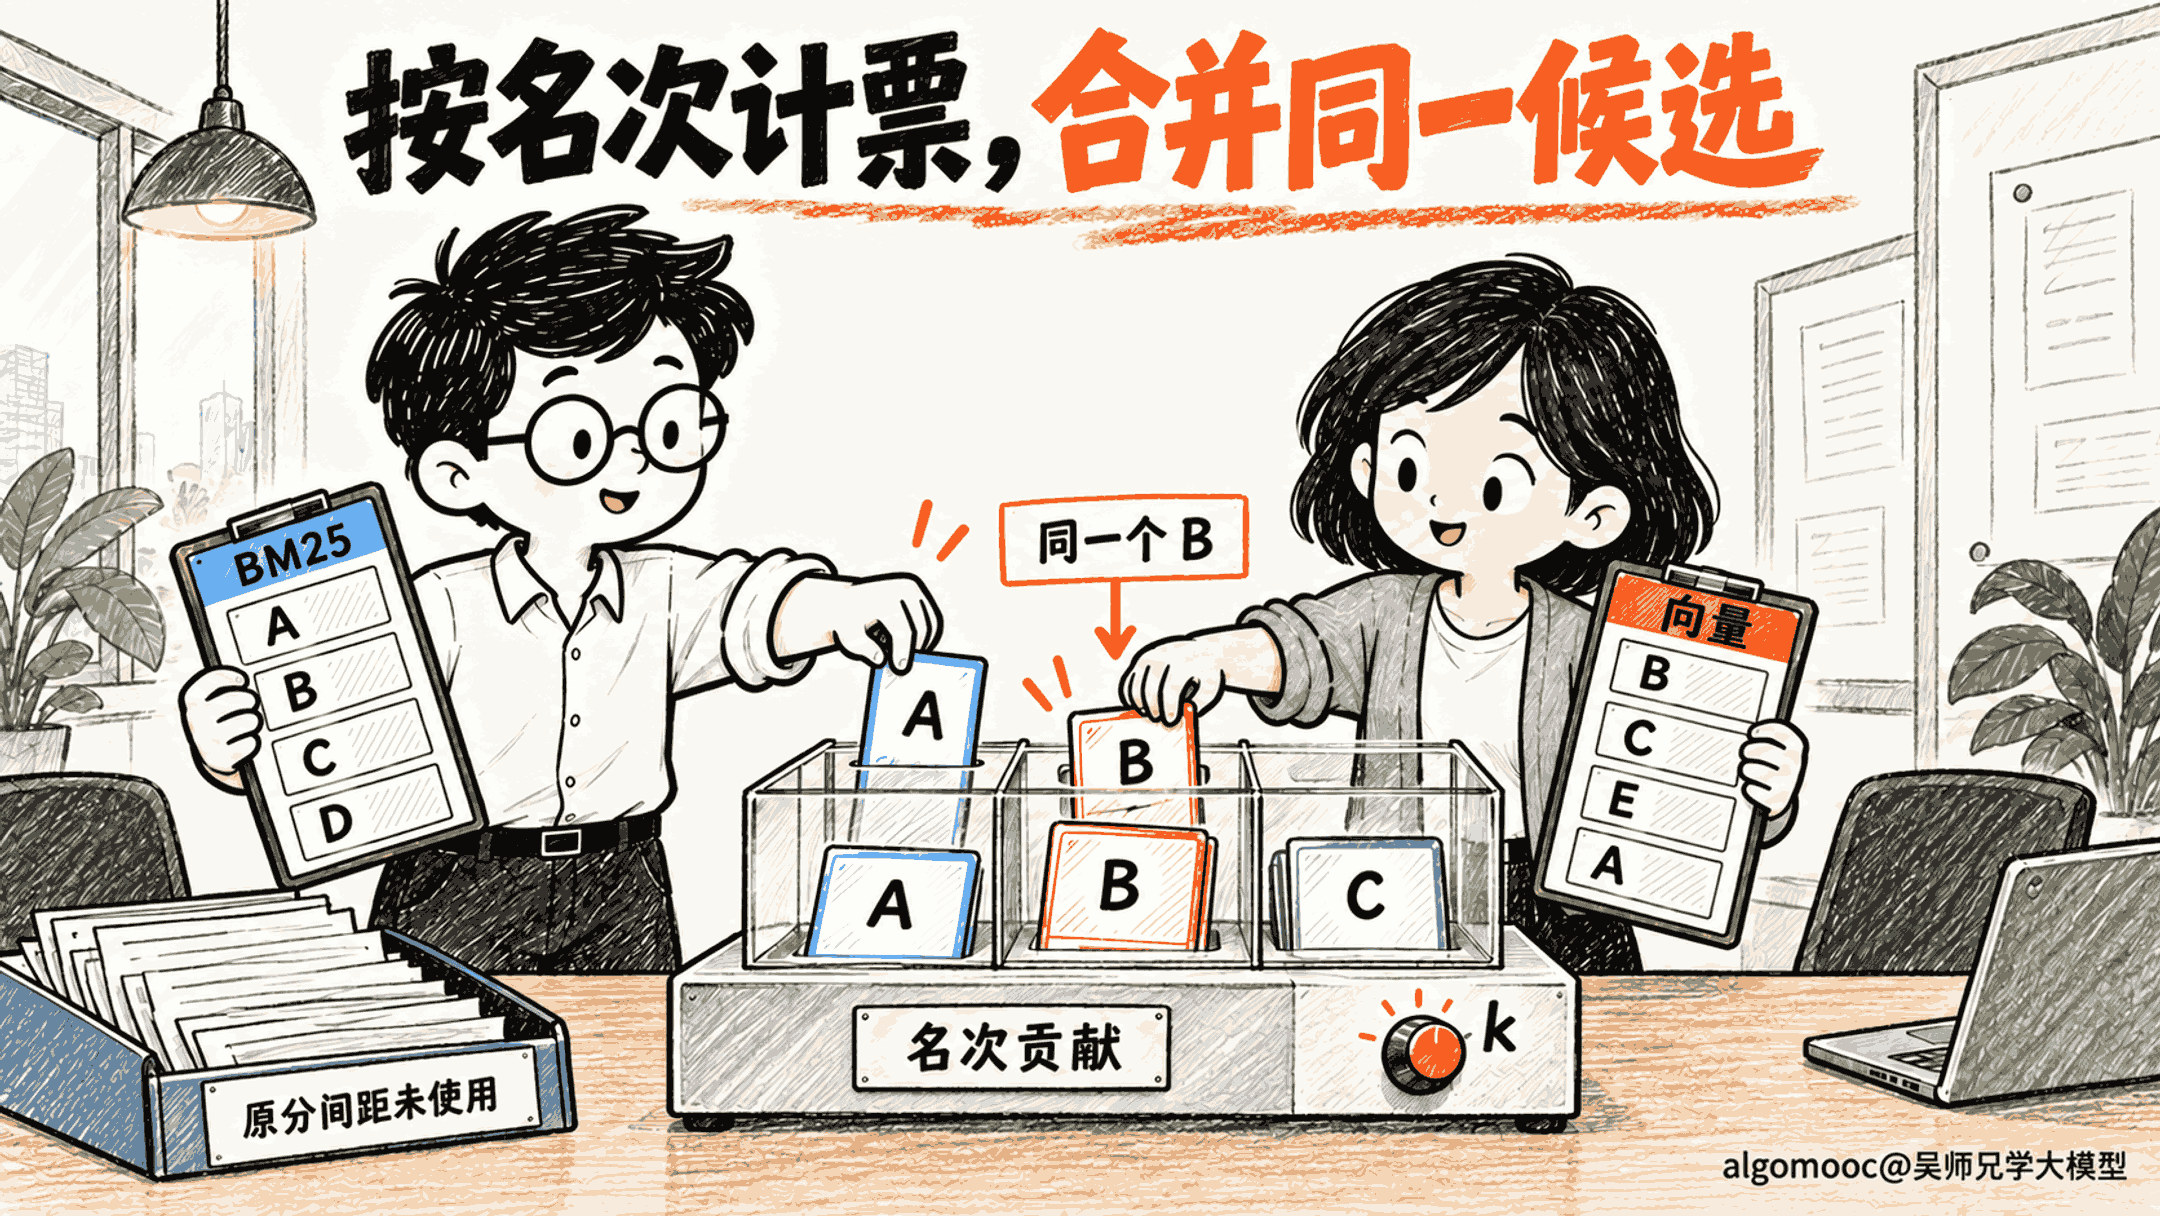
我做了一组人工候选。BM25一路依次是A、B、C、D,分数分别为50、49、2、1;向量一路依次是B、C、E、A,分数分别为0.95、0.90、0.60、0.50。这些顺序和数字都是手工给定,用来检查融合运算。
每路只取去重后的四条,同一个候选用统一标识合并,两路并集是A到E共五条,最后输出前三条。同路重复出现的候选只保留最高分,不让一条内容在同一路重复投票。所有方法接收完全相同的两张名单。
直接等权相加时,A得到25.25,B得到24.975,A排在前面。BM25里两者相差1分,乘一半以后相差0.5;向量里B领先0.45,乘一半后只追回0.225。公式写着各一半,数值尺度却让前一路的差距占了上风。
接着只做一个改动:把向量路的全部输出分数乘十。B仍然排第一,C仍然排第二,E和A的位置也没变;BM25一路完全不动。没有加入新候选,也没有让某条证据变得更相关。
融合结果却翻了过来。A变成27.5,B变成29.25,第一名换成B。这个改动只改变一路分数的数值表示,直接相加的排名就随之改变。它说明当前公式依赖分数尺度,不能单凭“权重都是0.5”解释两路贡献。
这里把分数乘十,是一个受控探针,不是重新计算余弦相似度。真实引擎返回的是相似度还是距离、是否越大越好,都要先确认。连排序方向都没有对齐时,加权结果更谈不上可解释。
当然,也可以缩小向量路的权重,抵消这次放大。但这恰好说明,原始权重与分数尺度绑在一起。脱离分数定义,单独说“关键词占七成,语义占三成”,并没有交代实际偏好。更换模型或改了打分接口后,即使权重文件没动,融合行为也可能需要重新检查。
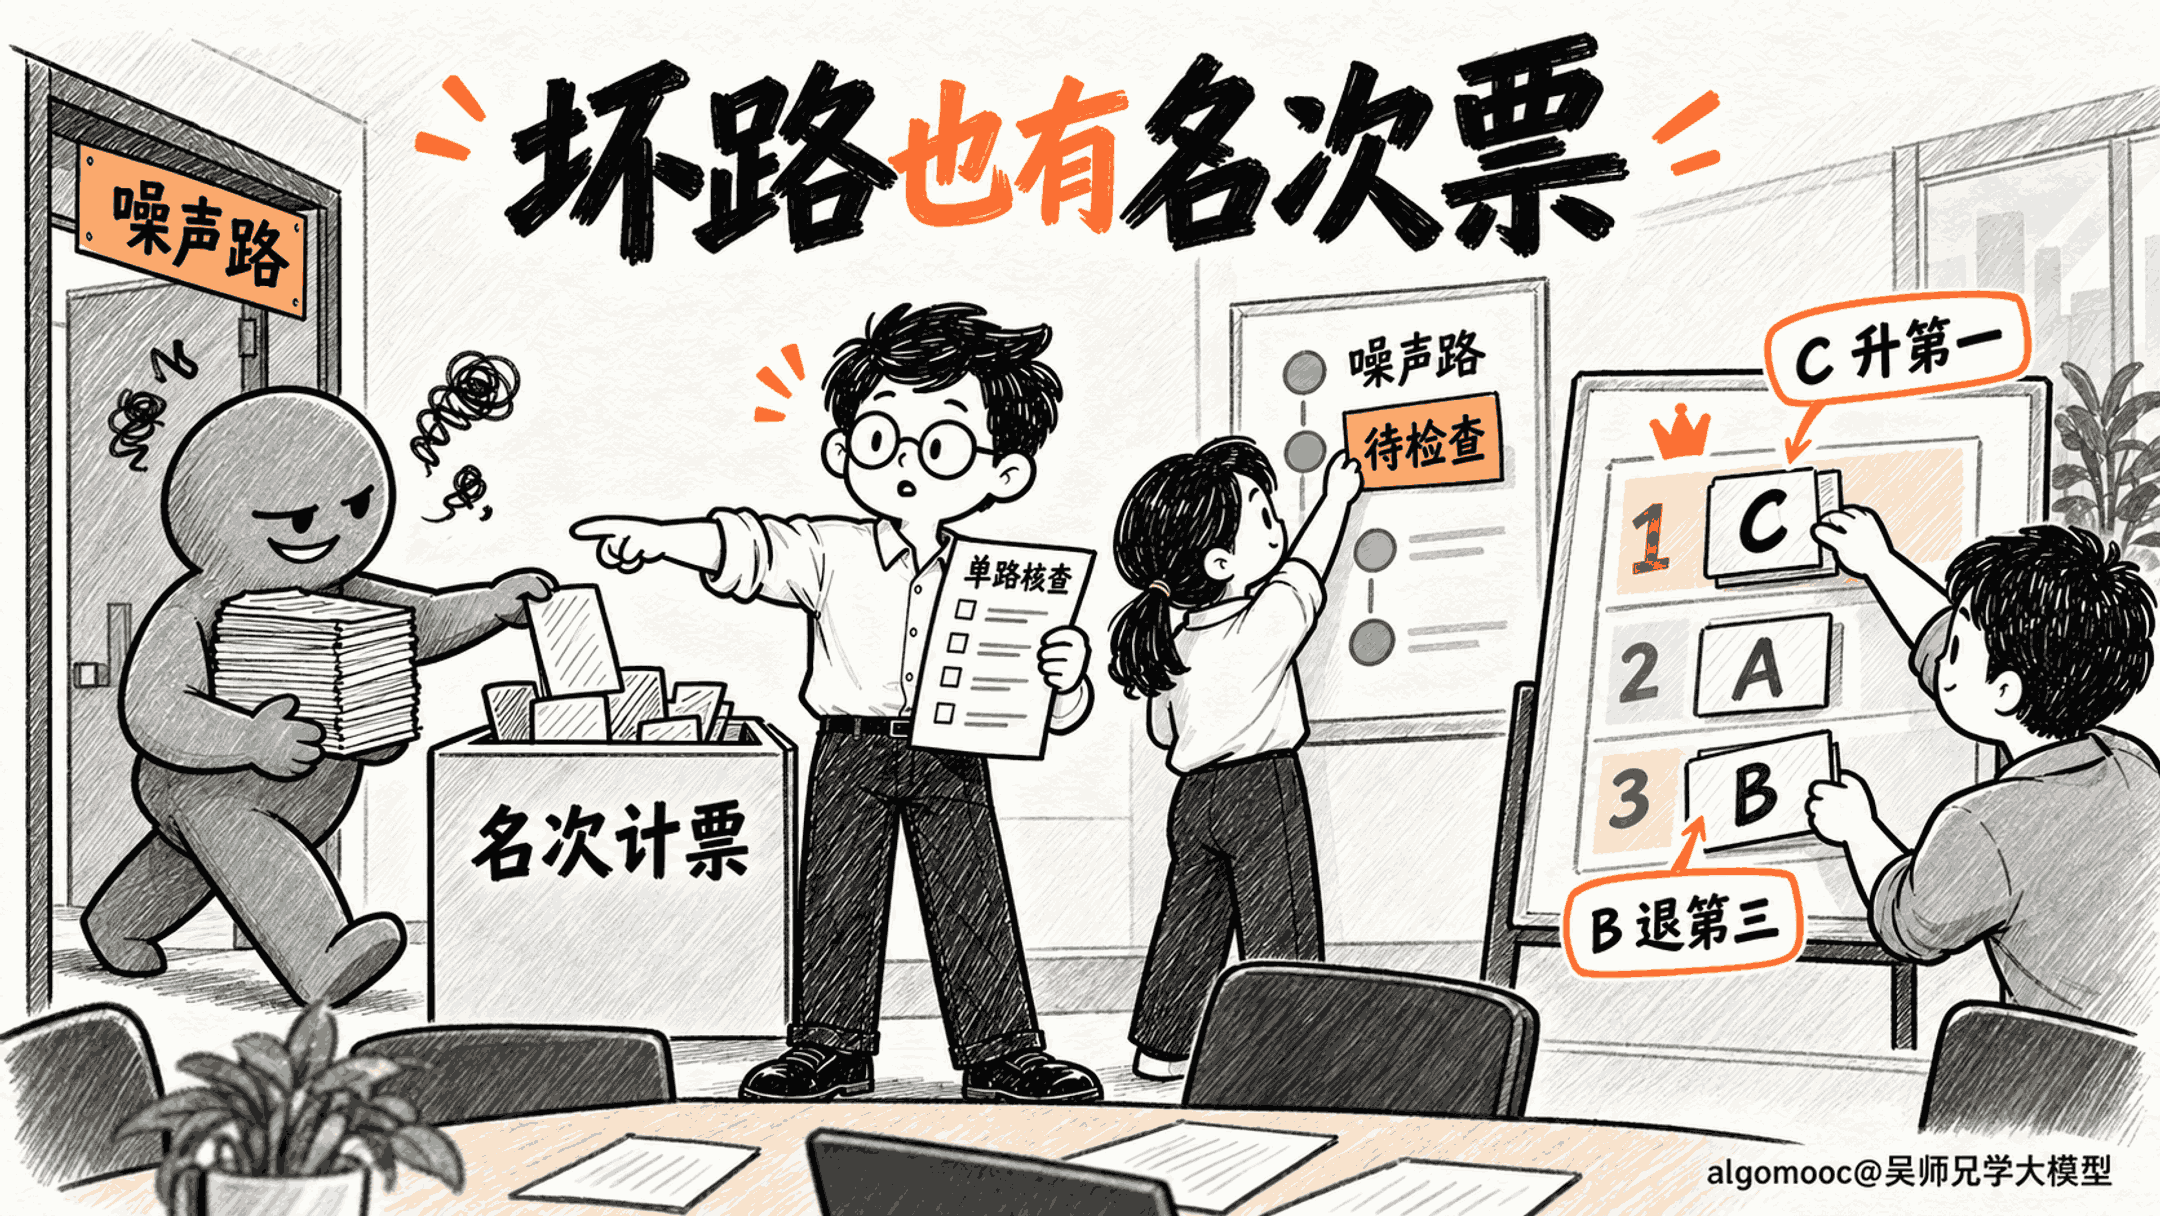
压到同一区间,还没校准相关性
一个容易实现的处理,是分别在各路当前候选里做Min-Max:减去本路最小值,再除以最大值与最小值的差。这样,每路最低分变成0,最高分变成1,然后再按相同权重相加。
在这组输入中,B的BM25归一化分接近0.98,向量归一化分为1,融合后排第一。把向量原分乘十后,最大值、最小值和差值同时放大,归一化结果保持不变,融合排名也保持不变。脚本检查了所有候选的融合分,不只检查第一名。
这解决了本次正比例缩放带来的变化,却没有证明两个0.8代表同样的相关性。Min-Max只是把当前列表的端点对齐。某一路的第一名即使很差,也会得到1;另一路即使整体都不错,最后一名仍会得到0。