上一篇结尾说这篇讲"为什么不是 PPO"。动笔之前,我先去翻了训练营一直在更新的那份面试真题库。
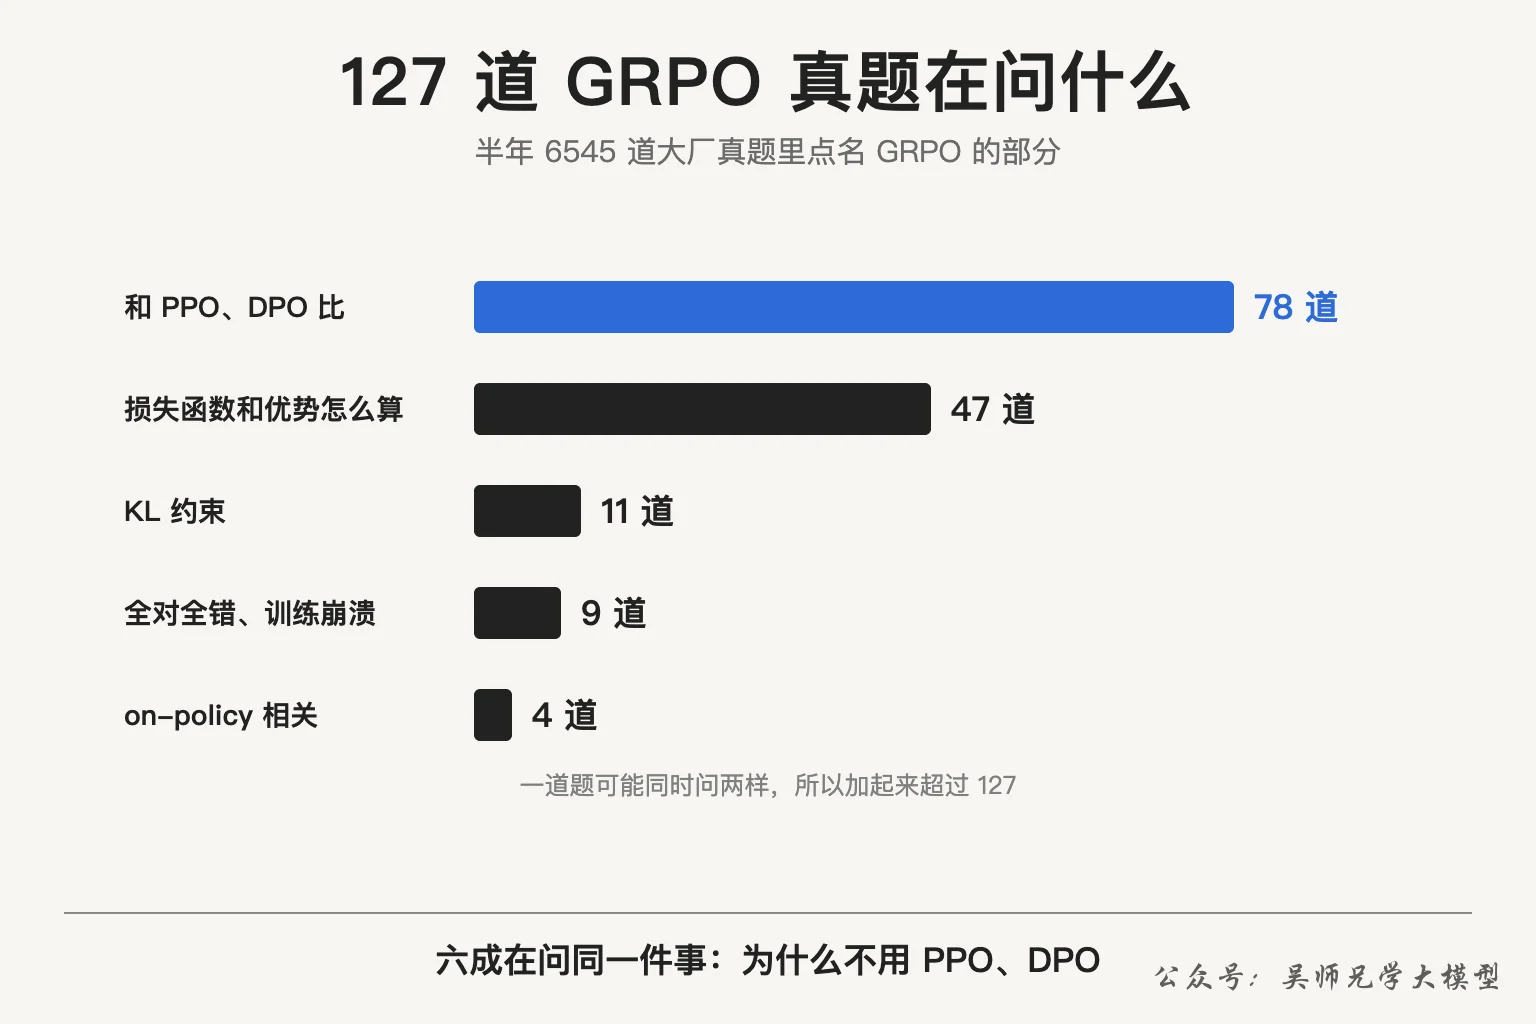
半年的题,一共 6545 道。点名 GRPO 的有 127 道,百度、美团、快手、字节问得最多。
这 127 道里,有 78 道在问同一件事:拿 GRPO 和 PPO 或者 DPO 比。
剩下的问法也很集中,损失函数和优势怎么算的 47 道,KL 约束 11 道,全对全错和训练崩溃 9 道。有些题一道里问了两样。
你简历上要是有这么一行,这些题基本都会落到你头上:
售后操作智能体 Agentic RL 后训练|GRPO 后训练:K=4 组内优势 + 崩塌熔断,任务成功率 8% → 93%(pass@1,reward ≥ 0.9)
我看下来,大家的问题出在准备的方向上。备的是算法对比,PPO 有 critic,GRPO 没有,背得很熟。面试官顺着往下问的是项目:你为什么这么选,代价是什么,训崩了你怎么知道。
我从里面挑了六道,你面试的时候大概也是按这个顺序被问到。示范答法用的是第一人称,是站在做过这个项目的同学的角度写的;其余地方说"我"的,都是我吴师兄。
一、GRPO 相比 PPO 改进了什么,为什么选它?
请分析 GRPO 相比 PPO 在哪些方面有所改进,解决了 PPO 的哪些局限性。(同花顺)
GRPO 与 PPO 的核心思想有何不同?在实际训练中为何某些场景下更倾向于使用 GRPO?(腾讯)
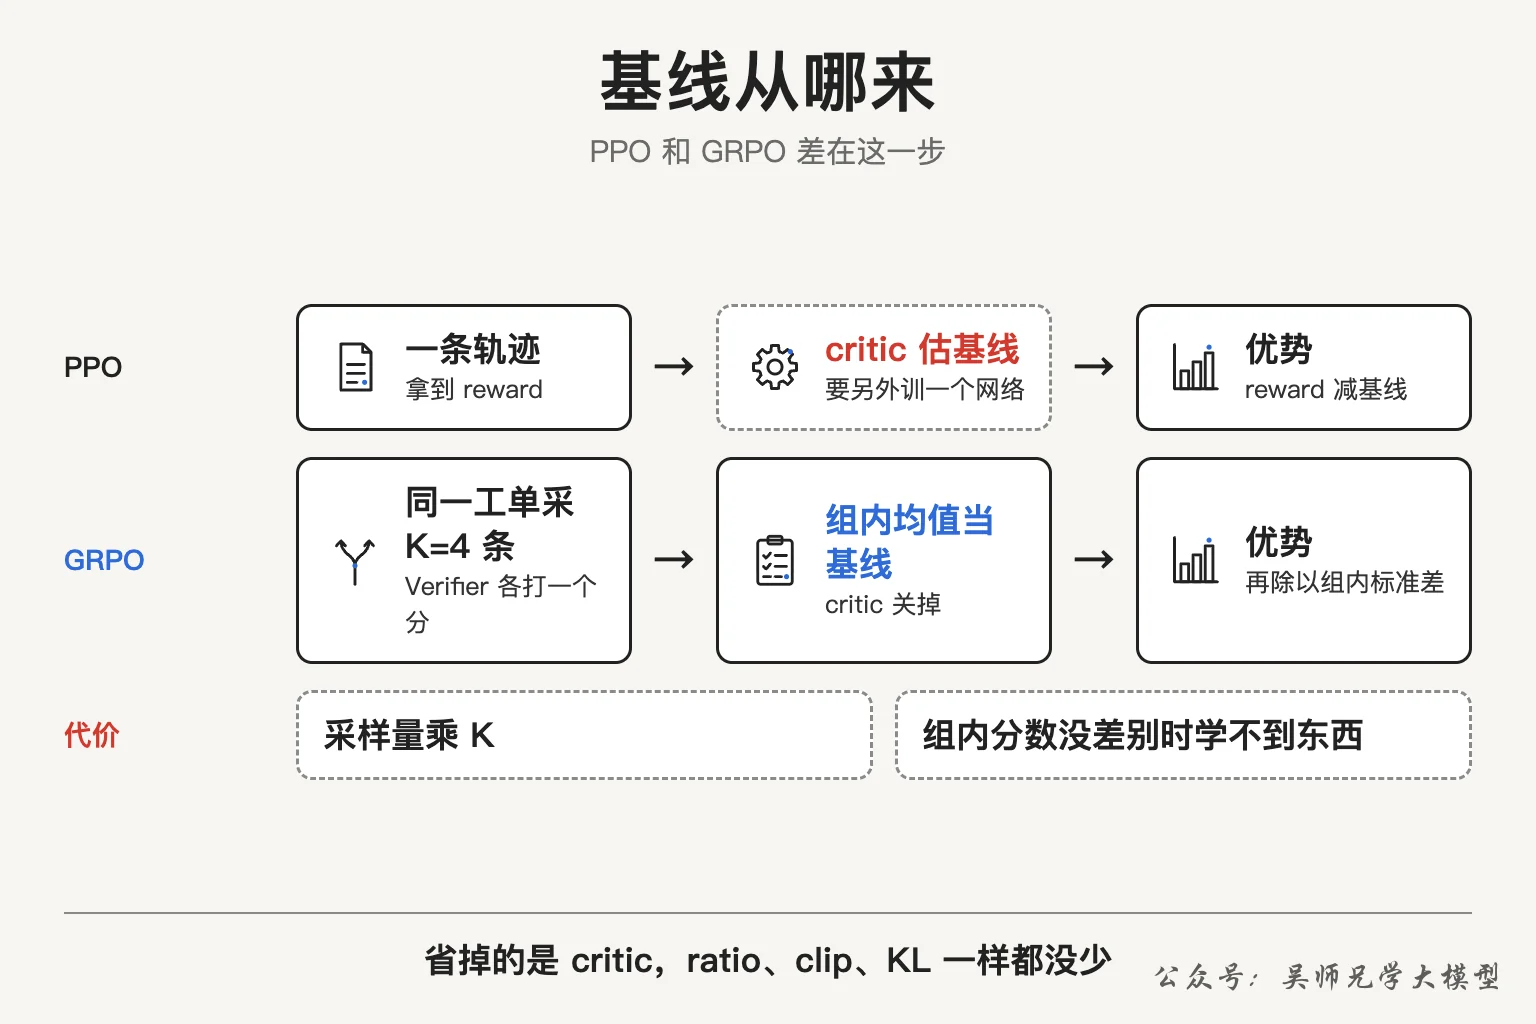
最常听到的回答就一句:PPO 要训一个 critic 来估基线,GRPO 不用,省显存。
这句话没错,但它只回答了"省掉了什么"。面试官接着会问两件事:基线去哪了,省掉 critic 你付出了什么。
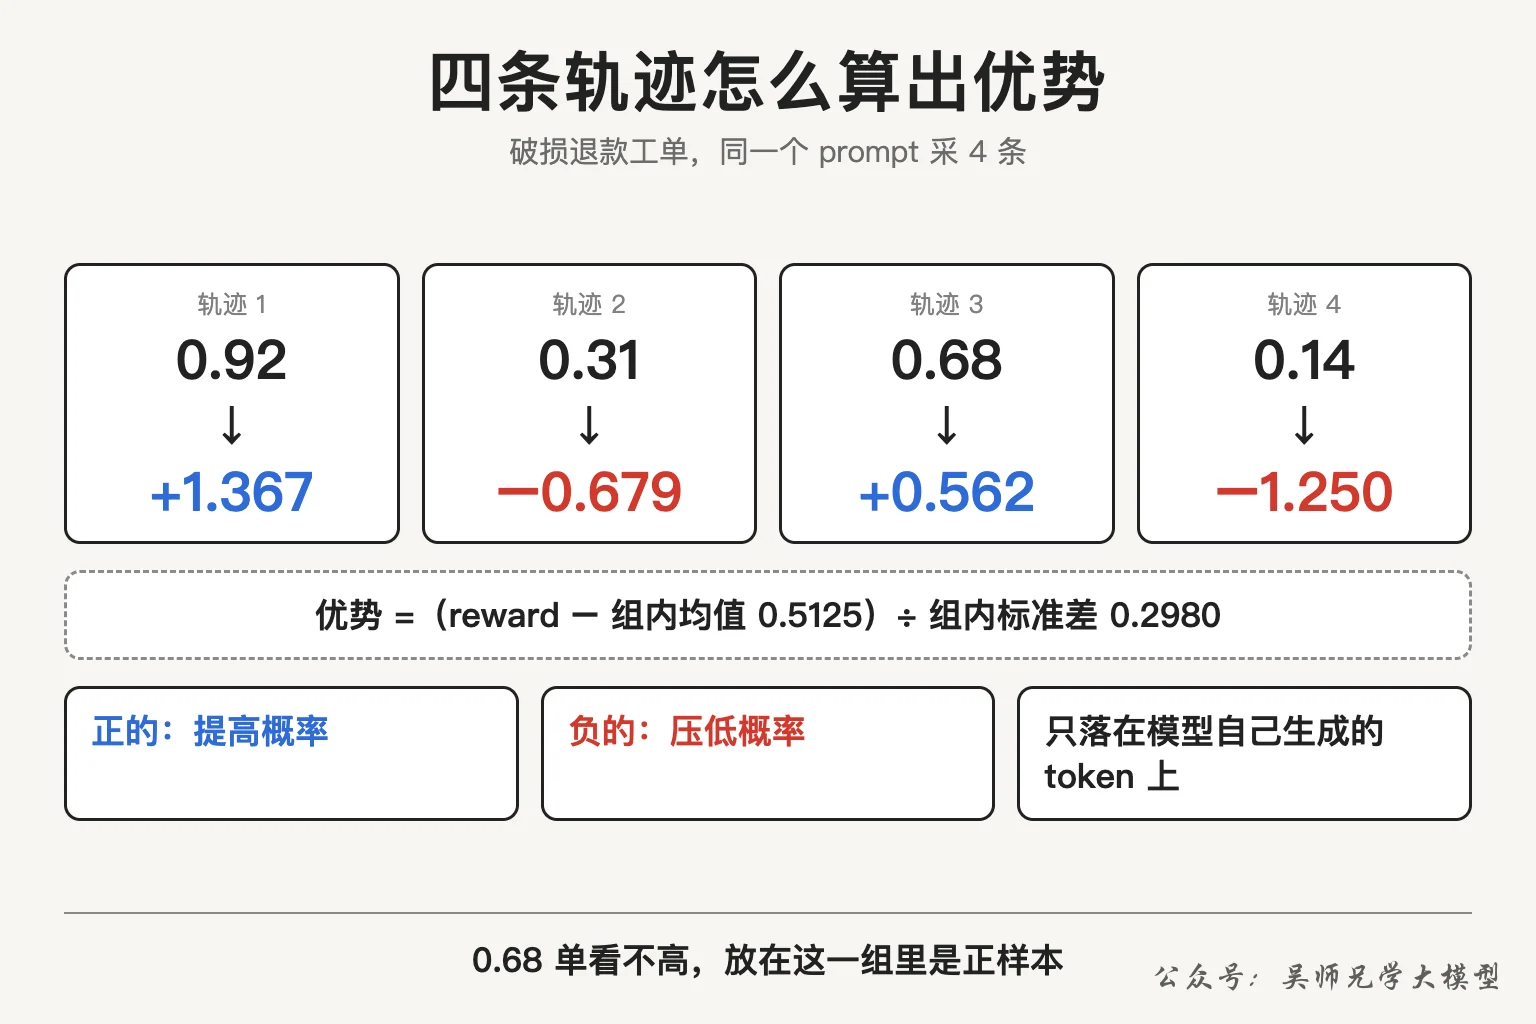
基线还在,GRPO 对同一个 prompt 采一组轨迹,用这一组 reward 的均值当基线,critic 估的那个数换成了组内统计出来的数。
ratio、clip、KL 这些 PPO 里有的东西,GRPO 一样都没少。你要是说成"GRPO 比 PPO 简单",面试官会接着让你写损失函数,题库里让手写 GRPO loss 的题有 7 道。
代价你也得跟面试官交代。同一条工单要采 K 条轨迹,采样成本直接乘 K;学习信号全靠组内的分数差,一组里分数都差不多的时候就学不到东西。
这类题还有一个变体,把 DPO 也拉进来比,美团和阿里都这么问过。
DPO 学的是成对的偏好,哪个回答更好要提前标出来,训练的时候模型不去环境里跑。我们的任务正好反过来,退没退款、改没改地址,沙盒里查得到,让模型在线试、试完打分更直接。
我自己的看法是,这道题答到"代价"就已经比大多数人深了,DPO 那段是加分项,时间不够可以不展开。
训练框架用的是 verl。启动的时候优势估计选 grpo,critic 关掉,框架自带的 reward model 也关掉,分数由项目自己的 Verifier 返回。