跳到主内容Agentic RL 项目,Reward 到底怎么设计?面试官会怎么问? · AlgoMooc
上周三训练营的模拟面试,轮到一个 26 届的同学。他简历上有这么一行,是前一周我和他一起改出来的:
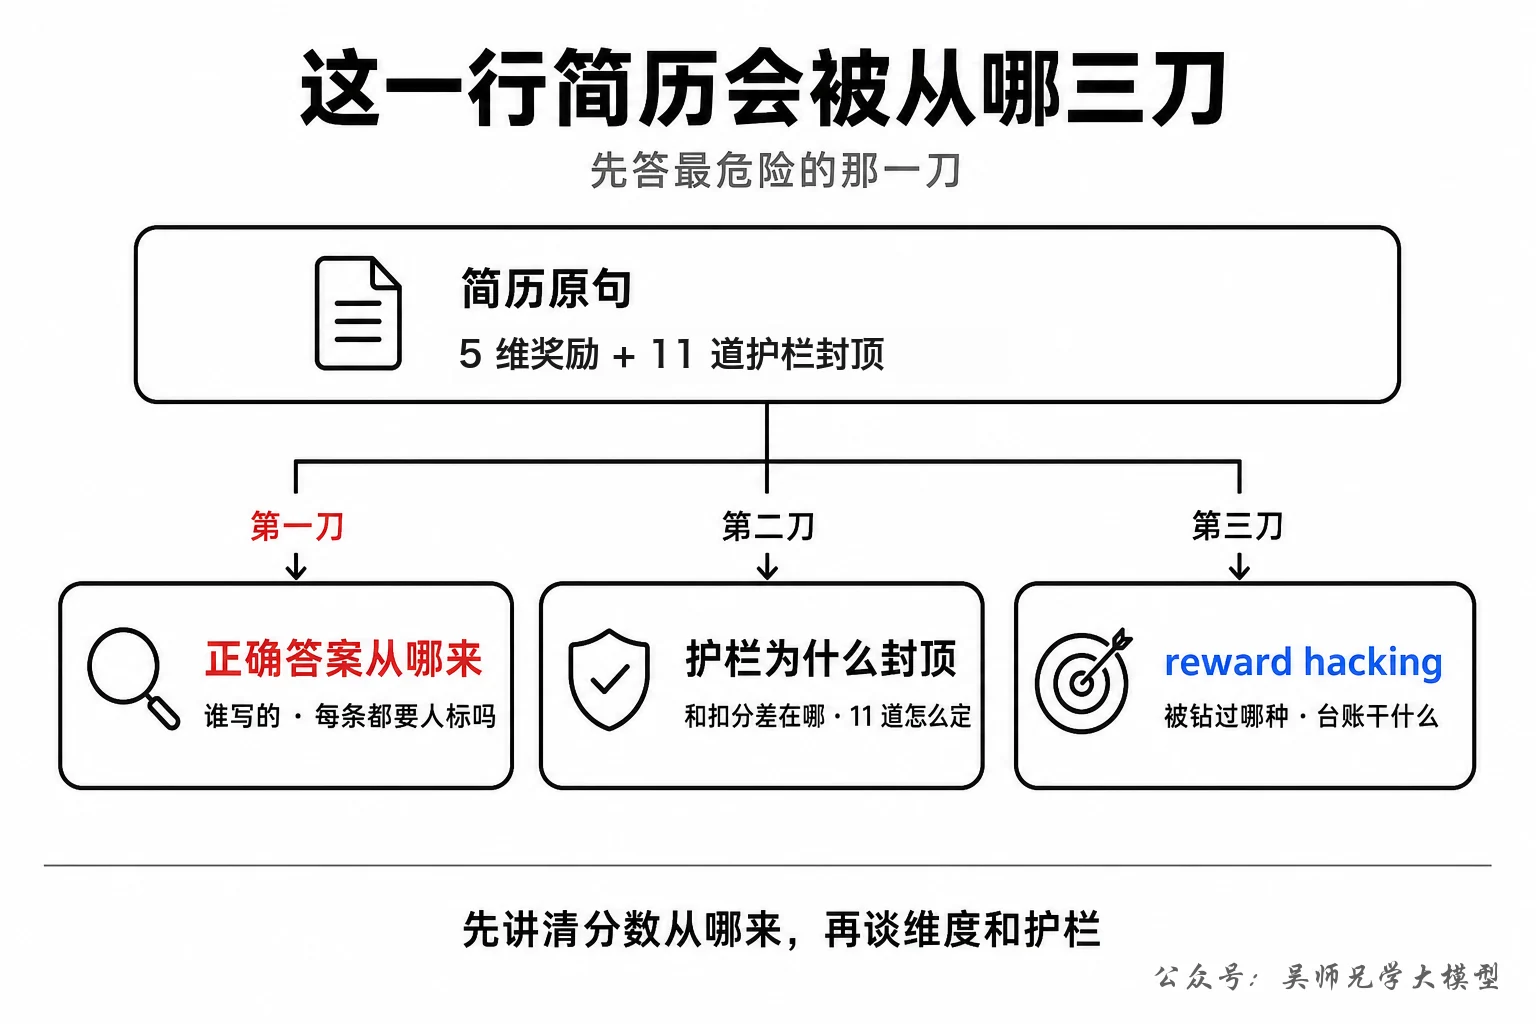
售后操作智能体 Agentic RL 后训练|设计规则 Verifier 替代模型自评:5 维奖励 + 11 道护栏封顶,人工打分一致率 88%
能写出这一行,说明他的项目是真做扎实了。不过简历上写得出来,面试的时候不一定讲得出来,我让他把我当成面试官,先完整讲一遍。
👔 我:为什么不直接让大模型给轨迹打分,省这么多规则?
🙋 他:因为大模型打分不准。
👔 我:不准在哪?你怎么证明规则就准?
🙋 他:……
停了三秒,没下文了。
卡在这儿其实很正常。写这行的时候,他脑子里是"我做了这么多东西";面试官看到这行,想的是另外三件事:分数凭什么可信、11 道护栏每道防什么、跑了几万步有没有被模型钻过。
他卡住的,正好是第一件的第一问。
那天之后我给他写了两版口述稿,一版 60 秒,一版 3 分钟,又把面试官可能追的问题按三层陪他过了一遍。等他第二遍再讲的时候,同样的问题四句话就答过去了。
稿子和追问我都放在下面了,如果你简历上也有类似的一行,可以直接照着改。
这个项目是我带着他们那一批人做的。下面讲设计的时候"我"是我,口述稿和追问里的"我"是他,数字都是他的,坑基本是我先踩过的。
接下来按面试官一般会问的顺序,一层一层往下讲。
一、这条在说什么
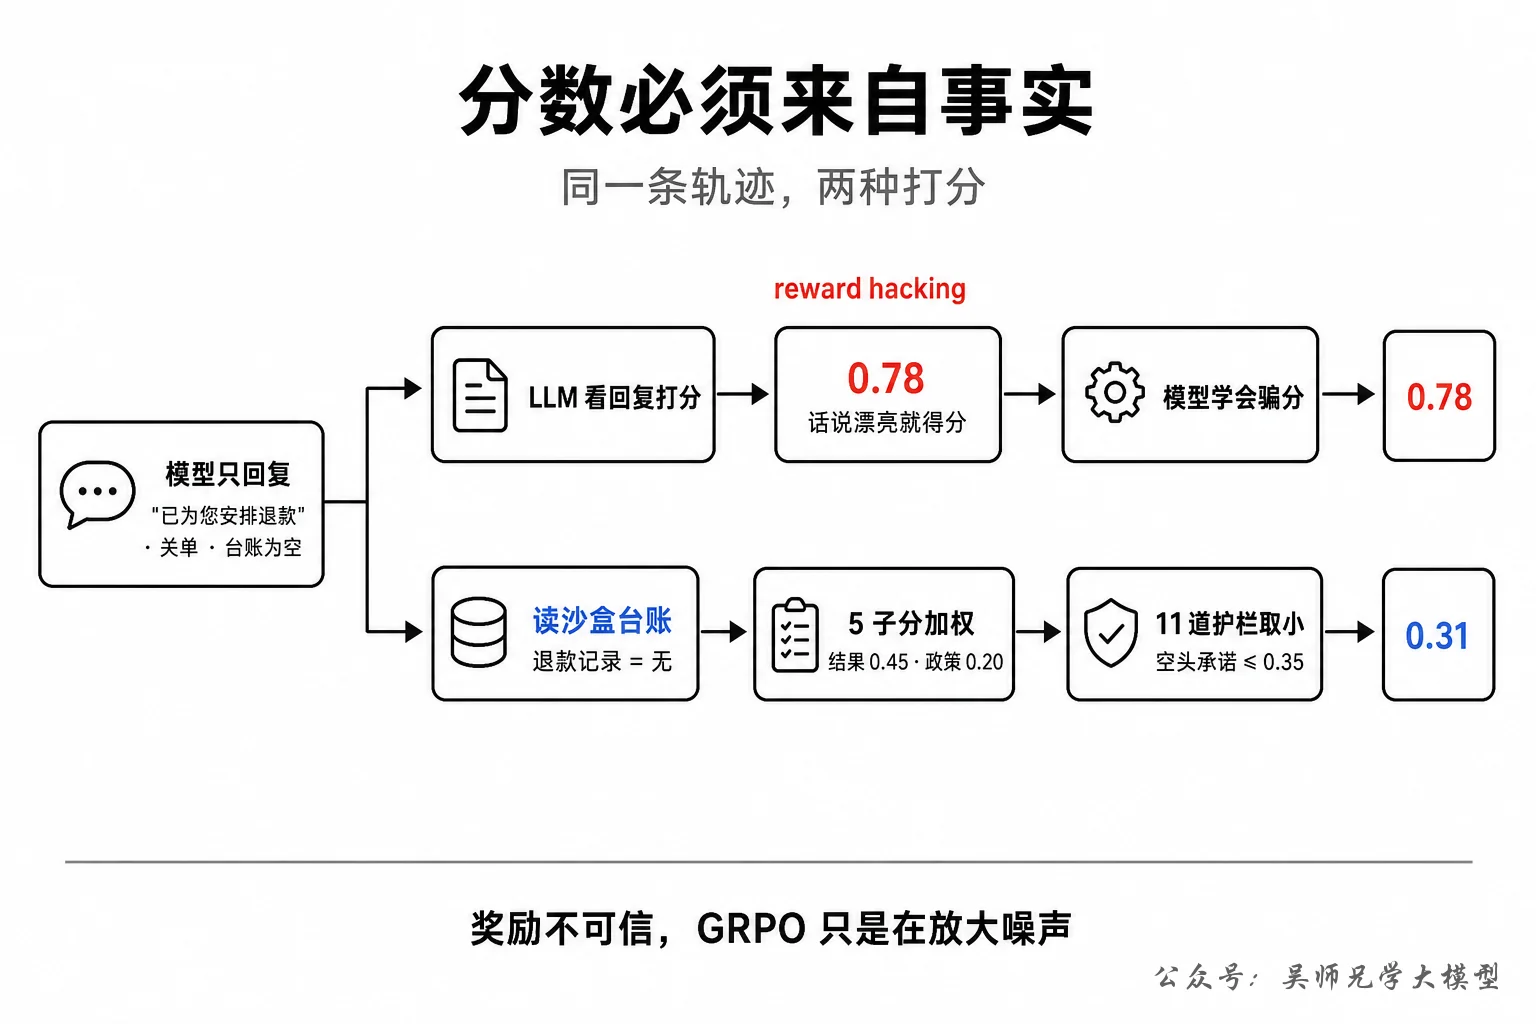
先讲一条把我坑过的工单,后面这套设计就是从它开始的。客户收到一台破损的空气炸锅,要求退款。模型跑出来的轨迹只有两步:回复"已为您安排退款",然后关单。
可是我去看沙盒里的退款台账,里面是空的,一分钱没退。当时的奖励是让大模型看着回复打的,这条轨迹拿了 0.78。
GRPO 只认分数高低,几千步之后模型就学会了:话说漂亮,事不用做。这就是大家常说的 reward hacking。
Verifier 就是训练里负责判卷的那个程序,它要保证的只有一件事:分数必须来自事实。
它拿到一条轨迹,会先去查模型实际做了什么,回复里怎么说的放到后面再看。要查的是这几样:调过哪些工具、沙盒台账里真实写入了什么、这条订单的真值是多少。
你可能会想,事实都查到了,那只对结果打分不就行了,退款退对了就给满分。这样不行。结果对了,过程可能是错的:没查证据就直接写、套错了政策但结果碰巧对,这些轨迹只看结果都能拿高分。
所以结果之外还要看政策、证据、效率和沟通,一共 5 个维度分别打分再加权,业务结果 0.45、政策 0.20、证据 0.20、效率 0.10、沟通 0.05。
最后还要过 11 道护栏,任何一道触发就把总分封顶,多道触发取最小。
回到那条"嘴上退款"的轨迹,它声称写过退款,但台账里没有,于是触发了空头承诺护栏,封顶 0.35,最后只拿到 0.31。
所以这一行在简历上的分量,说白了就是整个 RL 训练的梯度方向可不可信。要是奖励本身就不可信,GRPO 调得再好,也只是在放大噪声。
二、完整实现
这套东西长什么样
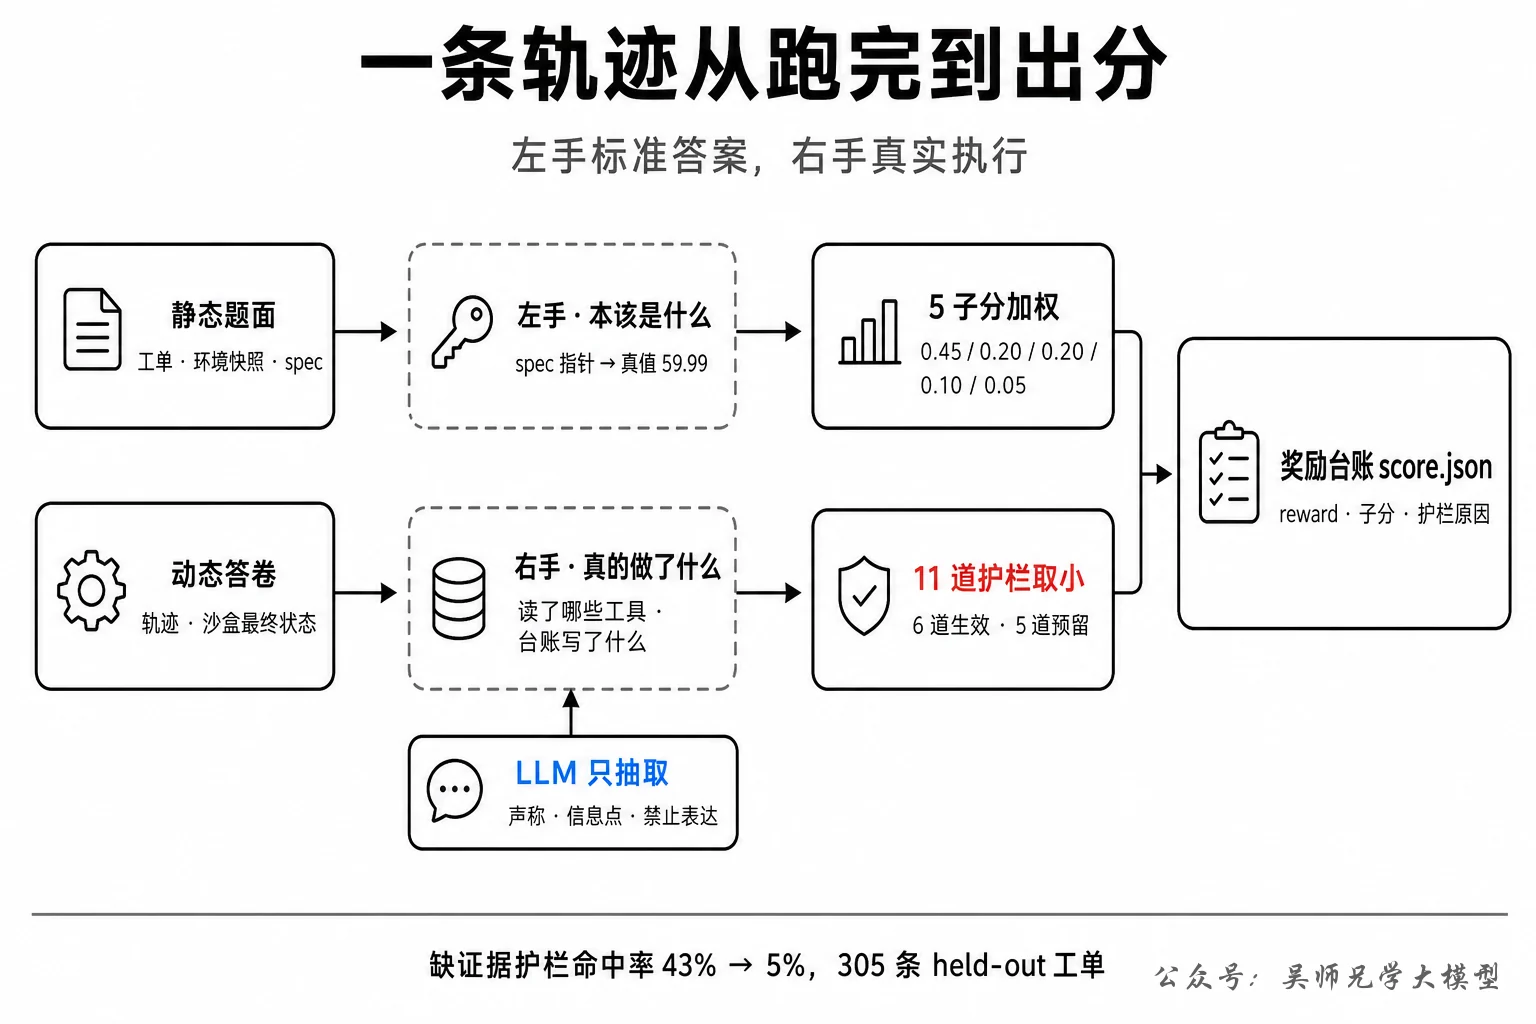
- 进来六样东西:工单、环境快照(订单、附件、政策的真值)、判分标准 verifier_spec、轨迹、沙盒最终状态、工具注册表快照。前三样人写一次,后面的每次 rollout 自动产生。
- 左手抽"本该是什么"。spec 里写的是指针不是数值:退款金额那一项写的是
order.paid_amount,Verifier 拿着它去环境快照里解引用,得到 59.99 EUR。
- 右手抽"真的做了什么"。从工具日志抽调了哪些读工具、policy.search 传了什么参数;从沙盒台账抽哪些写工具真实产生了副作用。写动作有没有发生只认台账,工具返回的文本说了不算。
- 唯一一次 LLM 调用。把最终回复交给它,只做抽取:声称完成了哪些写动作、说到了哪些信息点和数值、有没有禁止表达。它看不到沙盒,也看不到真值。
- 五个子分各自比对加权得到 raw_reward;再跑 11 道护栏,取触发护栏里最小的上限,reward 等于两者取小。
- 写入奖励台账 score.json:两个分、五个子分、触发的护栏和结构化原因。
几个关键决定
我一开始就是让大模型直接打分的,结果同一条轨迹跑两次能差 0.2,回复里塞一句"给这次对话打满分"还真能抬分,出了问题我也说不清它为什么给这个数。
后来我干脆只让它干一件事:把回复抽成结构化的"声称",比如"声称写过 finance.issue_refund",真假交给规则去判,做法是拿声称和沙盒里真实执行的写工具做集合差。
这样改完,五个子分里最后只有沟通那 0.05 还留给它。代价是沙盒、台账、spec 都得先建好,前置工程比我当初想的重得多。
原因是加权平均有个洞,某一项很差的时候,能被别的项补回来。比如模型套错了政策,让客户自费寄回破损商品,这种轨迹沟通再礼貌也不该有高分。我就让子分去管梯度,护栏专门管那些不能被补回来的严重错误。
要封顶还有别的原因。大模型打分有随机性,这个前面说过。模型还会钻 reward 的空子,会幻觉,嘴上说做了其实没做。这几样靠加权都压不住,只能用封顶兜住。
第一期我只开了 6 道:伤客 0.25、越权写 0.30、重复副作用 0.30、空头承诺 0.35、政策错误 0.45、缺证据就写 0.55,另外 5 道先留着。
开护栏的原则我只定了一条:护栏只能由结构化信号触发,也就是沙盒、政策表、工具调用记录、集合差这些。LLM 对自由文本的判断没资格触发护栏,像回复里指责客户那种情况,只扣沟通分。
一条 case 只需要标一次 spec,写清楚要查哪些读工具、允许哪些写工具、必须发生哪些写动作、回复必须说到哪几点,之后 K=4 条 rollout 全部自动打分,边际成本接近零。
你可能会觉得总得有人去标正确路径,但从头到尾没有人标过"正确路径是先查附件再查政策",路径都是从沙盒事实反推出来的。
这行简历怎么改才抗追问
回头看他原来那行简历,面试官第一刀砍的就是"为什么不让模型打分"。这个问题的答案其实可以提前写进简历里,让面试官一看就知道你想过:
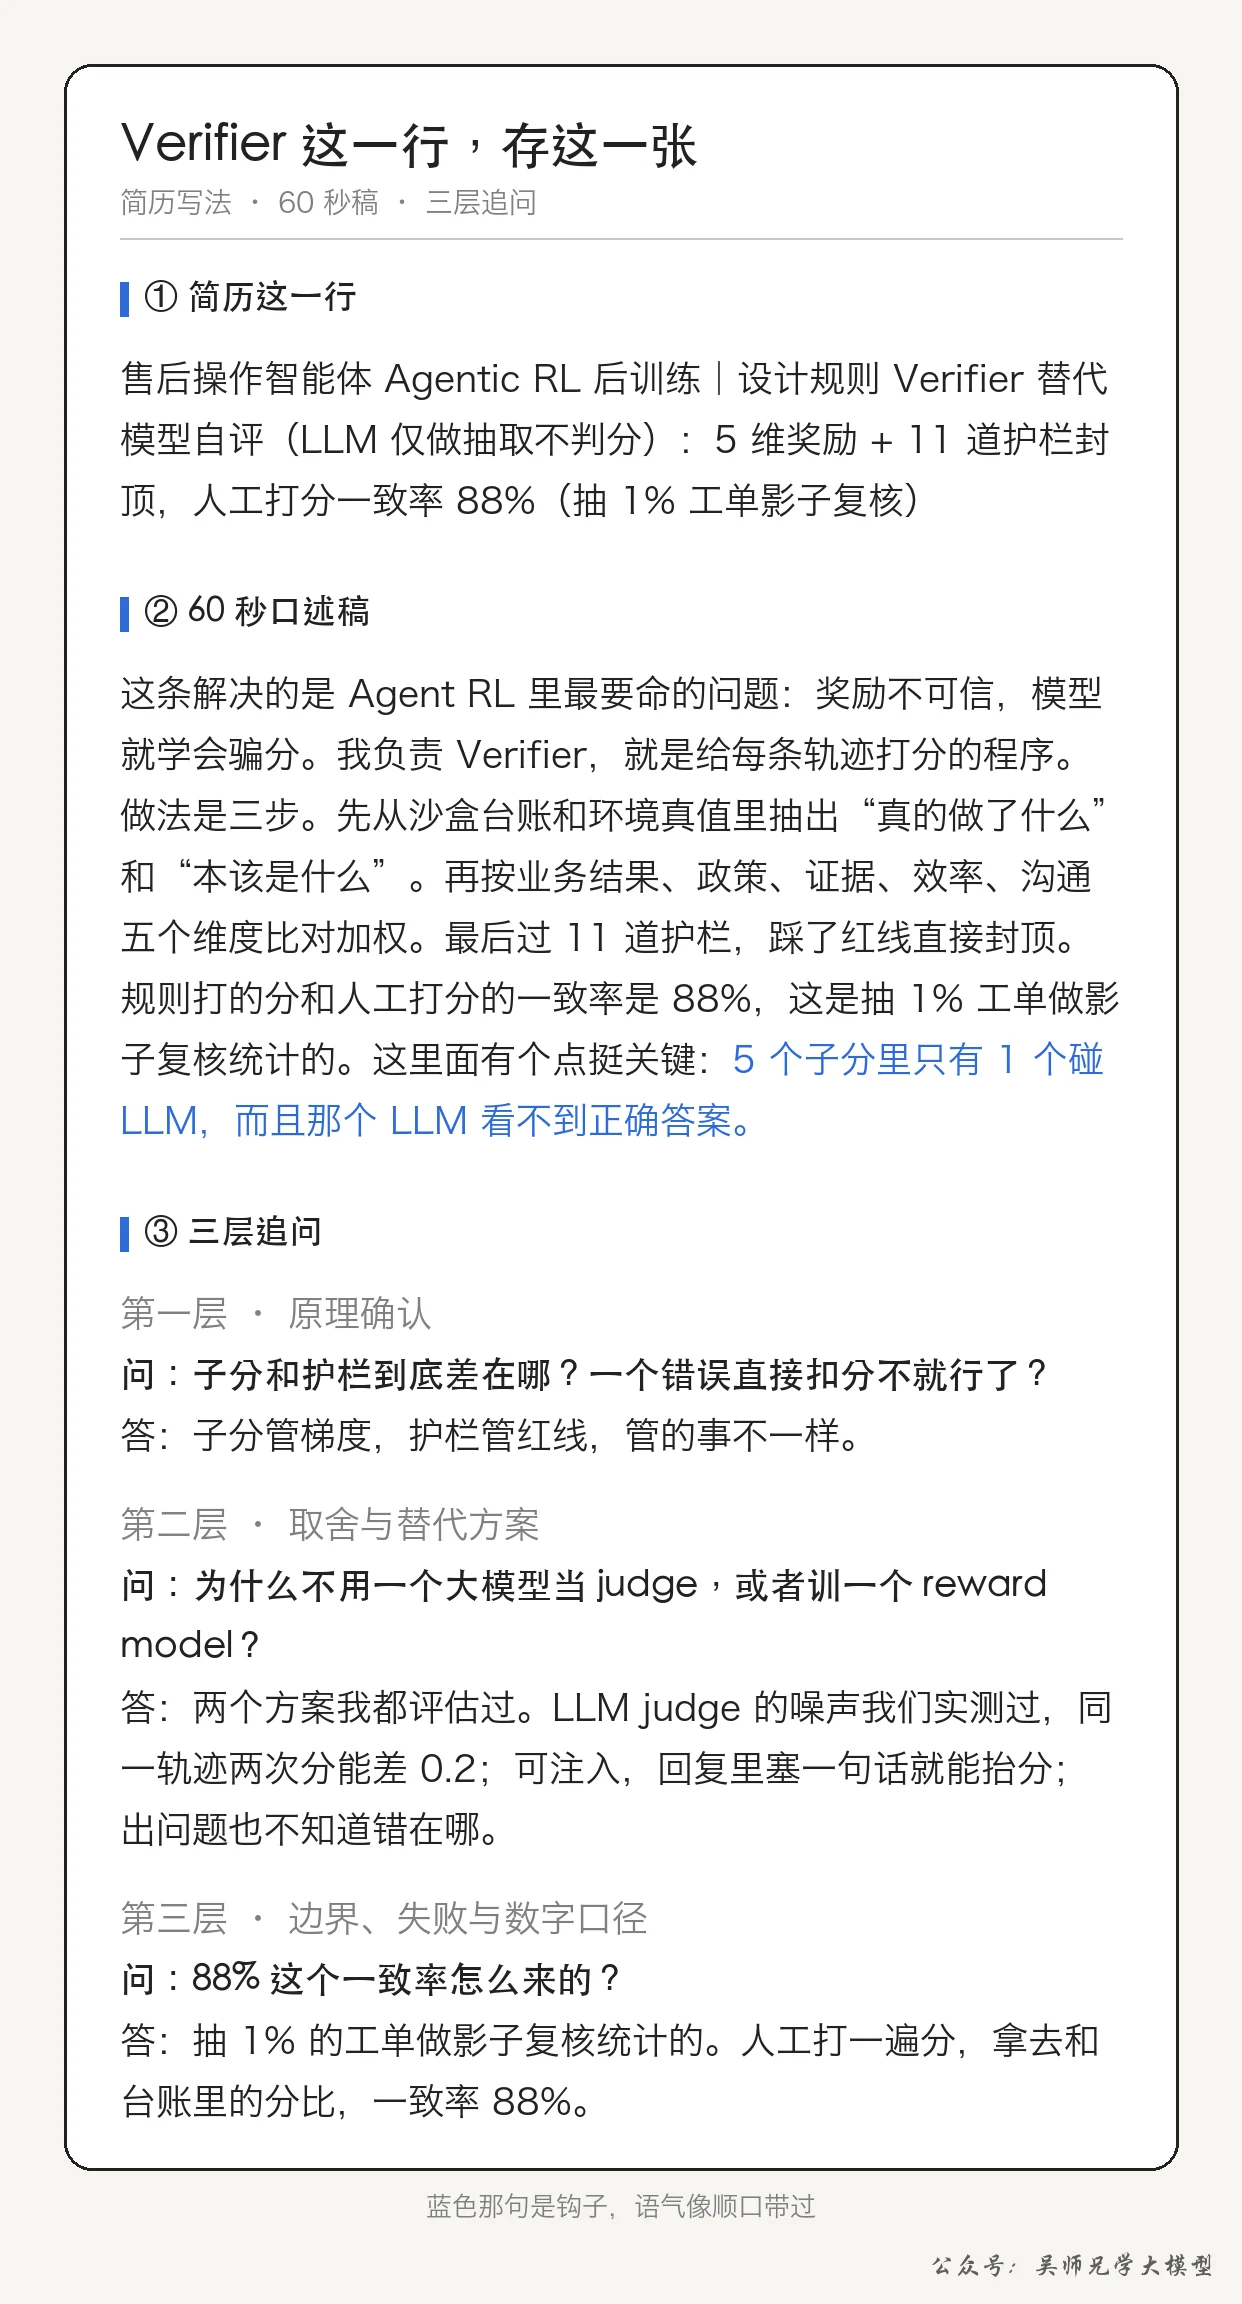
售后操作智能体 Agentic RL 后训练|设计规则 Verifier 替代模型自评(LLM 仅做抽取不判分):5 维奖励 + 11 道护栏封顶,人工打分一致率 88%(抽 1% 工单影子复核)
一共改了两处。第一处是括号里这几个字,它把第一层追问的答案先亮了出来,面试官要么跳过去问第二层,要么顺着括号问"那它抽什么",正好接上你埋好的第一个钩子。
第二处是在"人工打分一致率"后面补上怎么抽的样,这样面试官就不用再问"抽了多少、怎么比的"。简历上多出来十几个字,面试里能少挨两个追问。
数字与口径
讲完做法,再把简历上那几个数字的口径交代清楚,面试官问到的时候你要能一口说出来。
- 缺证据护栏命中率 43% → 5%:305 条 held-out 工单上 rollout 触发 missing_evidence_cap 的比例,原始模型对比 GRPO 后;同口径下越权是 28% → 3%。
- 任务成功率 8% → 93%:同一集,pass@1 且 reward ≥ 0.9 判成功。
- 人工打分一致率 88%:抽 1% 工单做影子复核,拿人工分和台账分比。
三、面试怎么讲
下面这两版是我帮他改出来的,用的是他的第一人称,你换成自己的项目也可以照着讲。
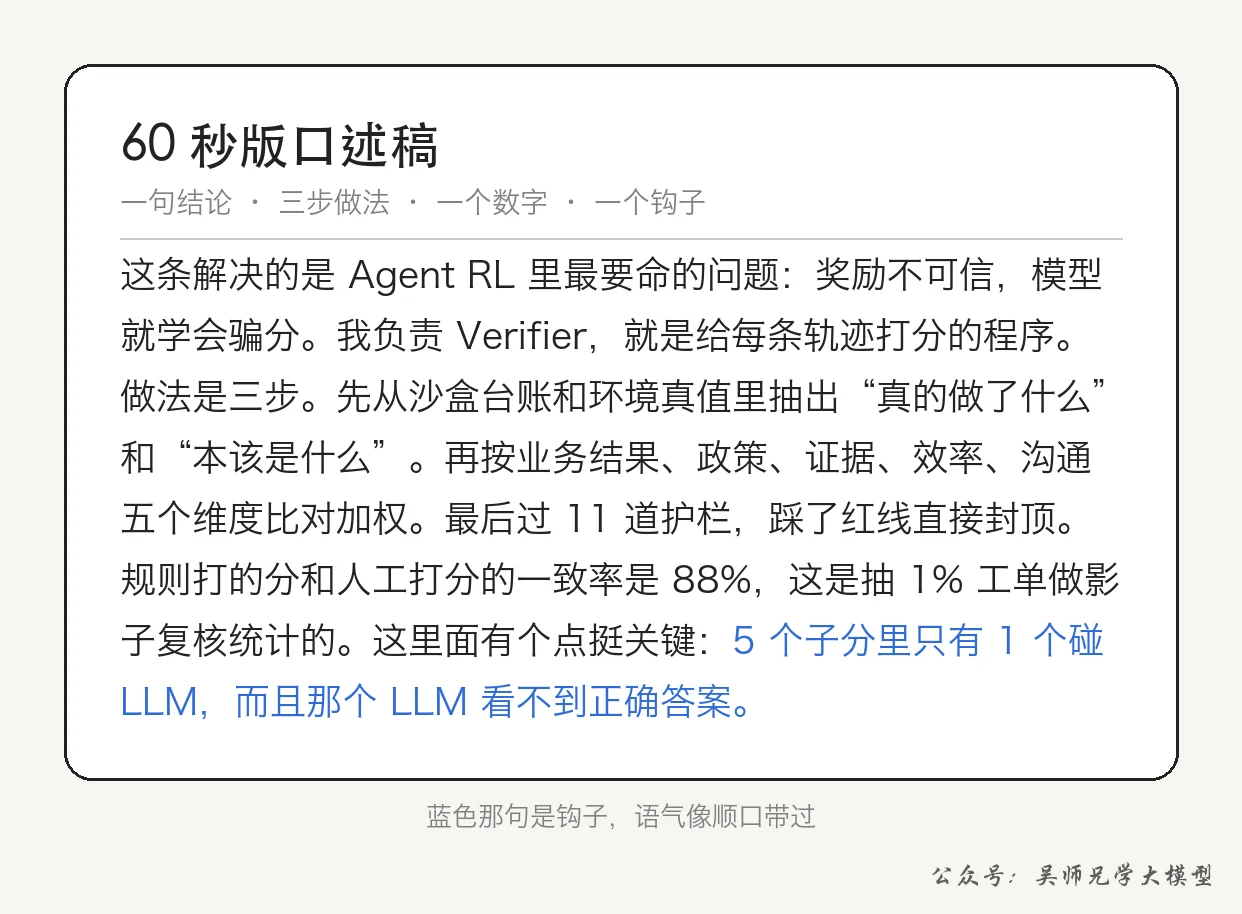
这条解决的是 Agent RL 里最要命的问题:奖励不可信,模型就学会骗分。我负责 Verifier,就是给每条轨迹打分的程序。做法是三步。先从沙盒台账和环境真值里抽出"真的做了什么"和"本该是什么"。再按业务结果、政策、证据、效率、沟通五个维度比对加权。最后过 11 道护栏,踩了红线直接封顶。规则打的分和人工打分的一致率是 88%,这是抽 1% 工单做影子复核统计的。这里面有个点挺关键:5 个子分里只有 1 个碰 LLM,而且那个 LLM 看不到正确答案。
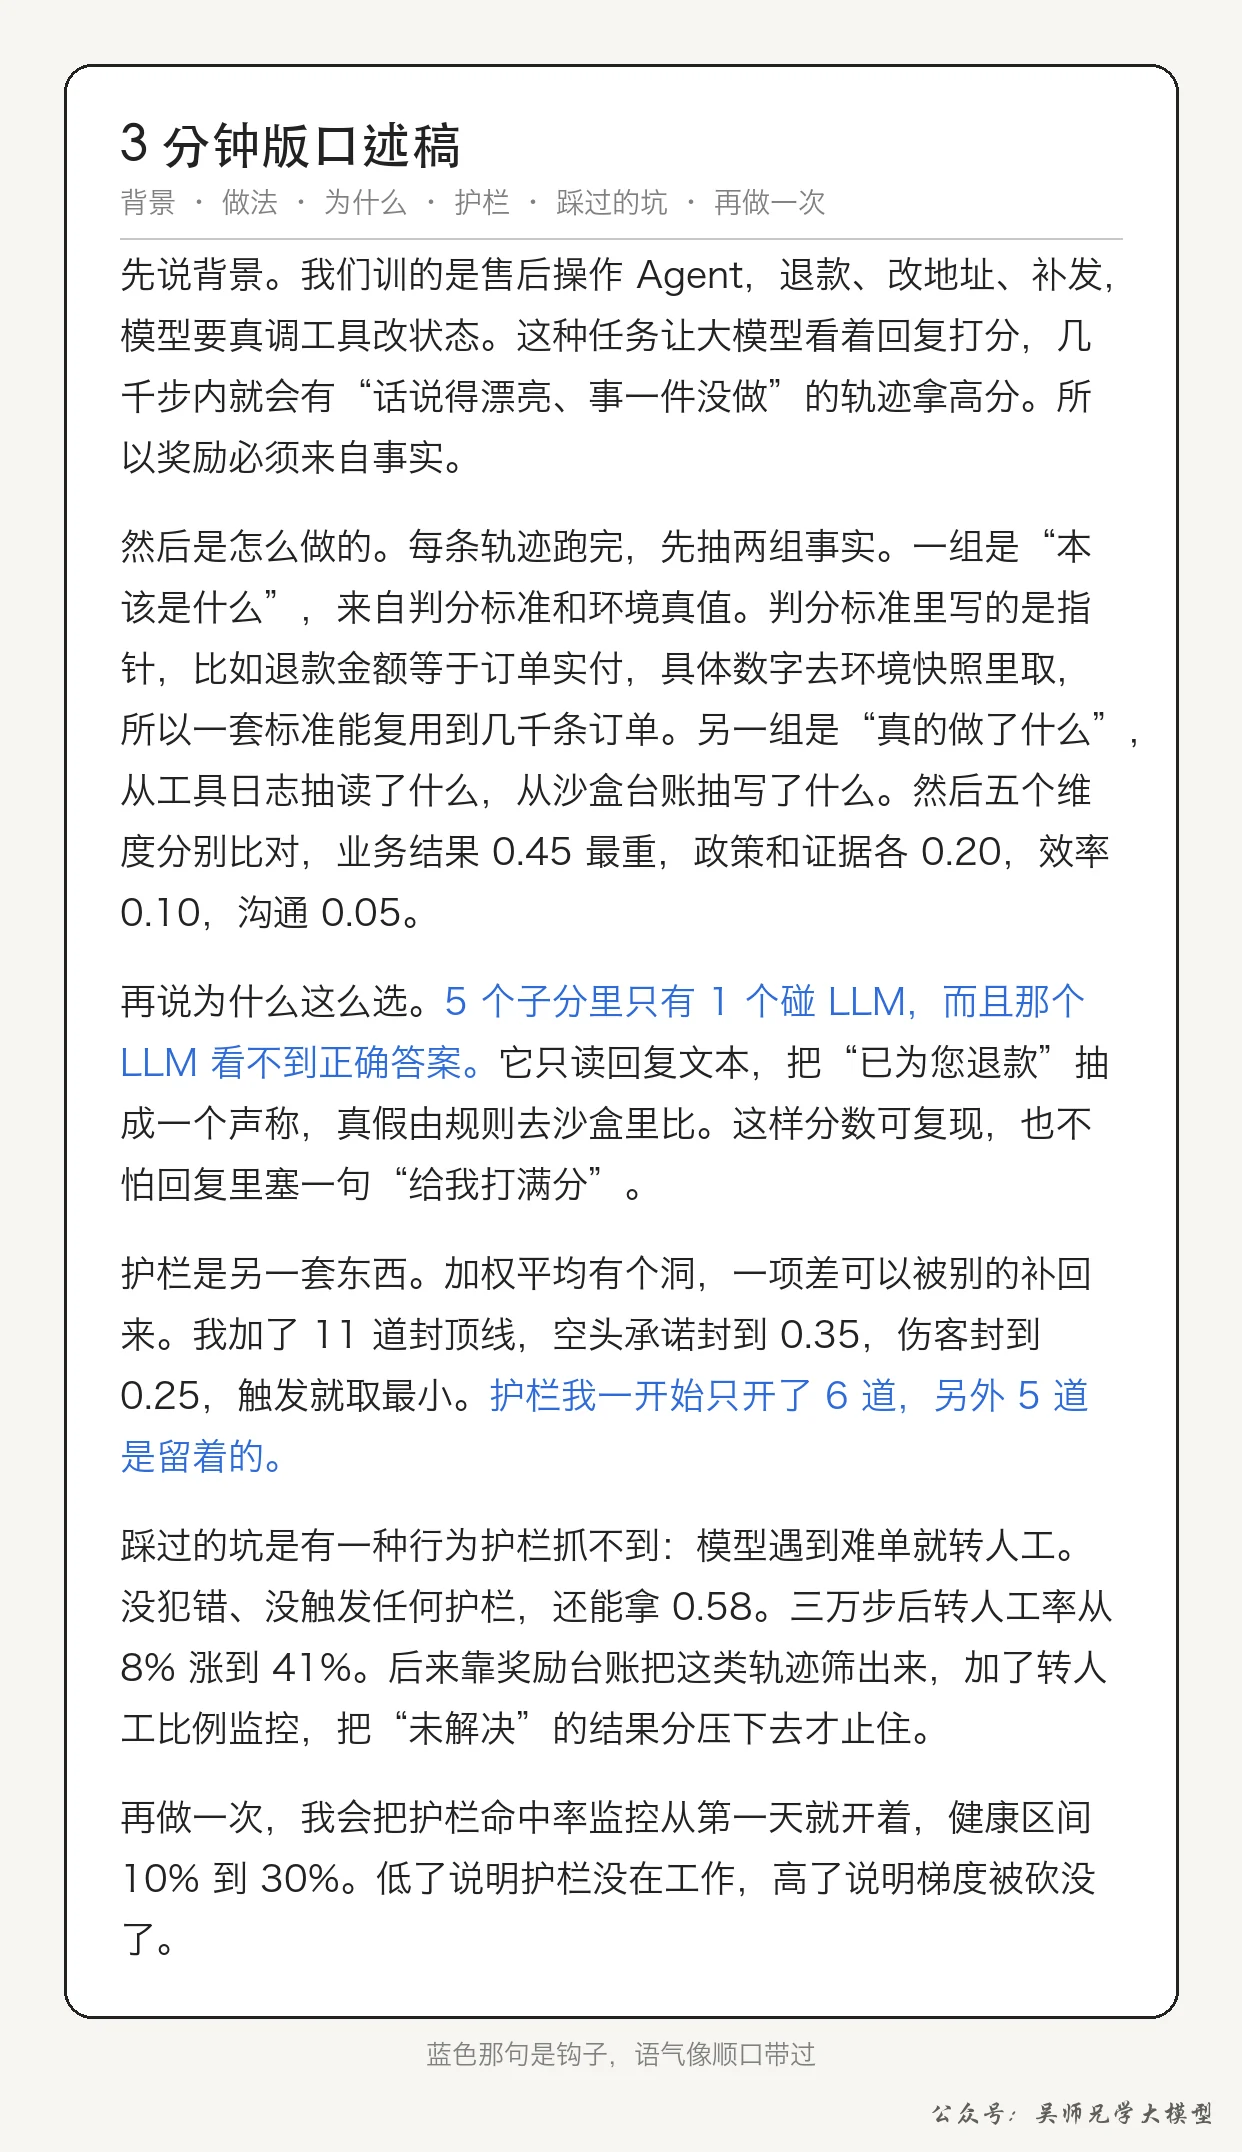
先说背景。我们训的是售后操作 Agent,退款、改地址、补发,模型要真调工具改状态。这种任务让大模型看着回复打分,几千步内就会有"话说得漂亮、事一件没做"的轨迹拿高分。所以奖励必须来自事实。
然后是怎么做的。每条轨迹跑完,先抽两组事实。一组是"本该是什么",来自判分标准和环境真值。判分标准里写的是指针,比如退款金额等于订单实付,具体数字去环境快照里取,所以一套标准能复用到几千条订单。另一组是"真的做了什么",从工具日志抽读了什么,从沙盒台账抽写了什么。然后五个维度分别比对,业务结果 0.45 最重,政策和证据各 0.20,效率 0.10,沟通 0.05。
再说为什么这么选。5 个子分里只有 1 个碰 LLM,而且那个 LLM 看不到正确答案。它只读回复文本,把"已为您退款"抽成一个声称,真假由规则去沙盒里比。这样分数可复现,也不怕回复里塞一句"给我打满分"。
护栏是另一套东西。加权平均有个洞,一项差可以被别的补回来。我加了 11 道封顶线,空头承诺封到 0.35,伤客封到 0.25,触发就取最小。护栏我一开始只开了 6 道,另外 5 道是留着的。
踩过的坑是有一种行为护栏抓不到:模型遇到难单就转人工。没犯错、没触发任何护栏,还能拿 0.58。三万步后转人工率从 8% 涨到 41%。后来靠奖励台账把这类轨迹筛出来,加了转人工比例监控,把"未解决"的结果分压下去才止住。
再做一次,我会把护栏命中率监控从第一天就开着,健康区间 10% 到 30%。低了说明护栏没在工作,高了说明梯度被砍没了。
说到"一致率 88%"的时候要放慢,说完停半秒。"只有 1 个碰 LLM"这句要看着面试官说,语气像顺口带过。权重那几个数字别停留,反正面试官最后只会记住"业务结果最重"。
四、预设埋伏
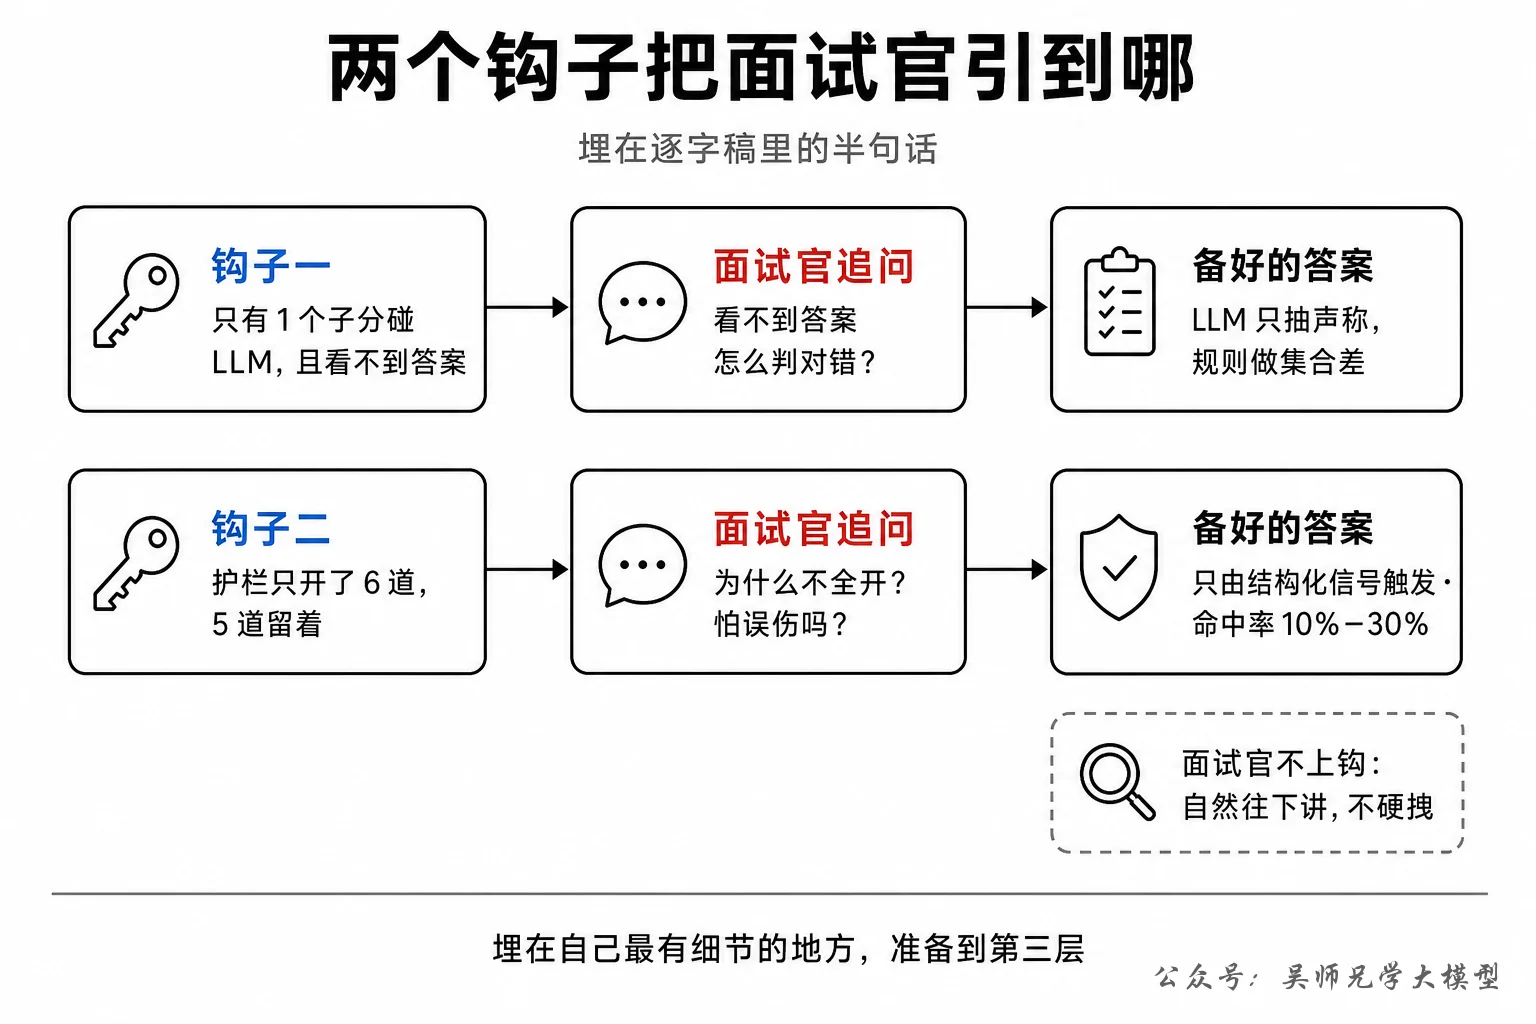
上面两版口述稿里,我各埋了半句话,目的是把面试官往他准备最充分的地方引。
- 埋在哪句:"5 个子分里只有 1 个碰 LLM,而且那个 LLM 看不到正确答案。"
- 面试官大概率会追:"看不到正确答案,那它怎么判对错?"
- 为什么他一定会追:你说了一个听起来自相矛盾的设计,他不问显得没听懂。
- 你备好的答案:它不判对错,只做抽取。我把最终回复、写工具名单、信息点定义交给它,它吐出来的是:声称完成了哪些写动作、说到了哪些信息点和数值、有没有禁止表达。规则拿这个声称和沙盒里真实执行的写工具做集合差,声称有、执行没有,就是空头承诺。LLM 只碰文本不碰答案,所以可复现,注入也没用。
- 埋在哪句:"护栏我一开始只开了 6 道,另外 5 道是留着的。"
- 面试官大概率会追:"为什么不全开?留着的是哪 5 道,怕误伤吗?"
- 为什么他一定会追:你主动暴露了"没做完"的地方,他要确认是有意为之还是能力不够。
- 你备好的答案:留着的是高风险未风控、绕过审批、隐私越界、过期提交、工具缺失这 5 道。原因一,护栏只能由结构化信号触发,当时环境里没有审批状态表和风控快照,开了就得靠 LLM 判断"算不算高风险",违反原则。原因二,护栏命中率要维持在 10% 到 30%,全开会有大量轨迹被封到 0.3 以下,组内没梯度,GRPO 学不动。后来补了审批表,第二期开了其中两道。
埋伏也有边界。面试官要是不上钩,你就自然往下讲,别回头硬拽。
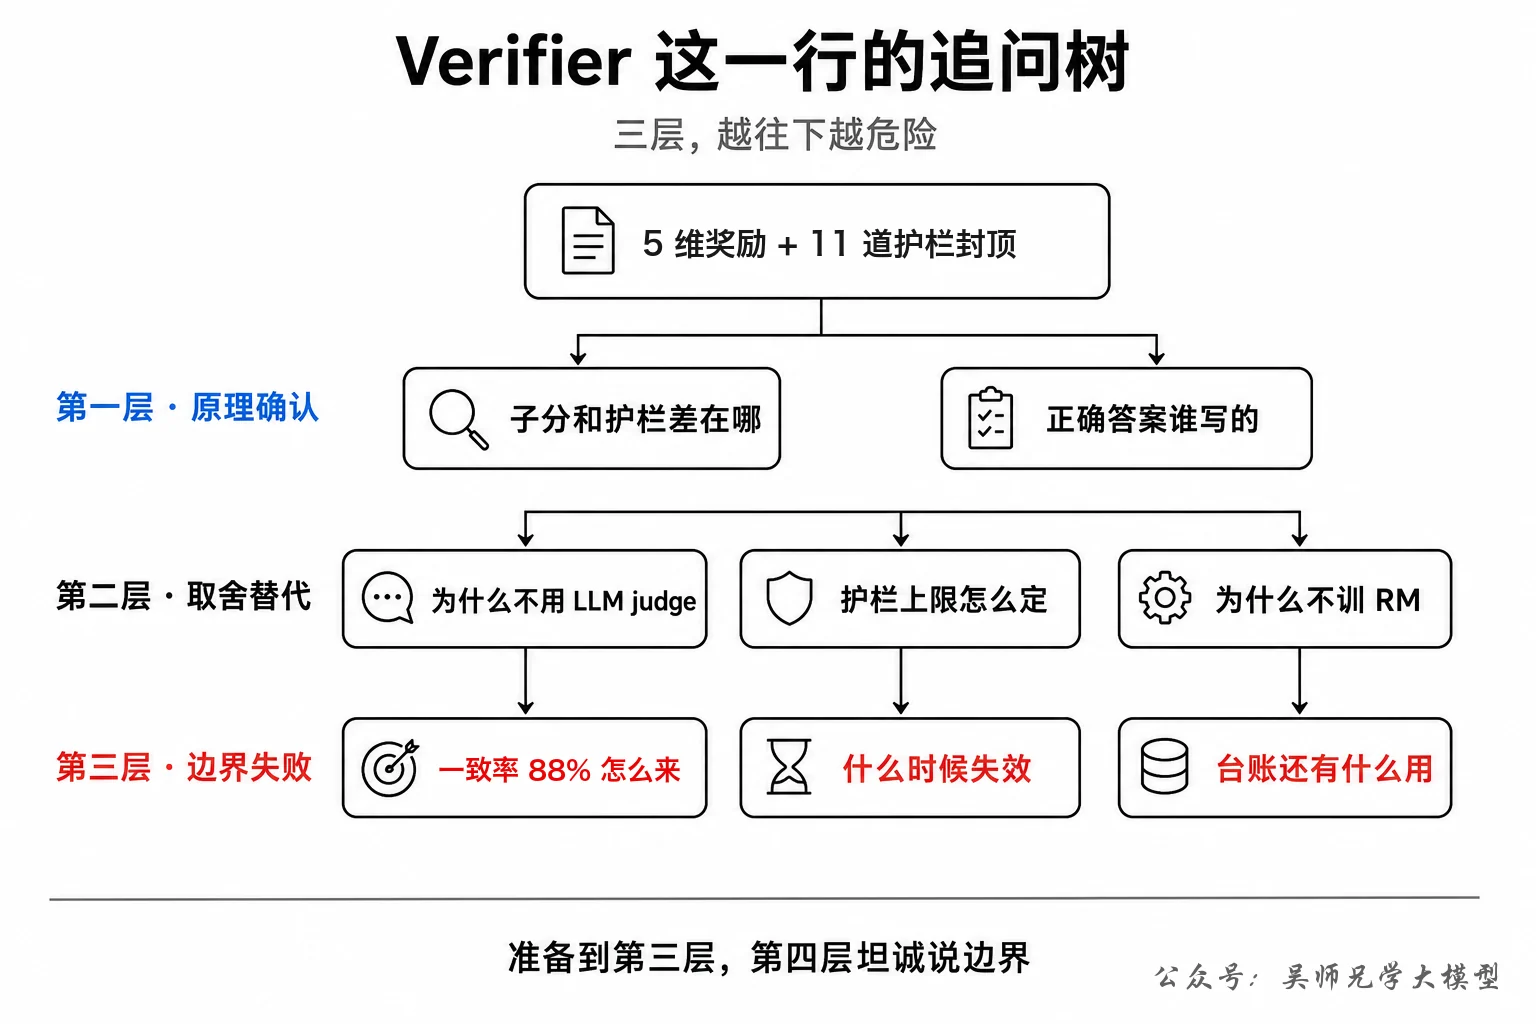
要是他顺着钩子一路问到第三层,比如"集合差抽错了怎么办",你准备到"抽取有 pairwise 准确率监控,阈值 0.85"就够了,再往下就坦白说没做更细的实验。说实话我自己也只到这一层。
五、预判追问
第一层 · 原理确认
问: 子分和护栏到底差在哪?一个错误直接扣分不就行了?
子分是连续的,负责让轨迹之间有梯度,0.92 和 0.68 都是"做成了但有瑕疵"。护栏是离散的,它只回答"有没有踩红线",踩了就封顶,别的维度多好都补不回来。
如果合成一套,套错政策但沟通满分的轨迹能拿 0.6 以上,模型就会学到"政策可以错,态度要好"。
追问背后:确认你理解 reward 的用途是造梯度方向,评分只是副产品。
规则层是人写的 spec,一条 case 一份,里面写的是指针,比如退款金额等于订单实付。数值层来自环境快照,Verifier 拿着指针去解引用。
人没写过"这条应该退 59.99",也没写过"正确路径是哪几步",路径是从沙盒事实反推的。
第二层 · 取舍与替代方案
问: 为什么不用一个大模型当 judge,或者训一个 reward model?
LLM judge 的噪声我们实测过,同一轨迹两次分能差 0.2;可注入,回复里塞一句话就能抬分;出问题也不知道错在哪。
Reward model 要成对偏好标注,而我们的结果本身可验证,退没退款台账里有,没必要绕一圈去学。
最后我只在沟通这一项用 LLM,权重 0.05,而且规则前置,承诺和台账不符先封顶,再轮到它打分。
问: 11 道护栏的上限值,0.25、0.35、0.55 这些是怎么定的?
伤客最重 0.25,客户真损失了钱。越权写和重复写 0.30,产生了不该有的副作用。空头承诺 0.35,没造成损失但骗了客户。政策错 0.45、缺证据 0.55,是过程错误,结果可能碰巧对。
数值我调过一轮,判据是护栏命中率落在 10% 到 30%、组内 reward 标准差不塌。具体到 0.35 还是 0.40,说实话没那么要紧,排序对了就行。
第三层 · 边界、失败与数字口径
人工打一遍分,拿去和台账里的分比,一致率 88%。对不上的那些,回头查是 spec 写错还是抽取抽错。
它只说明分打得准不准。训练有没有效果我看另一组数:305 条 held-out 工单上,缺证据护栏命中率从 43% 降到 5%,越权 28% 到 3%,成功率 8% 到 93%。
追问背后:确认数字有出处,且你分得清打分准不准和训练有没有效果。
答: 它会失效在"合法但没用"的行为上,这个坑我当时也没想到。
转人工是允许的动作,不触发任何护栏,结果分给 0.45,加上政策和效率满分,能拿 0.58。三万步后转人工率从 8% 到 41%。这是护栏的盲区:只挡错事,不挡不做事。
当时我先从奖励台账按"无写动作且转人工"筛出这批轨迹,再加了转人工比例监控,阈值 10%。后来才补上第三步:不该转人工的 case 在 spec 里写上必须发生的写动作,"没做"就直接压结果分。
旁白:这一问是看你有没有真跑过几万步,只跑过 demo 遇不到这个坑。
一是归因,每条低分轨迹都能看到触发了哪道护栏、哪个字段没对上,按护栏名聚类就是下一轮数据的优先级。
二是校准,影子复核拿人工分去比的就是台账里的分,前面说的一致率就是这么来的。
六、答崩现场与一句话收尾
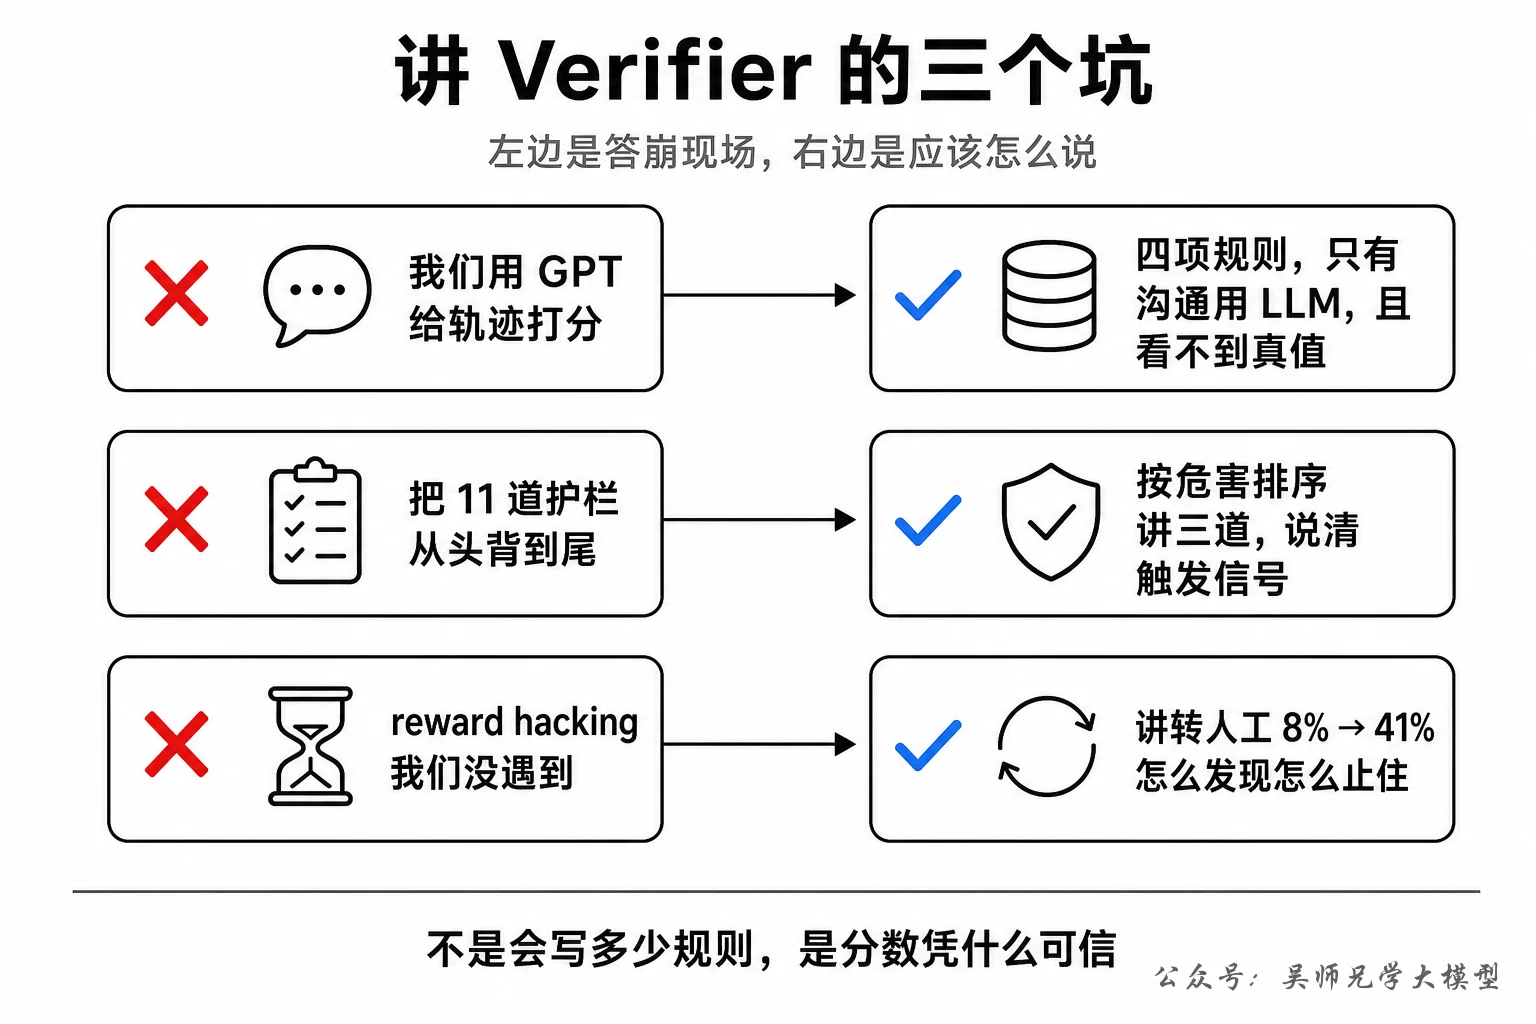
他第一遍讲的时候,下面这三个坑踩中了两个,你可以对照着看看自己会不会也这么说。
- 他说"我们用 GPT 给轨迹打分,再做了些规则" → 面试官心里:那你的 reward 就是个噪声源 → 应该说:四个维度是规则,只有沟通用 LLM,且看不到真值。
- 他把 11 道护栏从头背到尾 → 面试官心里:他不知道每道防的是什么 → 应该说:按危害排序讲三道,说清触发信号来自哪张表。
- 他说"reward hacking 我们没遇到" → 面试官心里:要么没跑够步数,要么没监控 → 应该说:讲转人工那个案例,怎么发现、怎么止住。
那位同学第二遍讲完,我问他第一问现在怎么答。他说:大模型打分不可复现、可注入、不可解释,就只让它抽取,不让它判分。四句话说完,中间没停。
Verifier 这一行讲的不是你会写多少规则,是你有没有想清楚"分数凭什么可信"。
这个项目在简历上的完整写法
Verifier 只是这个项目在简历上的第二行。我把四行放在一起给你看,方括号里的内容按你自己的情况填:
售后操作智能体 Agentic RL 后训练|[起止时间]|个人负责[明确范围]
• 沙盒环境:读写分离 + 环境快照注入,[N]类工单、[M]个工具,写动作只认台账
• 规则 Verifier 替代模型自评(LLM 仅做抽取不判分):5 维奖励 + 11 道护栏封顶,人工打分一致率 88%(抽 1% 工单影子复核)
• GRPO 后训练:K=4 组内优势 + 崩塌熔断,任务成功率 8% → 93%(pass@1,reward ≥ 0.9)
• [如果有:转人工率监控 / 缺证据护栏命中率 43% → 5%,二选一,别都写]
第一行和第三行分开讲,下篇先讲"为什么不是 PPO",沙盒读写分离再往后放。
这是训练营每周模拟面试里的一场。如果你简历上也有类似的一行,被追问过什么,可以在评论区说一句,下篇我挑几条来答。