一个研究问题拆成八条路径,每条路径交给一个Agent,最后综合报告。代码里有异步函数,也有asyncio.gather。看起来八条路径已经一起出发,运行时却可能还是一条结束,下一条才开始。
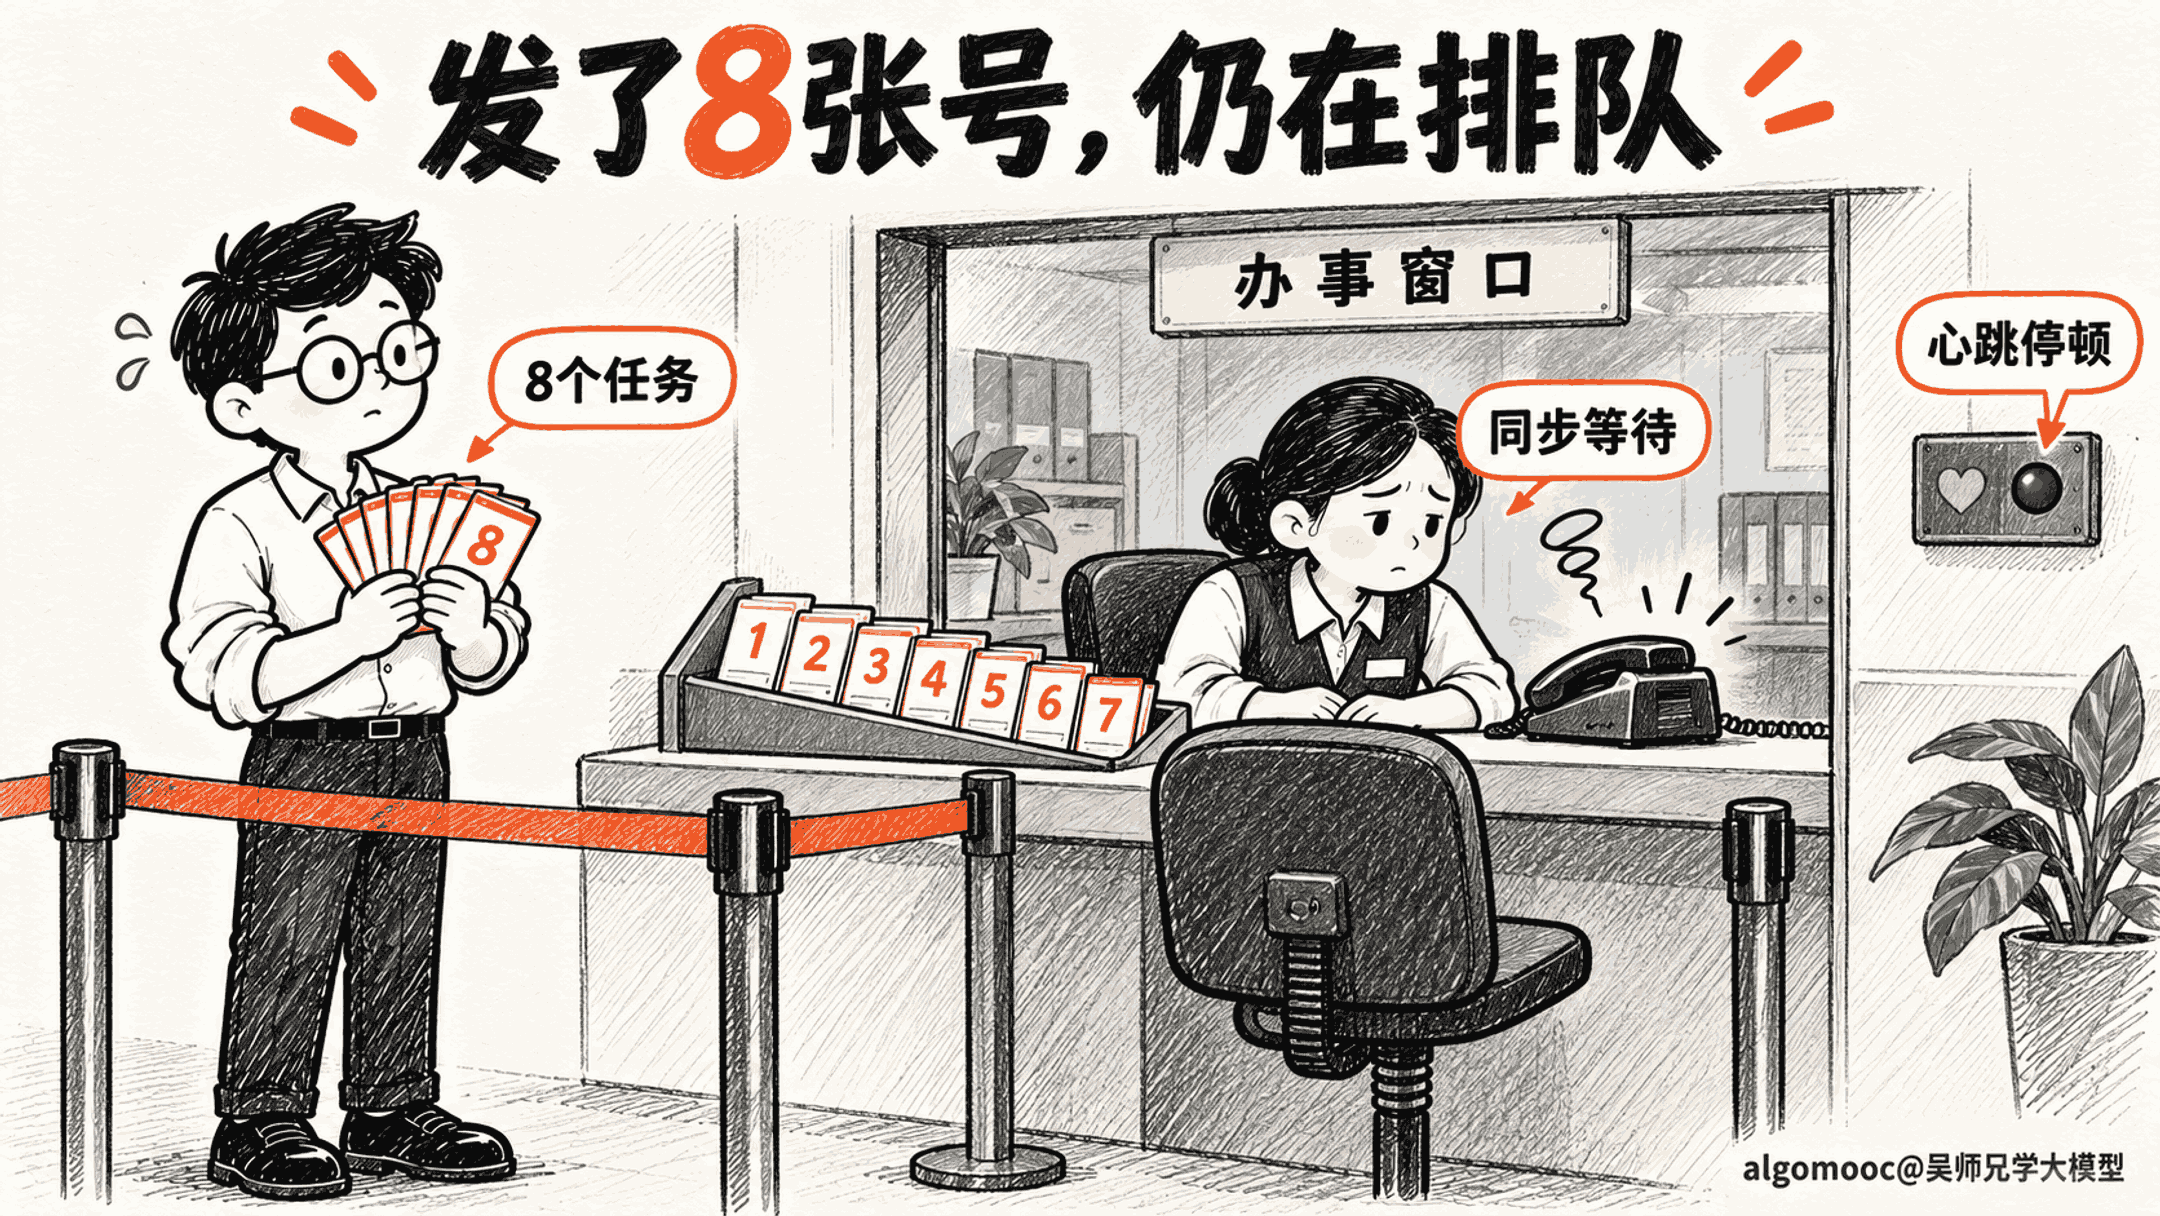
这时最容易改的是配置:把并发数从四调到八,再调到十六。但如果第一条研究任务一直占着事件循环,后面的任务没有机会执行,增加号码牌并不能让窗口同时接待更多人。
准备DeepResearch项目面试,不能只指着函数前面的async说“这里做了并发”。更值得解释的是:任务在哪里交还控制权,真正的外部等待发生在哪个线程,并发上限约束了哪一层工作。
我们从一段课程实现出发,用八个固定的短等待把这件事观察清楚。研究任务返回预设报告,用可控等待替代搜索,让调度行为从模型输出和网络波动里单独显现出来。
先看那行没带 await 的研究调用
本地DeepResearch模块五材料中,研究综合框架创建多个研究协程,再用gather收集结果。单个研究函数的签名确实是异步的,函数内部却直接执行inference.run(question),这一行没有await。
再往里看,材料里的IterResearch推理器把run定义为普通同步方法,在循环中生成模型响应、执行工具,再推进下一轮。外层换成异步签名,并没有把这些内部调用改成可挂起的异步等待。只要其中存在同步阻塞,事件循环就会跟着被占住。
gather会安排协程执行,但不会替普通同步函数自动创建工作线程。事件循环执行到第一个研究协程时,如果它一路调用同步方法直到返回,中间没有真正挂起,其他研究协程只能等。看到“创建了八个任务”,还不能断定“同时执行了八个研究”。
这段材料还设置了max_workers,默认值为四。但在展示的完整类中,它只被读入属性,后续没有用于创建执行器,也没有参与获取并发名额。即使前面导入了线程池类型,导入本身也不会启动线程池。配置名称写得像限流,不等于运行路径已经受限。
排查时先沿着调用链看实际等待点,而不是先改函数名。也不能机械地在同步调用前补一个await:同步函数会先执行,阻塞照样发生;若它返回普通字典,这个字典还不能直接被等待。修复需要改变等待的执行方式。
一个研究分支通常不止等一次:模型生成之后可能搜索,拿回内容以后又生成下一轮。检查要沿着这些实际调用继续走。顶层研究函数支持异步,内部某个工具仍然同步等待,照样可能造成长时间停顿。把gather换成create_task,也不会自动改变那个工具的执行方式。
八个短等待,把心跳也拖停了
我给八个模拟研究任务各安排一次40毫秒等待,输入编号和输出报告完全固定。另开一个事件循环心跳,计划每5毫秒记录一次时间。每个研究任务开始和结束时也记录时间,并更新活跃计数。
这里的活跃,指已经进入模拟研究、还没有结束,包括等待结果的时间。它不是CPU正在计算的线程数。这样既能看任务之间有没有重叠,也能观察研究执行时,事件循环是否还在处理其他工作。