一条售后任务,希望 Agent 先查客户的订单,再判断这次诉求对应哪一次购买。离线评分要认定它是否选对对象,数据里因此保存了目标订单号。组装提示词时,如果顺手把整份任务对象转成 JSON,模型可能还没查工具,就已经看到了这个编号。
调用过程随后可以很完整:查订单、查政策、给出回复。可这条轨迹回答的问题已经变了。原本想观察它怎样发现候选、核对对象,现在给它的是一个已经指定目标的任务。最后答案正确,也不足以说明前一项能力经过了检验。
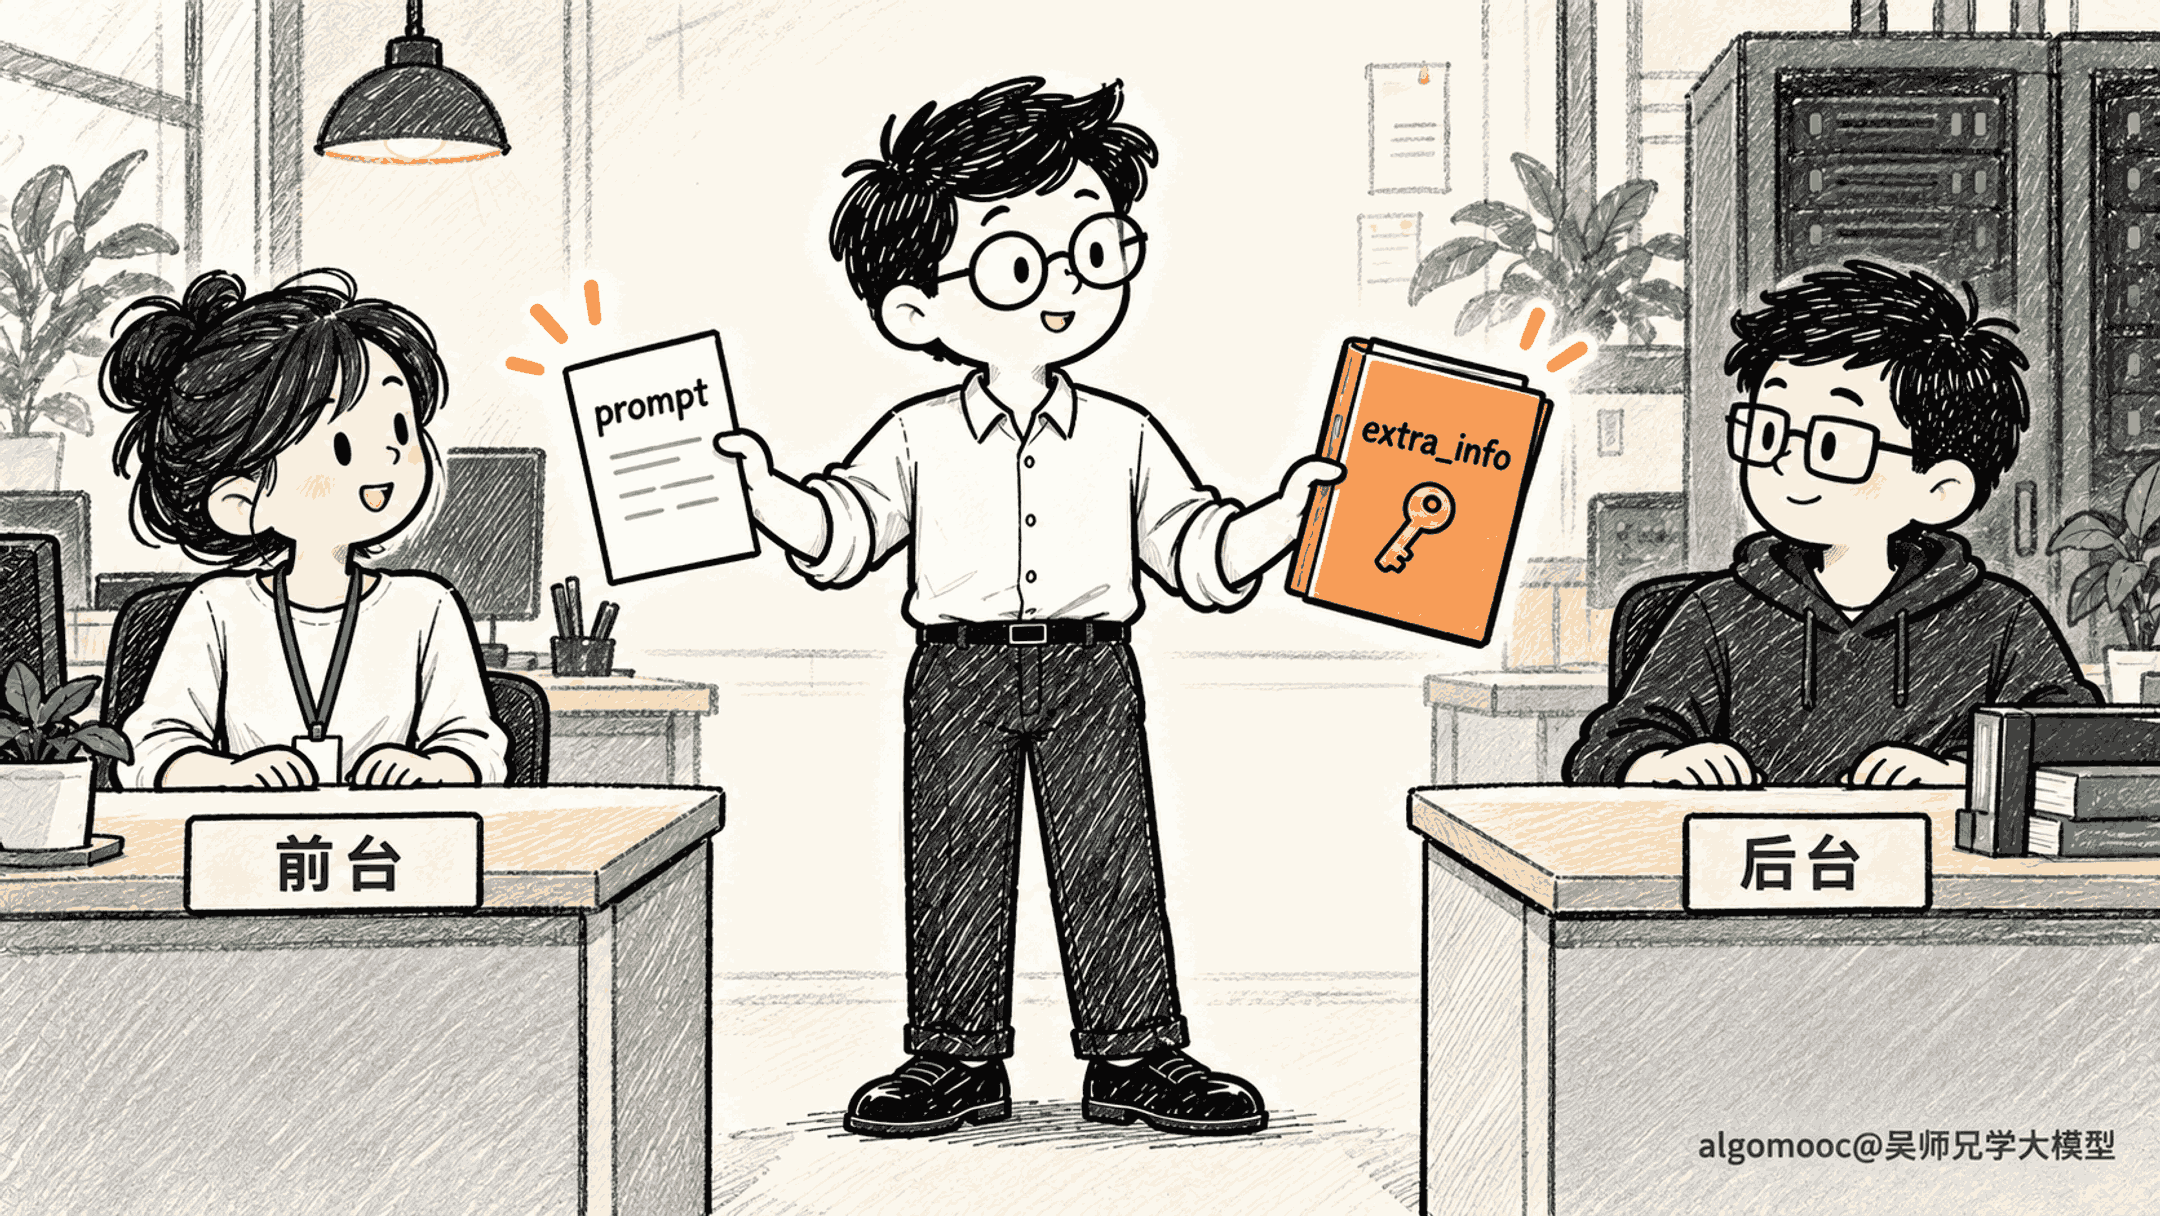
这类问题发生在单次任务的输入边界上。评分端为了判断结果,需要掌握更多信息;模型起步时应该知道什么,则要按真实使用场景另外定义。两份材料共用一个数据容器,不能省掉这一步区分。
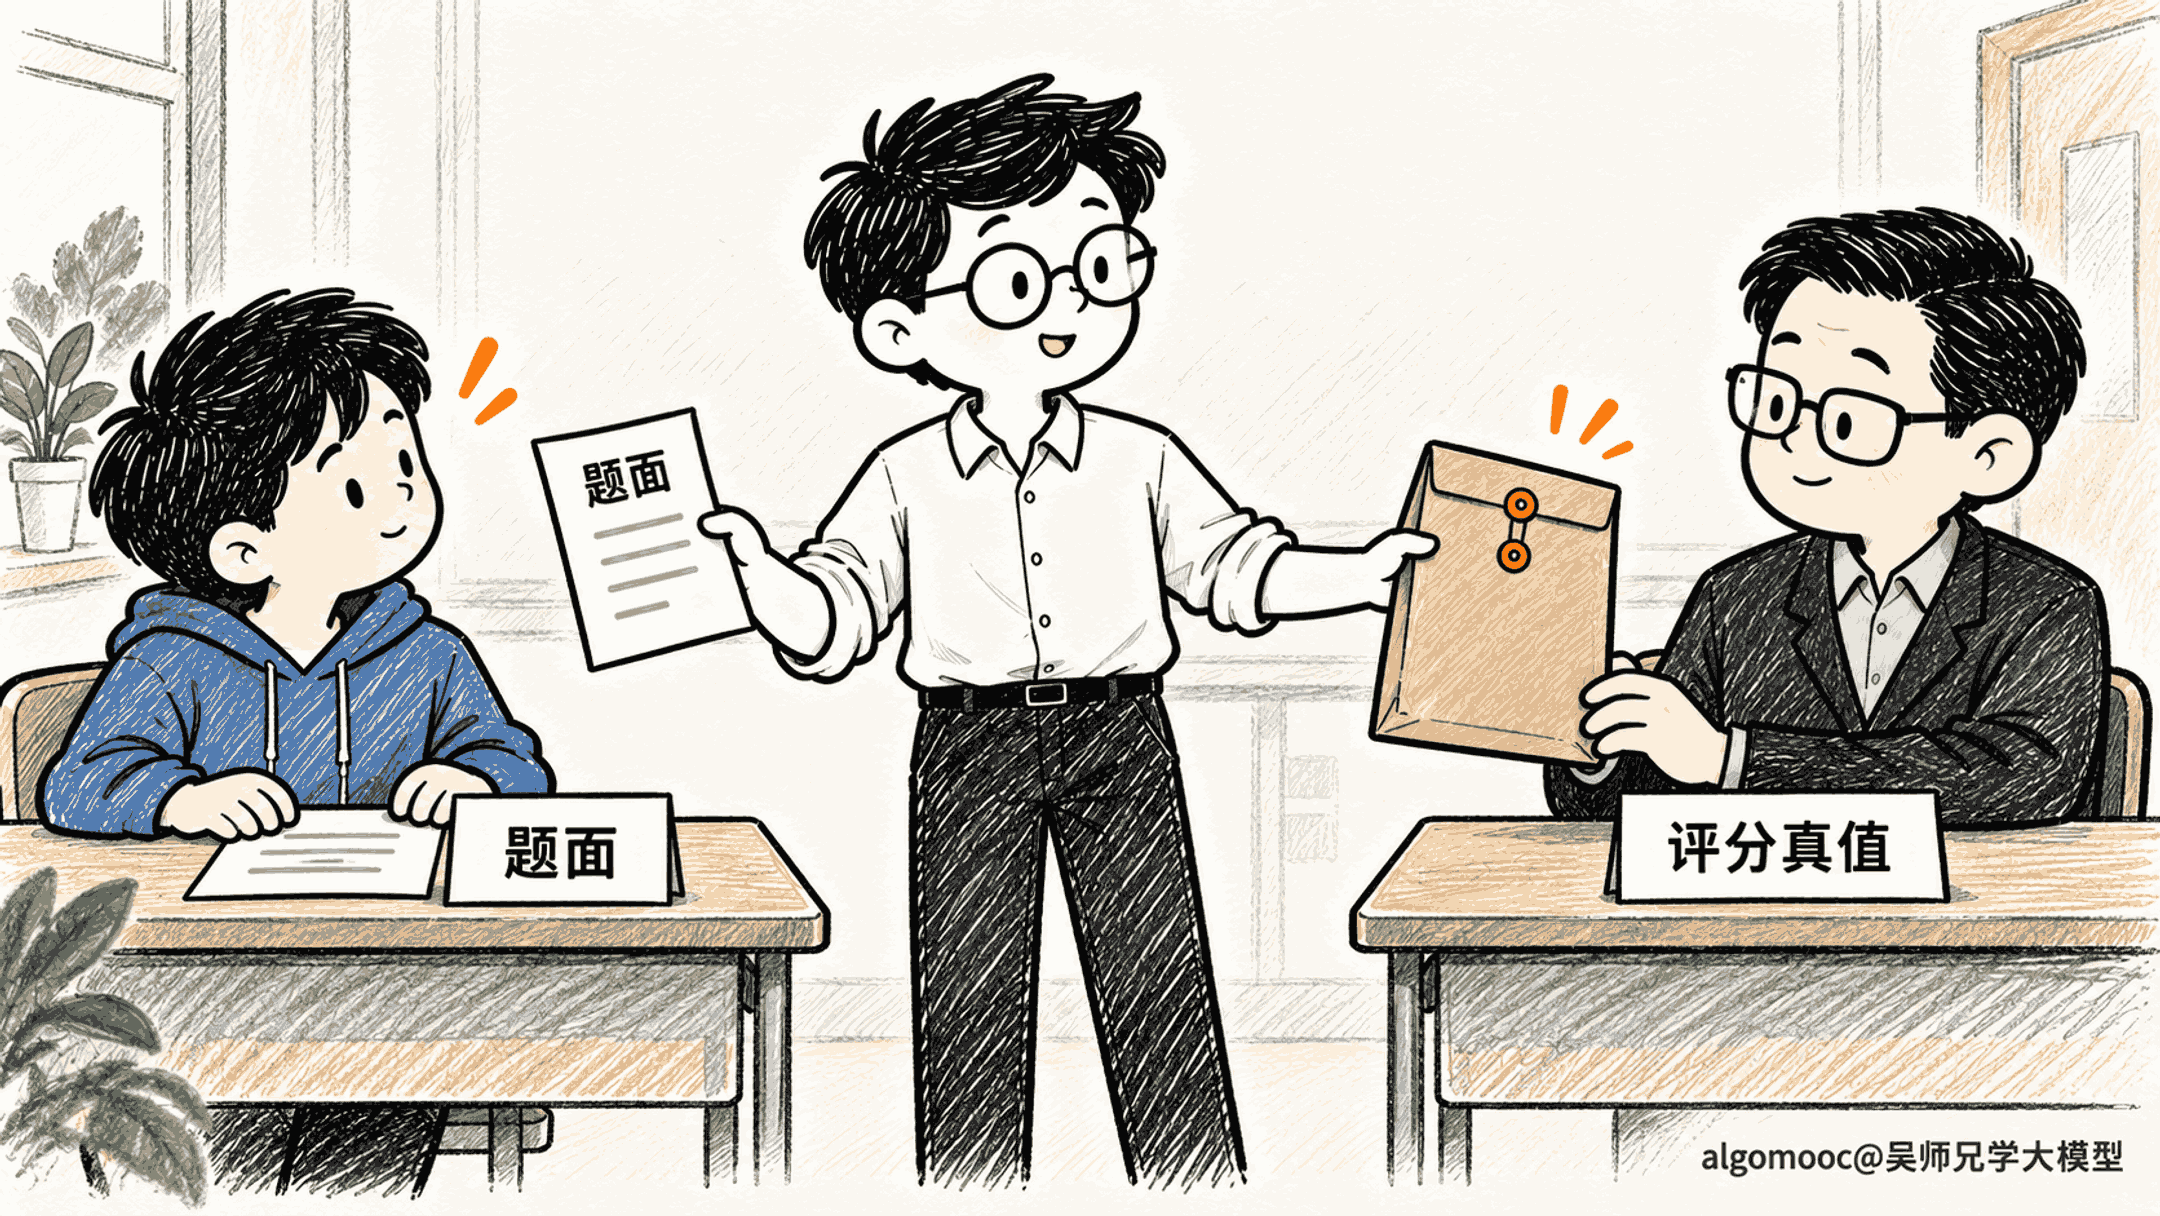
先定义题面:这次请求允许知道哪些信息?
同样是订单查询,可以有两种合理起点。客户已经提供订单号,或当前会话已经绑定订单,模型直接使用它,符合场景。如果任务要求从客户信息与诉求中寻找候选,就应把发现过程留给工具查询;不能为了方便评分,把后台选定的目标提前补进去。
这里要区分信息的来源与取得时机。订单号可以成为合法工具结果,也可以是客户明确提供的条件。需要防的是评分用的信息越过约定,被提前当成已知条件。把所有与答案有关的字段一概删除,同样会改变任务。
先写清在线输入,再组织离线数据,会比较容易判断。客户身份、区域、原始诉求属于哪一侧?目标对象、期望政策、用来核验的环境记录又属于哪一侧?字段存在于数据包里,只能说明系统保存了它,尚不能说明应当展示给模型。
边界还要容纳不确定性。查到多个候选、现有信息不足以唯一定位时,任务可以要求继续核对或澄清。评分端知道目标,并不意味着模型当时也具备足够线索。若题面缺少本来允许提供的条件,也应修正题目,而非让模型凭空猜出后台编号。
如果评估的重点只是给定订单后的政策判断,直接提供订单号可以成立;如果重点包括寻找订单,就不能据同一份输入宣称发现能力也被测过。输入边界实际上参与定义了要检验的能力,不能等模型已经跑完,再根据漂亮的结果补写这个目标。
原代码留下五个入口,拒绝便捷兜底
当前 S5 训练代码里,任务对象同时服务运行端和评分端。评分辅助函数能按 entities 中的标识定位环境表,取得本题需要核对的记录;这条真值解析路径与模型题面生成分开。
首轮题面使用 _case_context。它固定构造会话标识、客户标识、订单号、区域和客户消息五个字段。读取某个可见值时,先查 agent_facing,再查 visible_context,最后兼容任务顶层的同名字段。
这里有个很关键的停止位置:没有从 继续兜底。模型可见区域没有订单号,就不会因为评分实体里恰好有一个而自动补上。附件、退款、物流等内部标识,也没有被整包复制进这五个入口。