Agent 调用查询工具,返回了一条失败消息。看训练日志时,最容易顺手做的统计,是把这次失败记成一次模型错误:工具没查成,模型当然没做好。
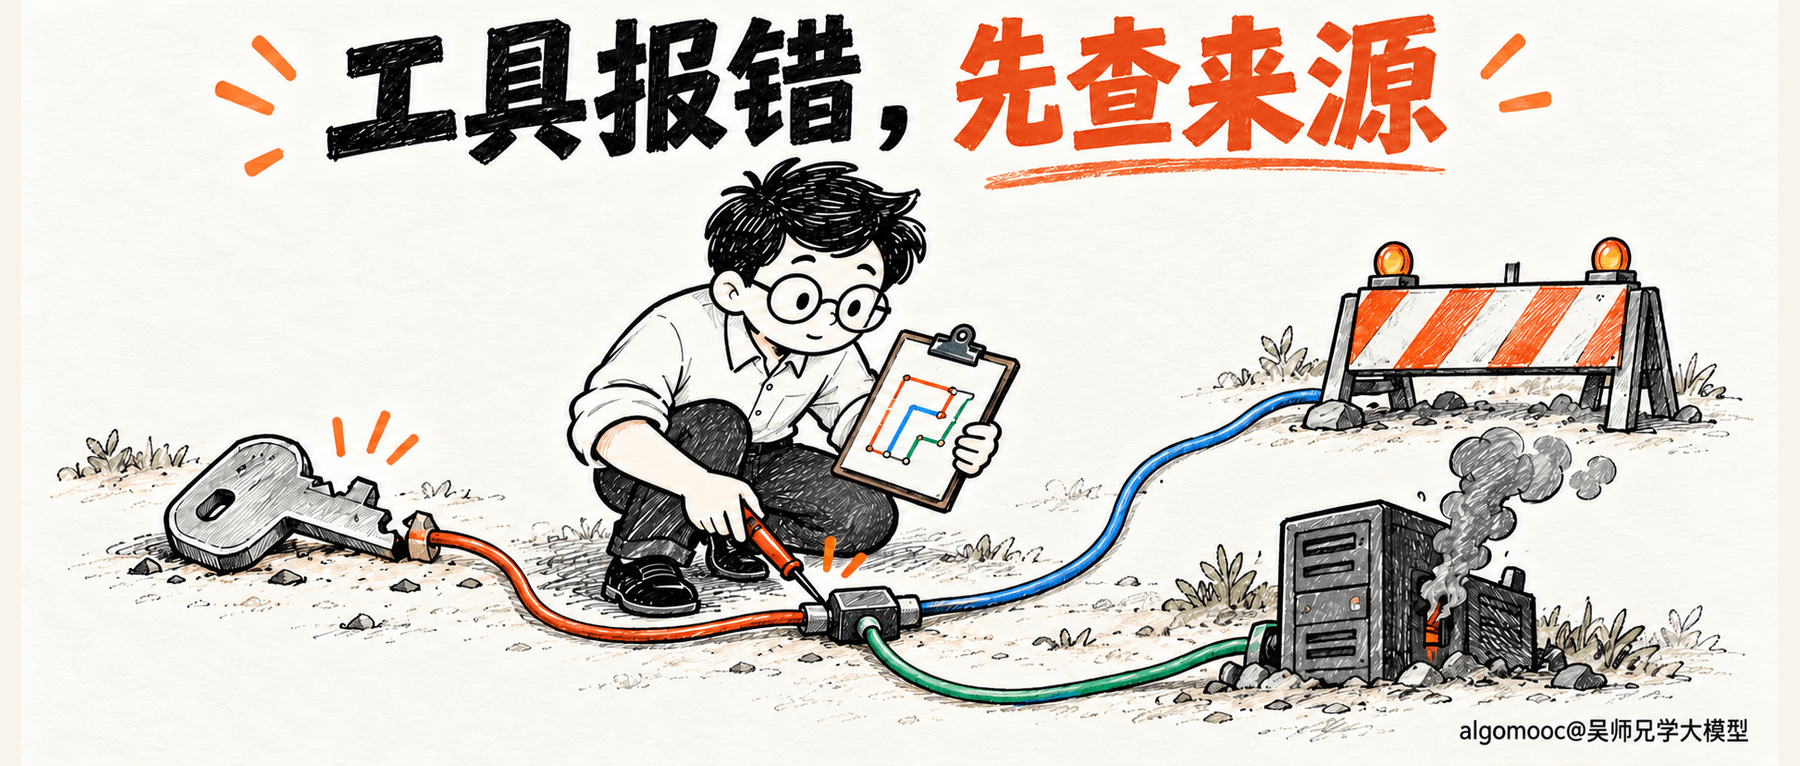
可同一盏红灯背后,可能是调用少了必填参数,也可能是环境故意注入了故障,还可能是工具内部抛出了运行异常。三次调用都失败,下一步该改的东西却不同。漏参数需要检查模型生成与工具契约;环境故障要检查服务和恢复策略;运行异常需要沿执行路径查实现。只按失败次数扣分,会把这些问题揉在一起。
做 Agent 训练时,可以先查清楚“这条错误是谁写下的,凭什么归到模型身上”,再讨论如何计分。沿当前 S5 训练代码里的一条工具执行链,可以看到来源标签的生成与使用。
失败回执的排查入口:先对上执行路径
这里的工具执行器叫 ToolFactory。它把不同工具包在同一套执行入口下:取出工具定义,校验调用参数,检查环境故障配置,再进入实际处理函数。无论成功还是失败,回执都带着工具名、参数、调用标识和所属命名空间,方便回到对应的一次执行。
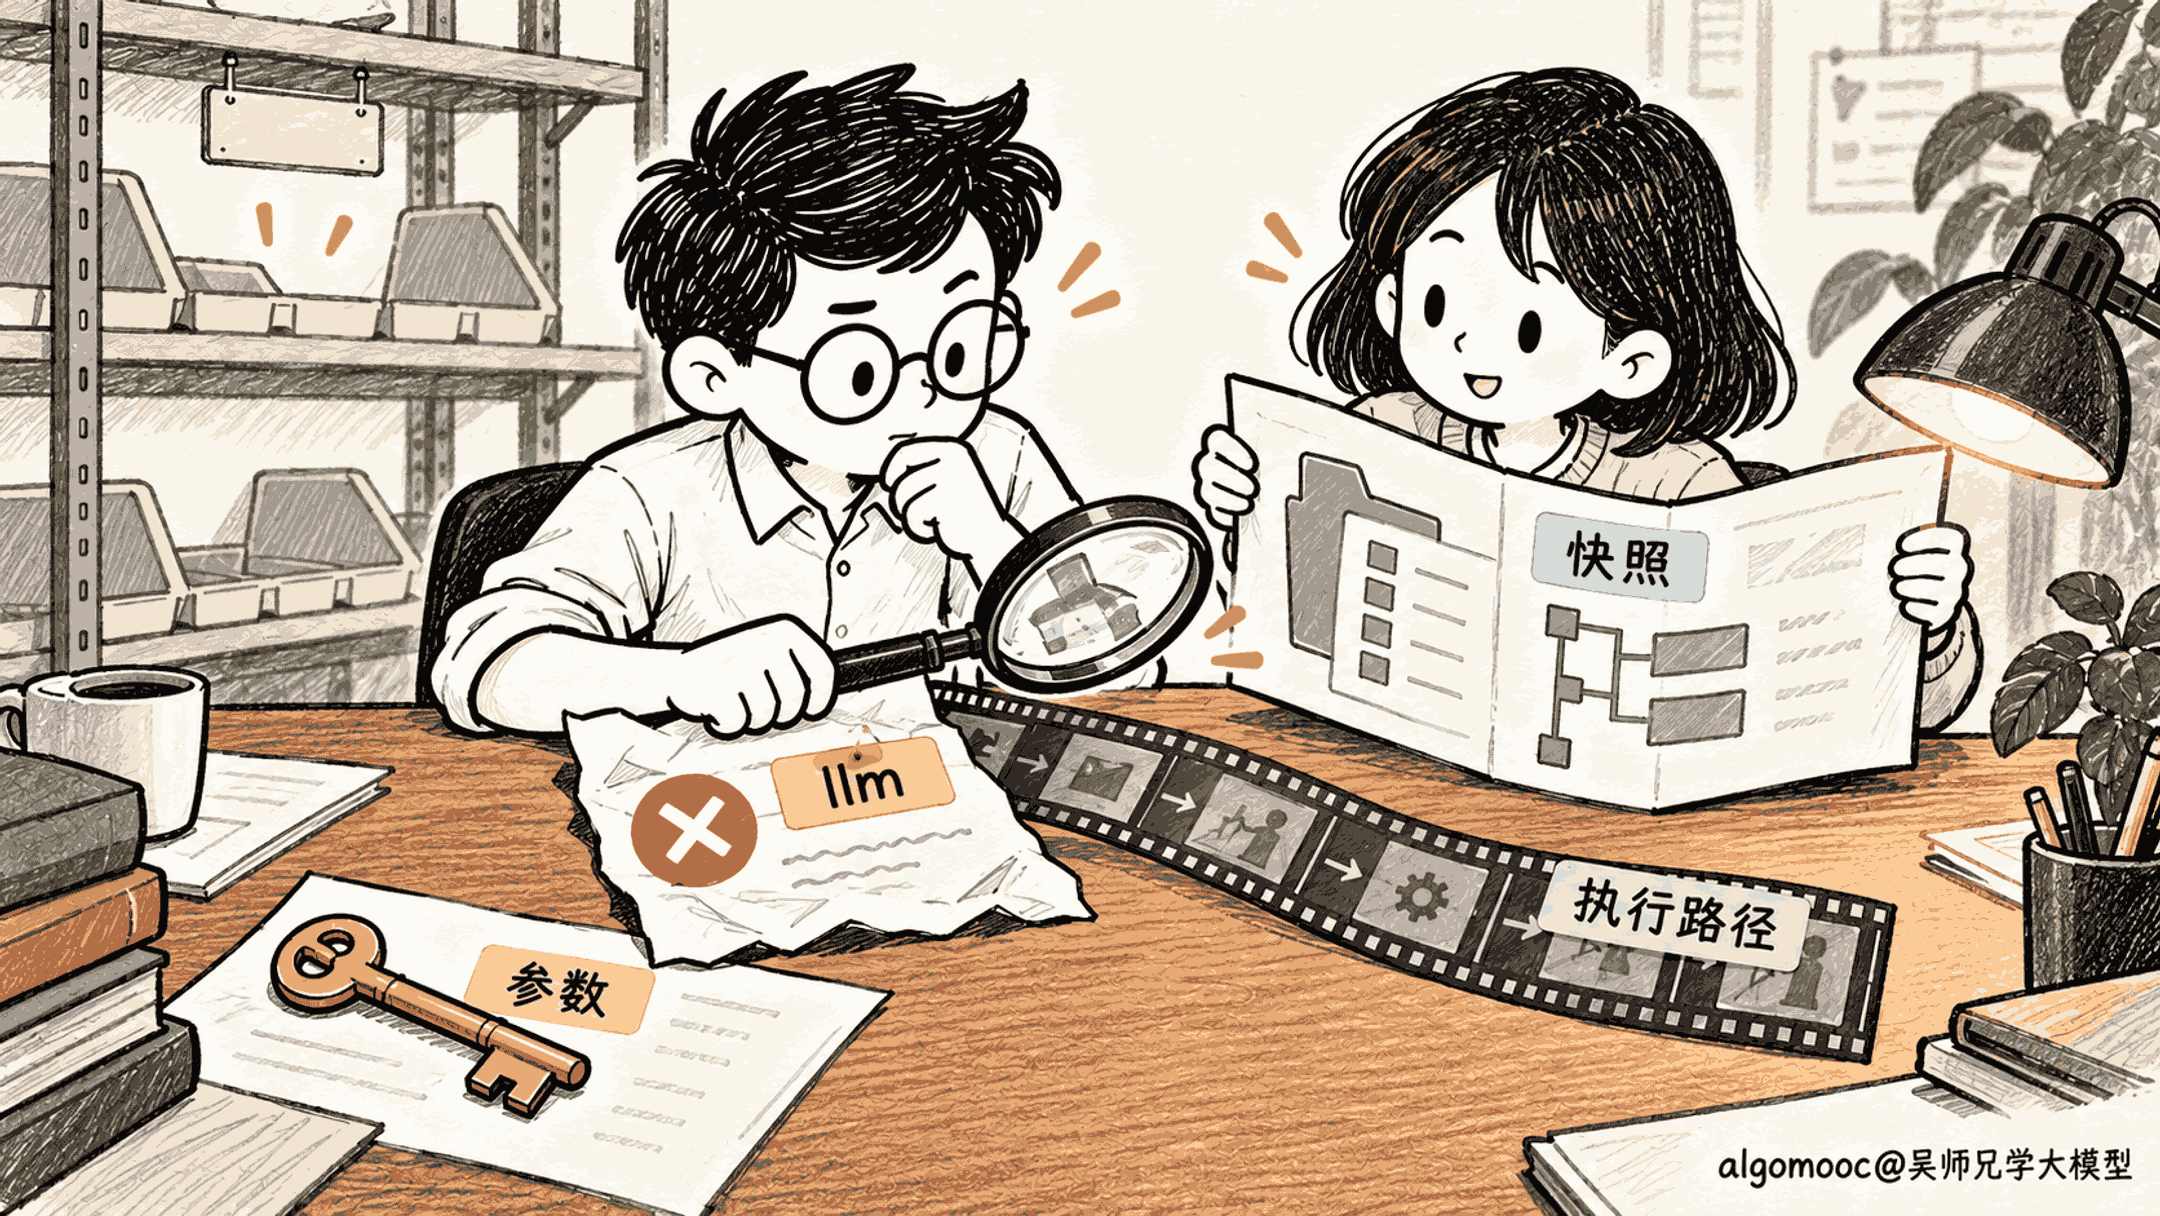
失败时,回执里的 ok=False 表示这次调用没有成功。错误码解释发生了什么,消息补充可读信息,source 则记录项目怎样归属这次错误。这三个层次要分开看。“订单没找到”是现象,“哪个订单号、查哪份快照、在哪一步失败”才是继续核对责任的入口。
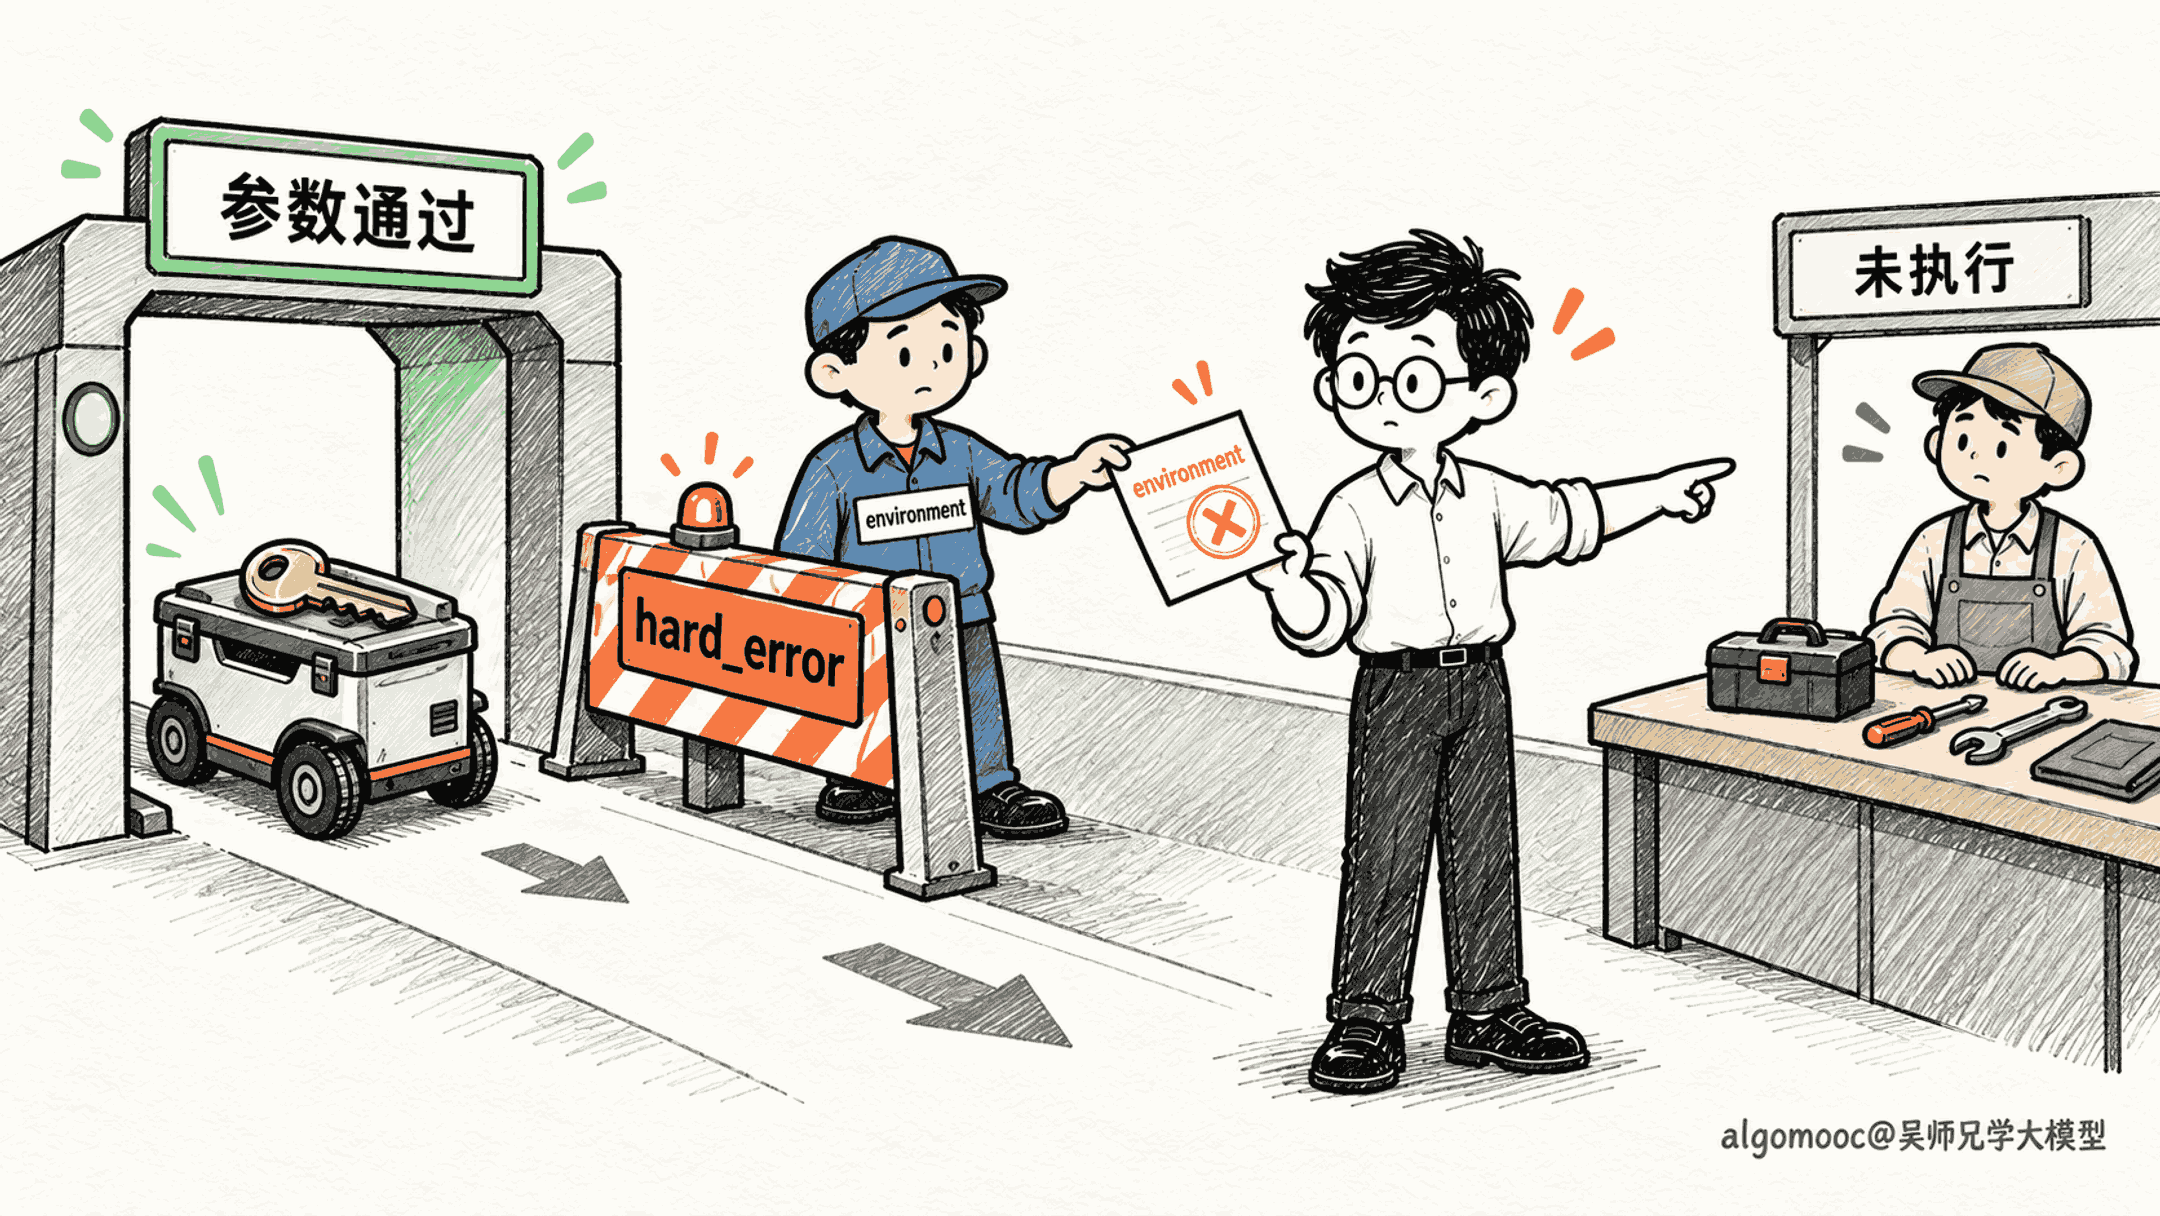
尤其要保留执行顺序。同一份环境配置里存在故障,不表示每次失败都由故障触发。参数校验排在故障注入之前,漏了参数的调用还没走到环境那一步,就已经返回了。忽略这段顺序,容易拿环境问题替一条本来就无效的调用作解释。
核对时,还要把请求与回执连起来。一条错误码可能在不同调用中反复出现,只有确定它对应哪次参数、哪份运行上下文,才能判断失败发生在入口还是执行中。把多条轨迹的最后一条报错拼到一起,往往会丢掉这个位置关系,随后再详细分类,也是在分类已经混淆的记录。
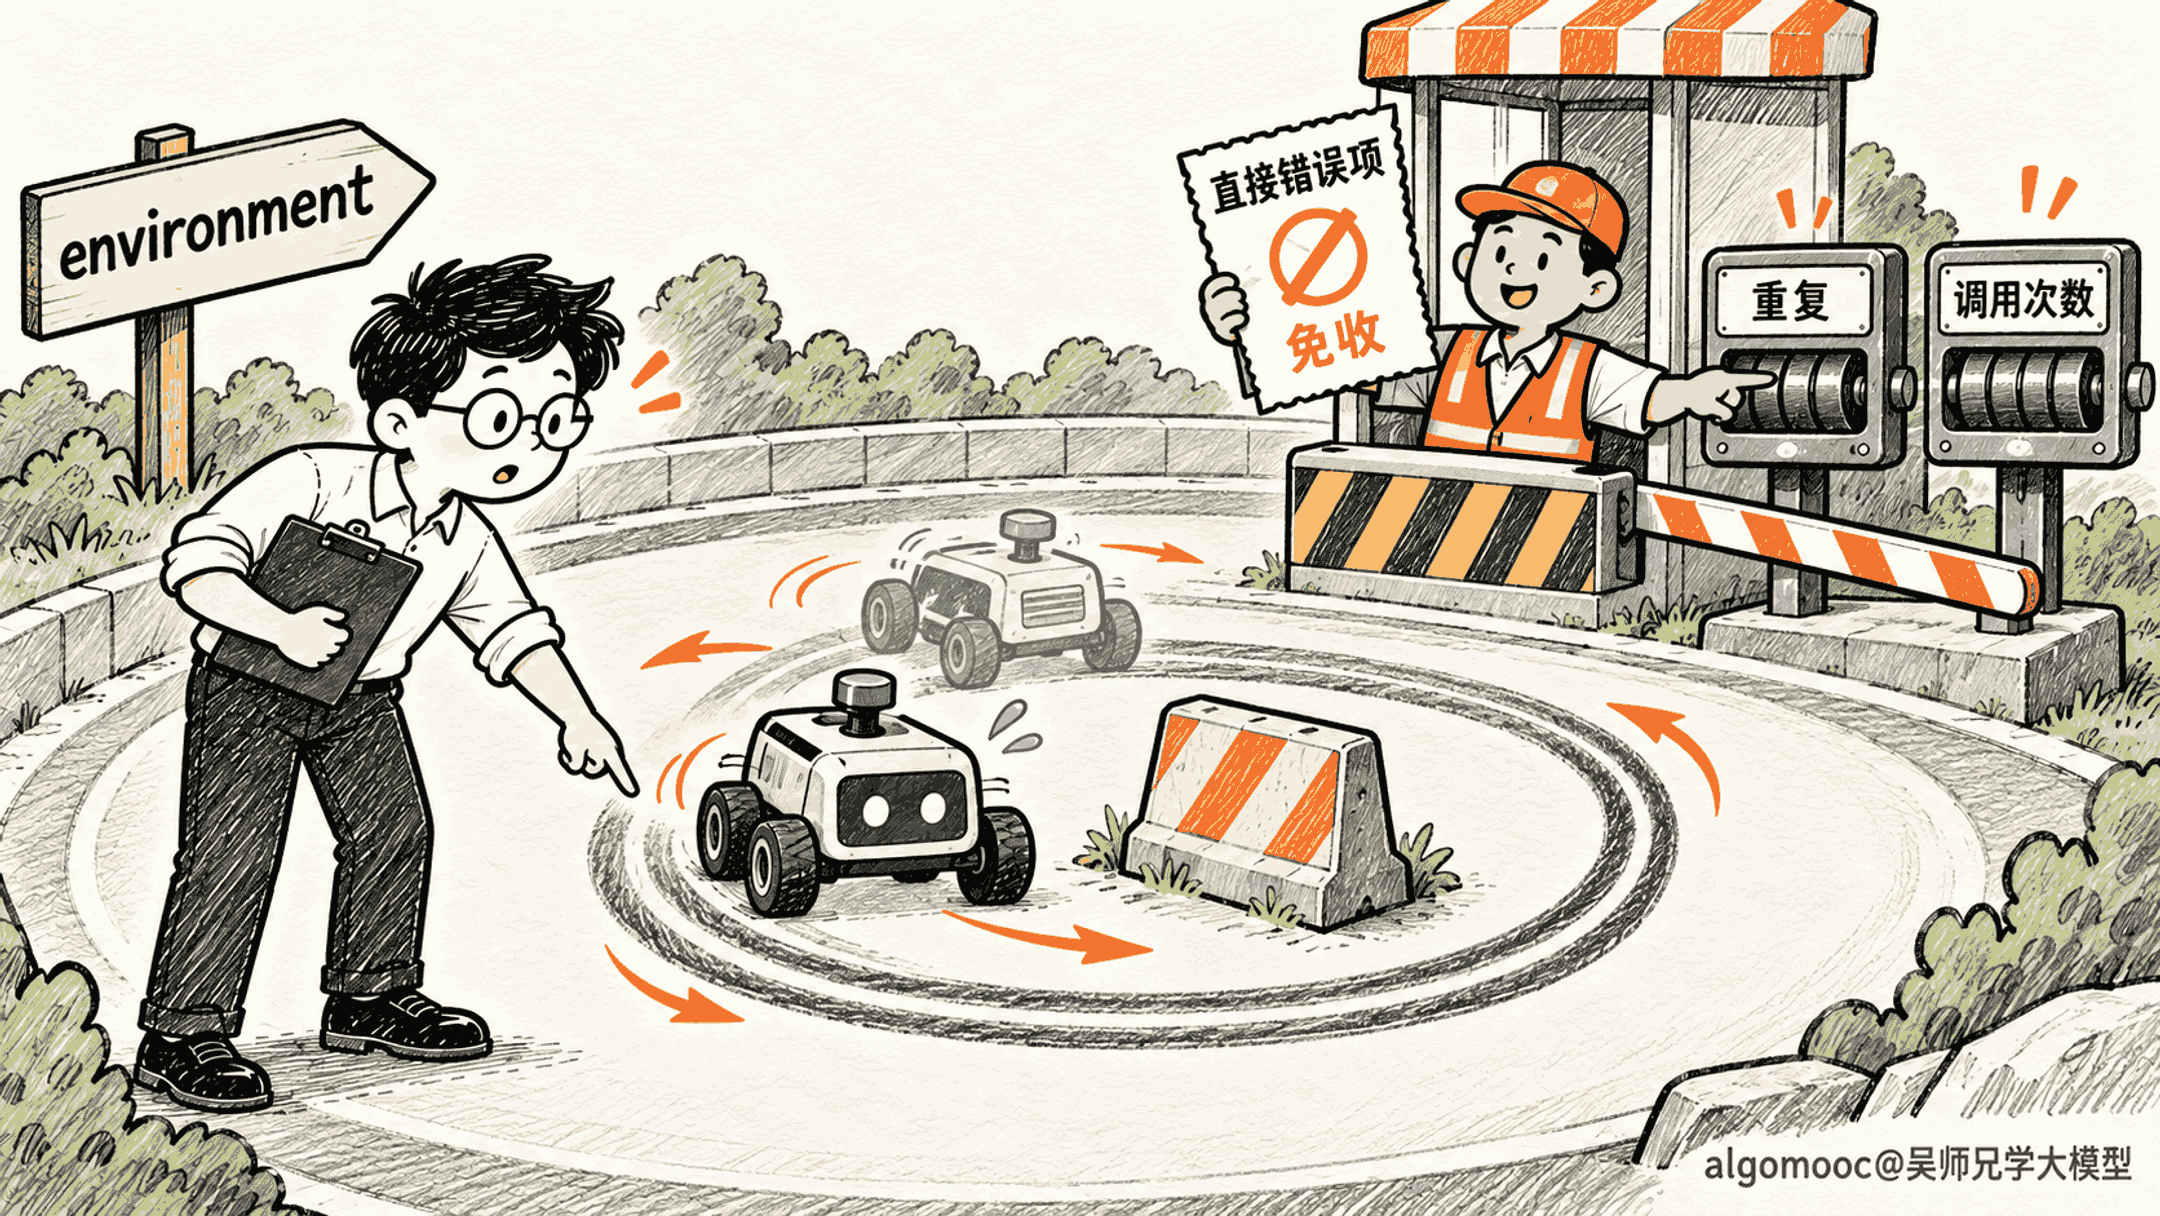
后续运行循环会把失败回执原样加入 tool_errors。下游可以继续读取其中的错误码、来源和调用关联信息。执行端怎样写入这些字段,会直接影响后面的统计口径。
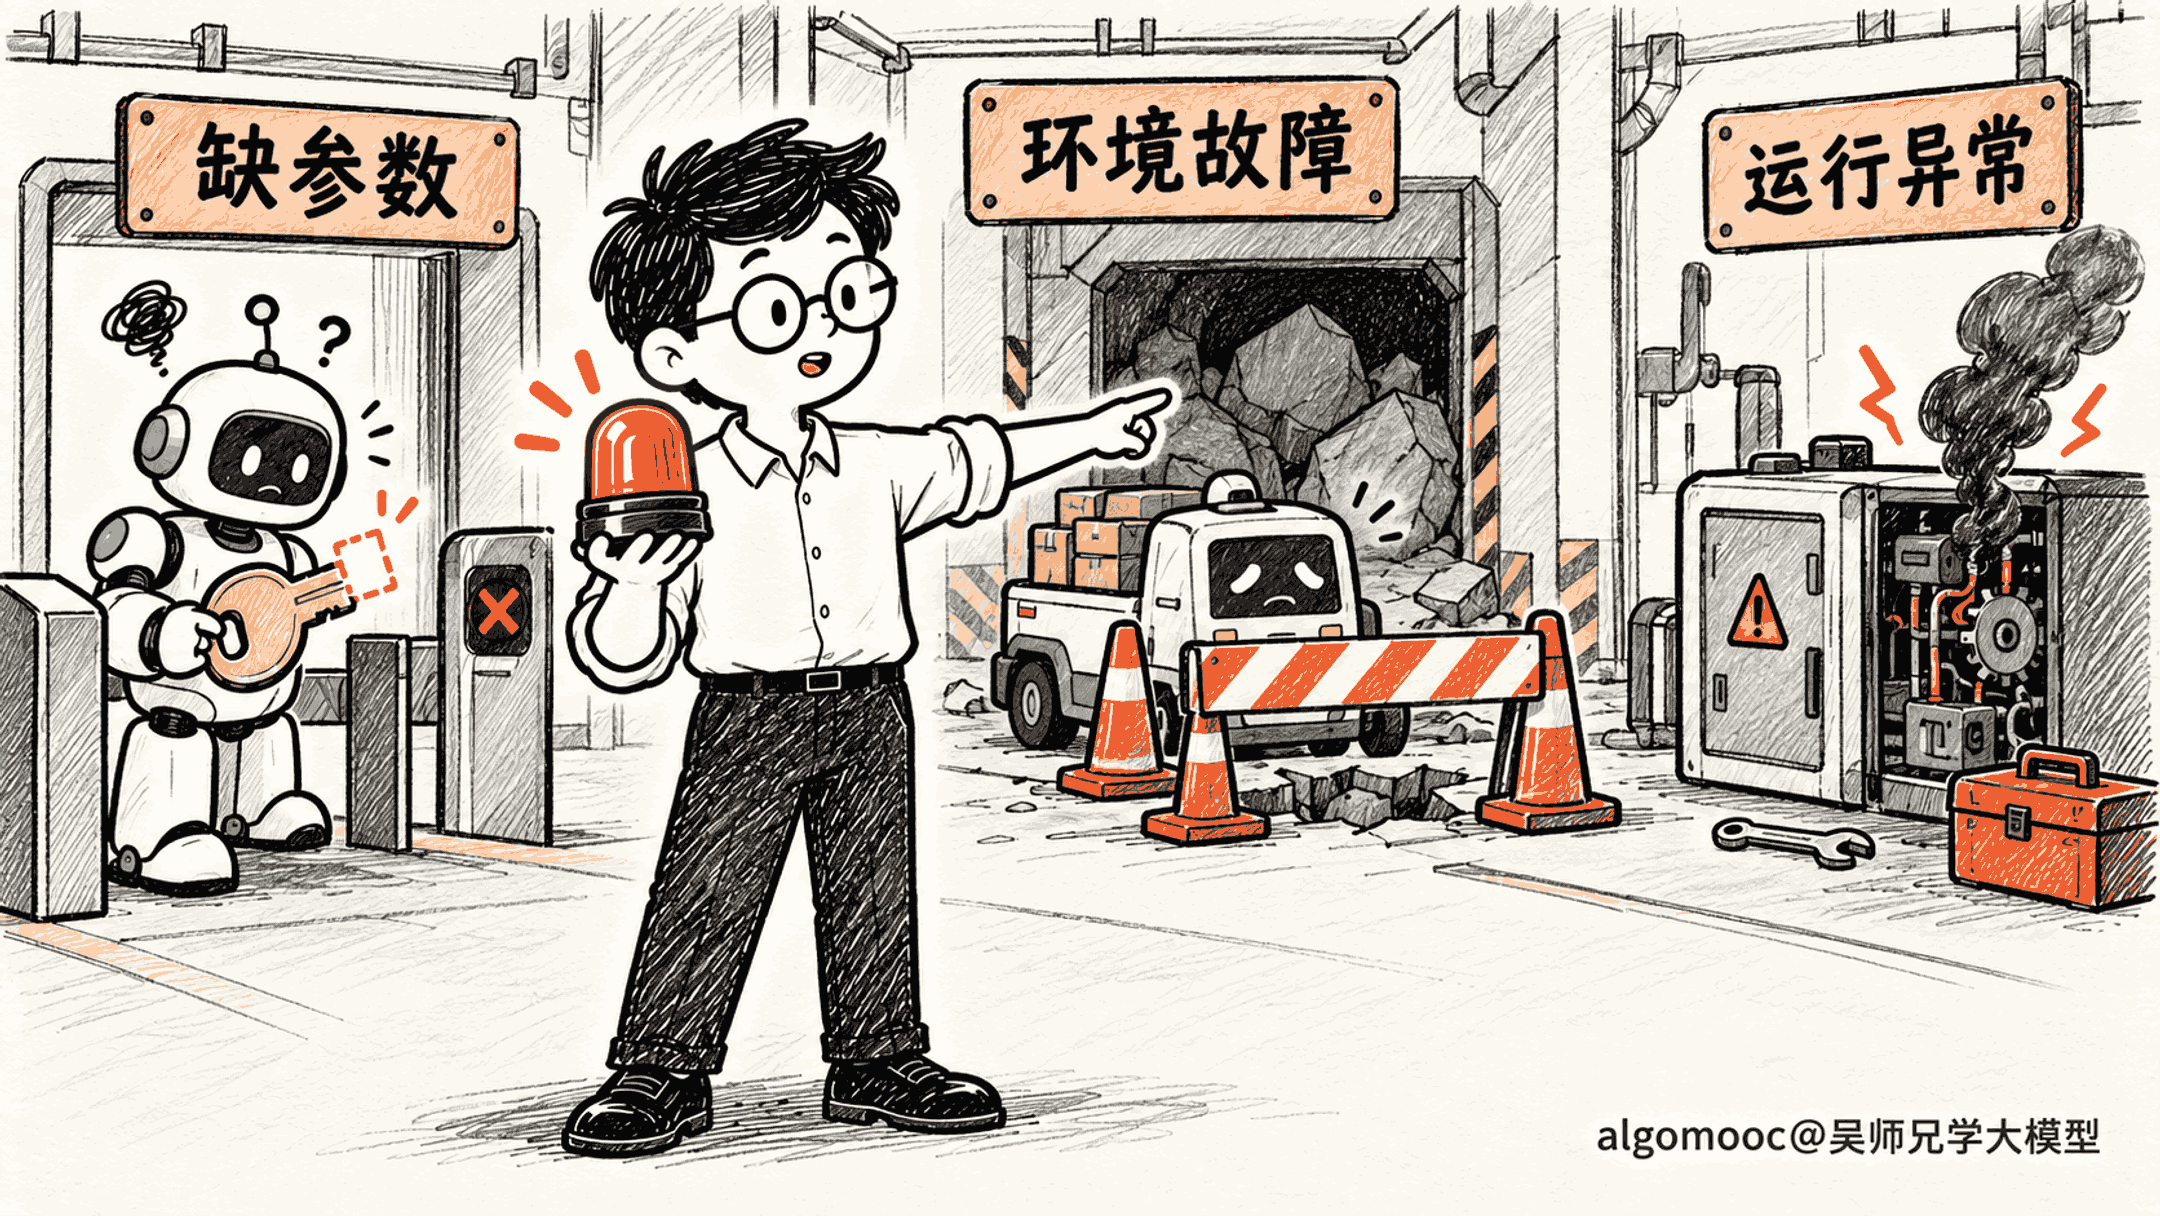
原代码怎样写下三种错误来源
先看缺参数。工具声明了必填的订单号,调用却没传,校验会抛出结构化错误。这类错误的 source 默认是 llm。在这个实现里,调用没有满足工具要求,被记入模型一侧的错误。
再看环境注入。参数通过校验后,执行器读取环境快照中的故障配置。如果当前工具配的是 ,执行器直接构造失败回执,明确写入 ,随后返回。真正的处理函数根本没有开始运行,所以不能把这次故障描述成处理函数执行到一半崩了。