假设你在训练一个查库存的 Agent。用户问某款设备还有几台可用,模型先生成查询调用,工具返回“可用数量为三台”,模型再据此回答。
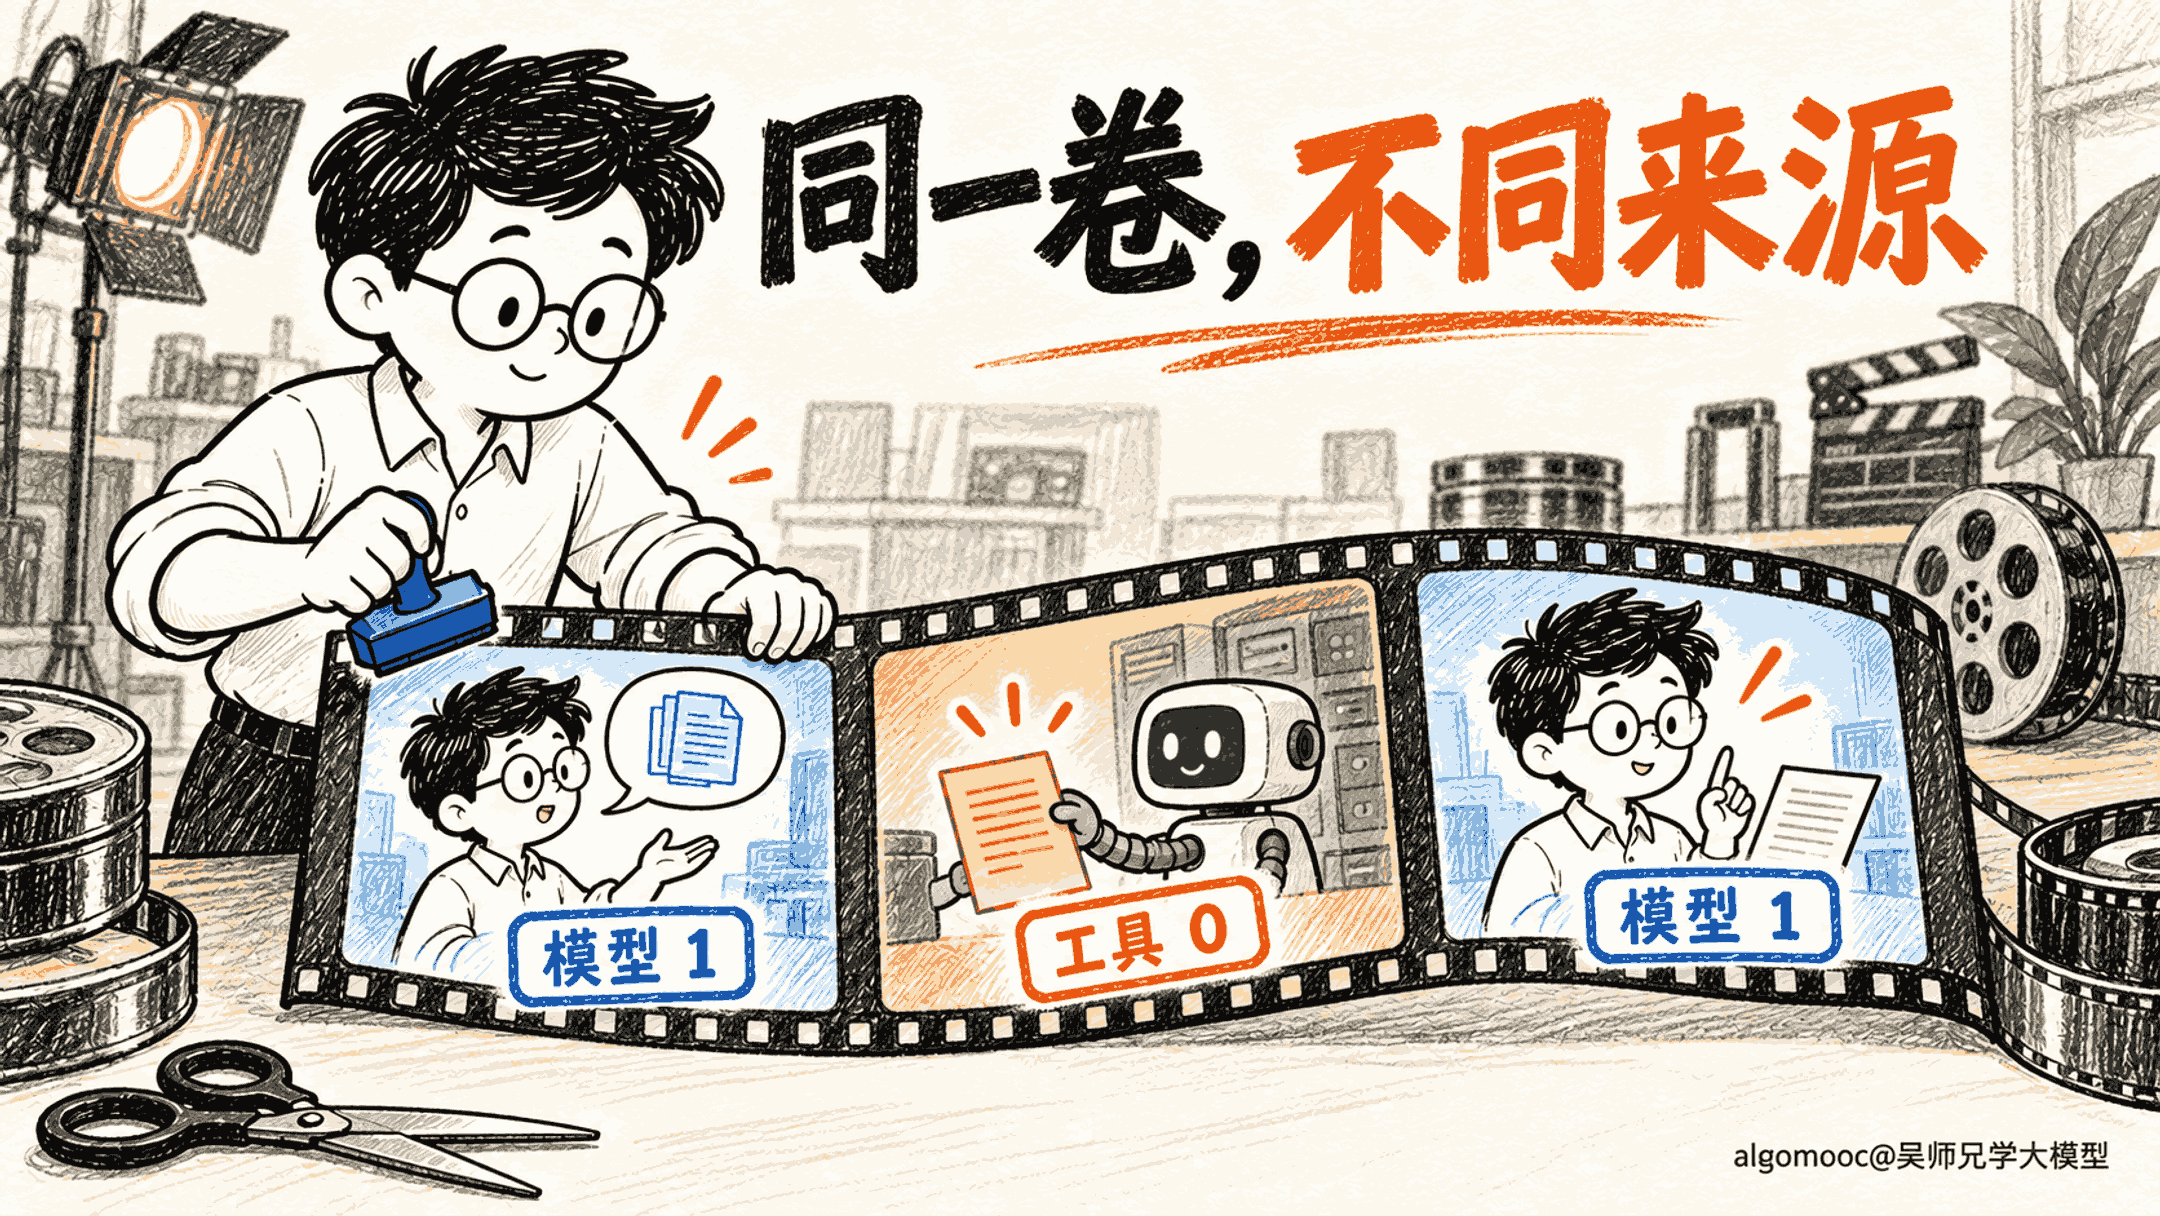
把这段交互展开,会看到模型调用、工具返回、模型回答连续排在一起。训练接口把它们装进同一个 response 序列,名字又叫“响应”,于是很容易把整段都当成模型生成,统一标记为参与训练。
问题就出在这里。库存结果来自环境,模型需要读它,才能完成下一步回答;但这段结果并不是模型刚才采样出来的动作。它进入上下文,与它是否作为本次策略更新的直接生成目标,需要分别处理。
这类 Agent 的 Mask,要同时保住两件事:工具结果仍是可用上下文,参与策略更新的位置准确对应模型自己的生成。 只盯着一串零和一,或者只检查最终回答,很难判断接线是否正确。
一条 response,装着不同来源的内容
先看这份本地 Agentic RL 适配器。它保存了一条完整输入序列,用来继续向模型发起生成;同时保存首轮提示之后展开的内容,作为返回给训练侧的响应序列。
第一轮模型生成查询调用,新增 token 被接到这两条序列末尾,对应的 response_mask 填一。工具执行完成,返回内容经过对话模板转换,也接到两条序列末尾,但对应位置填零。接下来模型生成回答,新位置再填一。
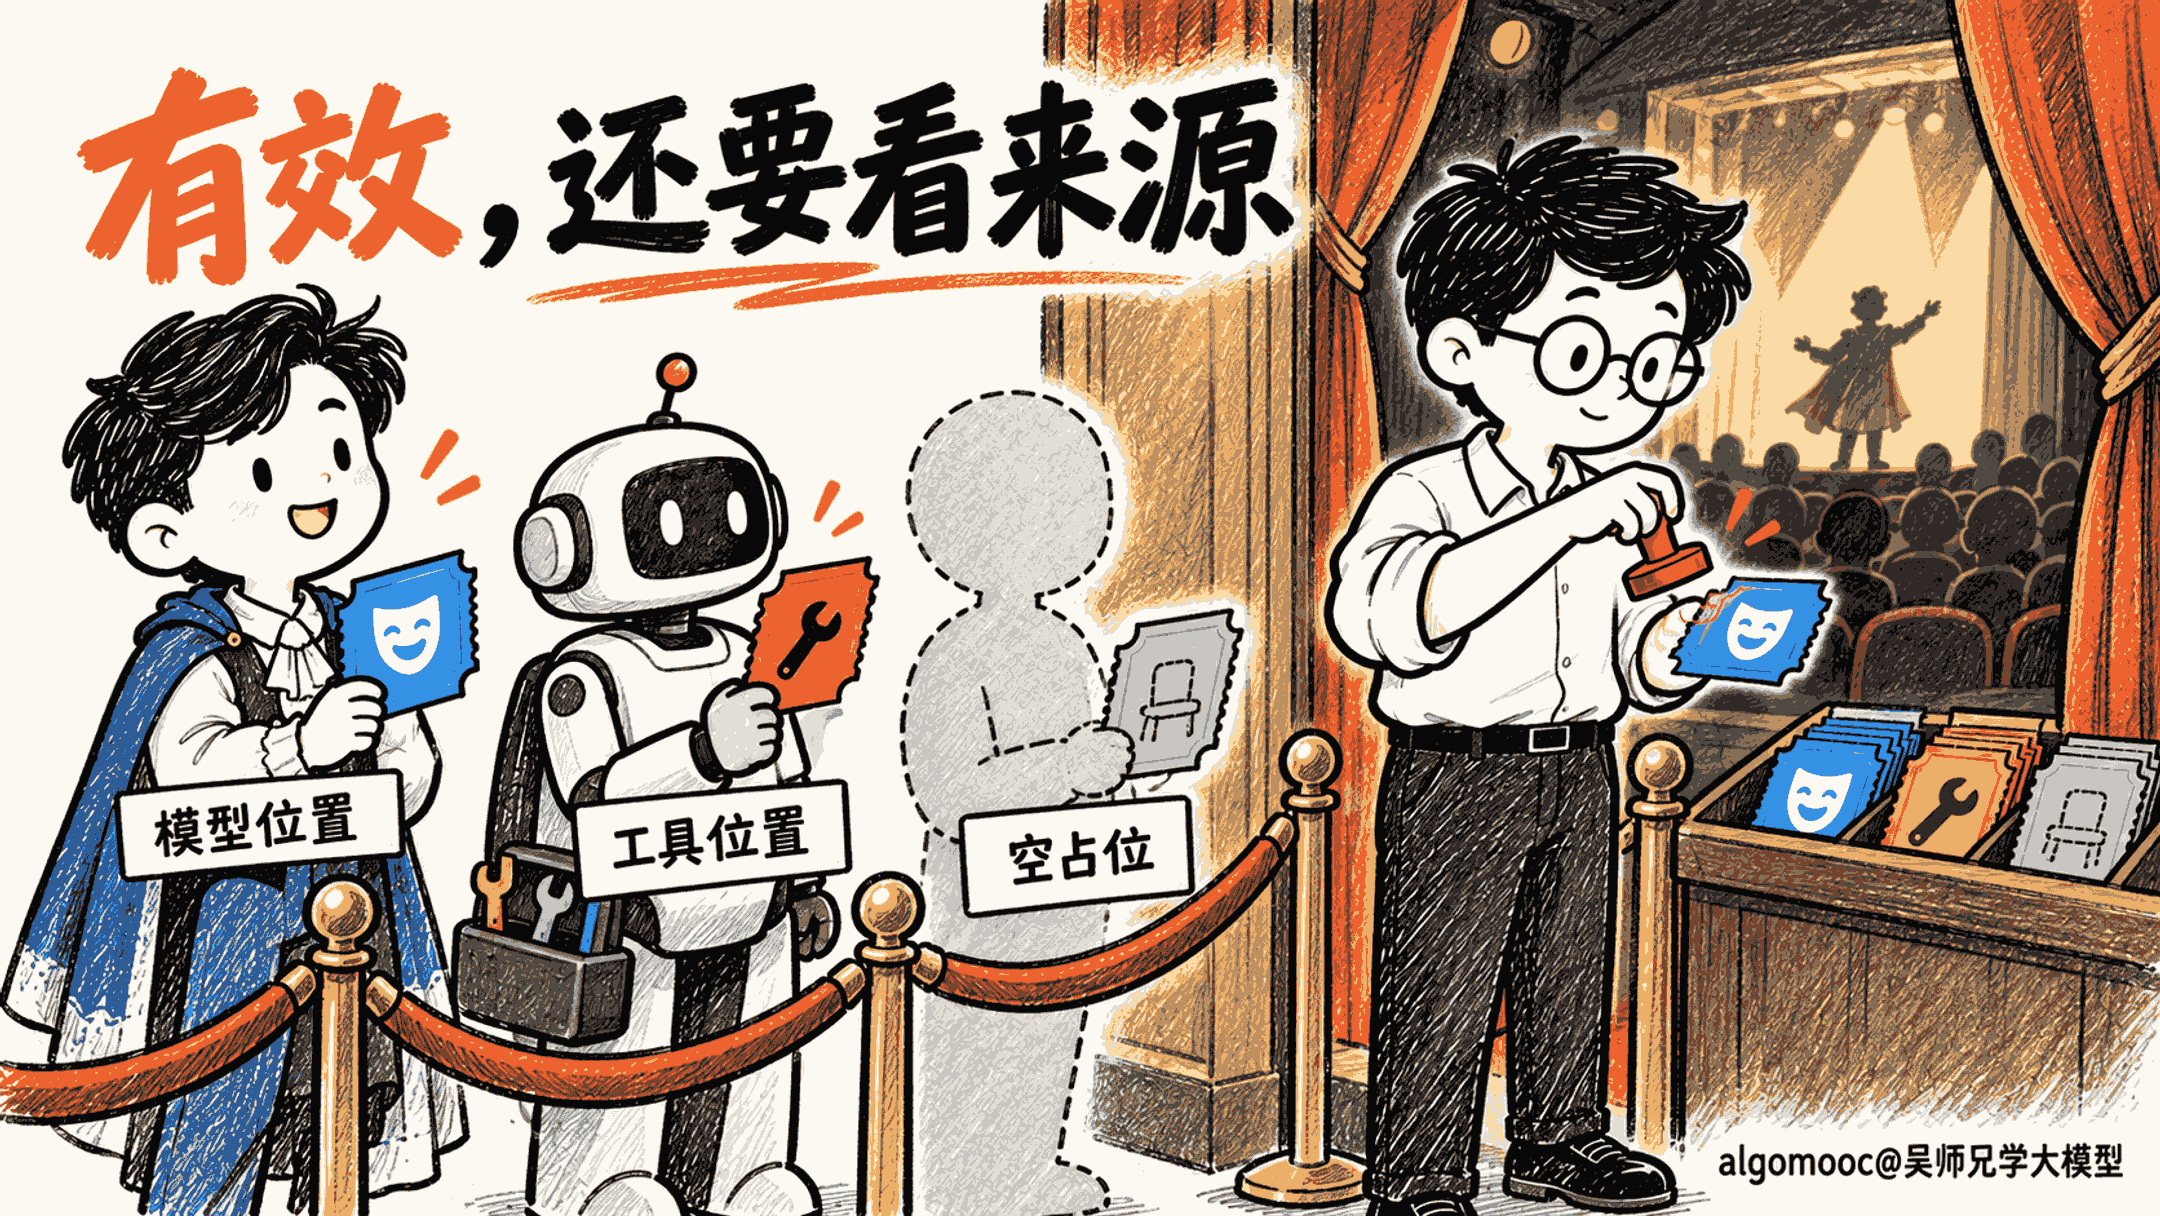
所以,响应序列可以同时包含模型和工具内容。它表示交互展开后的排列,不保证每个位置都由模型产生。训练侧不能只凭字段名判断来源,必须继续读取逐位置的标记。
这也解释了为什么不宜在最后统一补一串 Mask。多轮任务里,模型可能调用几次工具,工具返回长短又不固定。记录来源最清楚的时点,是每一段被追加进序列的时候。
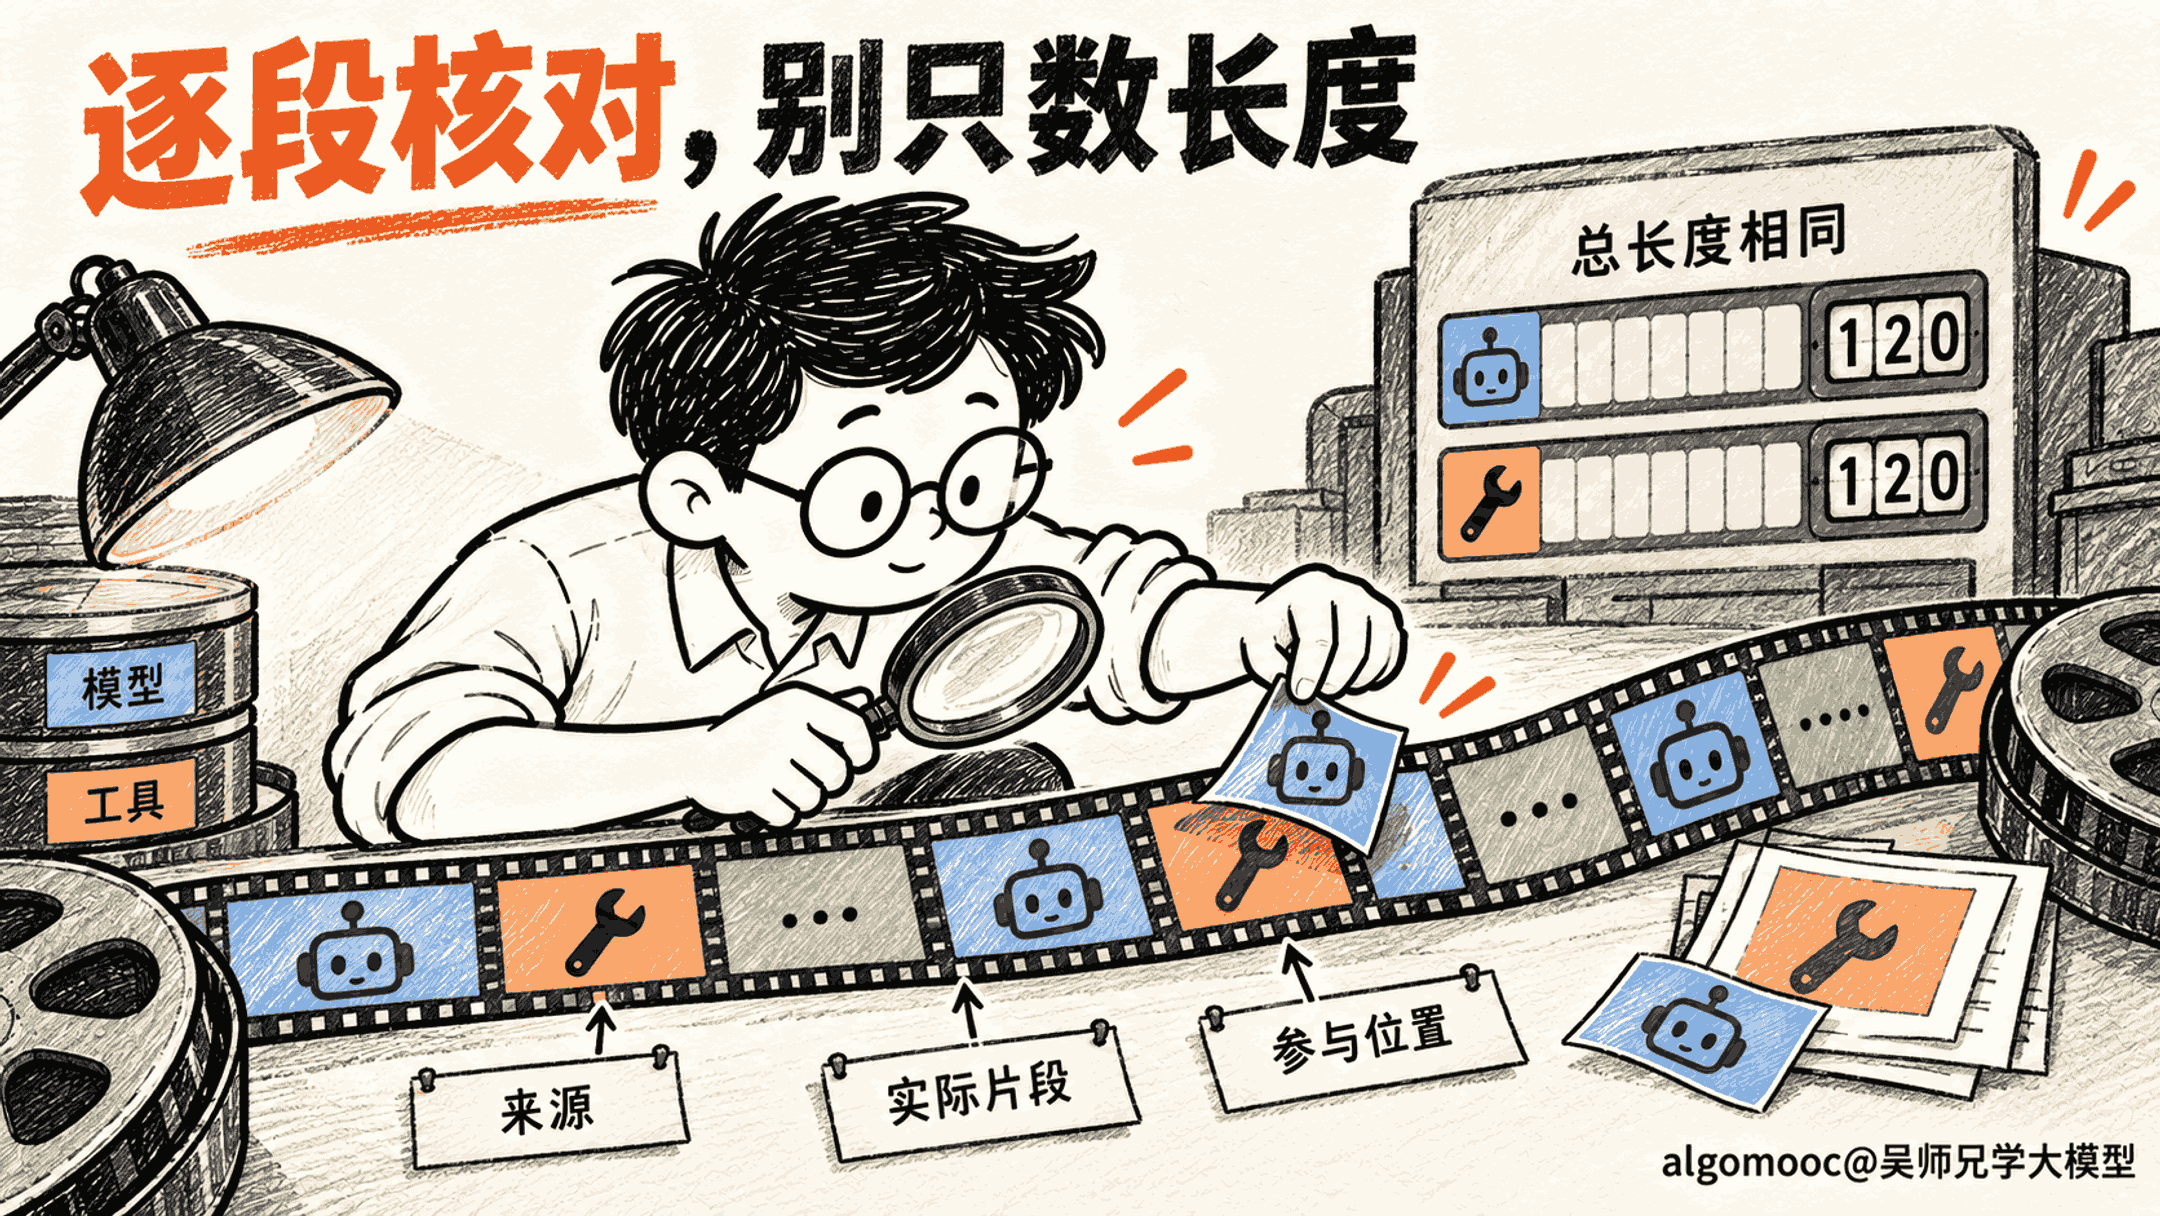
库存任务中,查询调用和最终回答是两段模型生成,中间的库存结果来自工具。三段都要留下,来源标记却不同。只有把内容和标记按同样顺序追加,后续训练才知道哪个位置应该由谁负责。
原适配器还记录了片段类型、步号、token 数量和实际编号。排查时可以从一段工具返回回到它在序列里的位置,而不必只看一条已经拼好的长数组,猜中间几个零到底遮住了什么。
来源也不能只按文本里的标签判断。工具返回可能引用一段长得像对话的文字,模型自己的输出也可能包含工具名称。可靠的分界来自运行器知道谁产生了这一段,以及模板实际追加了哪些编号。根据内容里有没有某个关键词来补标记,会把文本特征误当成执行来源。
如果应用额外给模型插入一段解析错误提示,这段提示同样来自运行器。当前代码把它作为非模型内容追加,并标零。是否参与这一轮策略更新,依据的是内容来源,不取决于文字看起来像回答、提示还是说明。