假设你让一个 Agent 修改日志清洗脚本:给输出补一个采集时间字段,名字固定为 collected_at,保留原有时间字段,遇到空值就跳过。
前面几轮,它能准确复述这三个条件。后来读了不少代码、跑了几次检查,上下文越来越长,于是系统生成一段摘要,把旧消息换掉。Agent 接着工作,仍然知道要“补采集时间”,却把字段写成了 timestamp,还顺手覆盖了旧字段。
你翻开摘要,里面写着“继续完善日志时间字段,保持数据结构一致”。这句话没有明显事实错误,读起来也很顺。但真正决定下一步怎么改的条件已经不在了。
做 Agent 项目时,谈到上下文压缩,很容易停在“历史太长,调用模型总结一下”。后面的追问才碰到实现:压缩后,靠什么保证下一步仍按原来的条件执行?
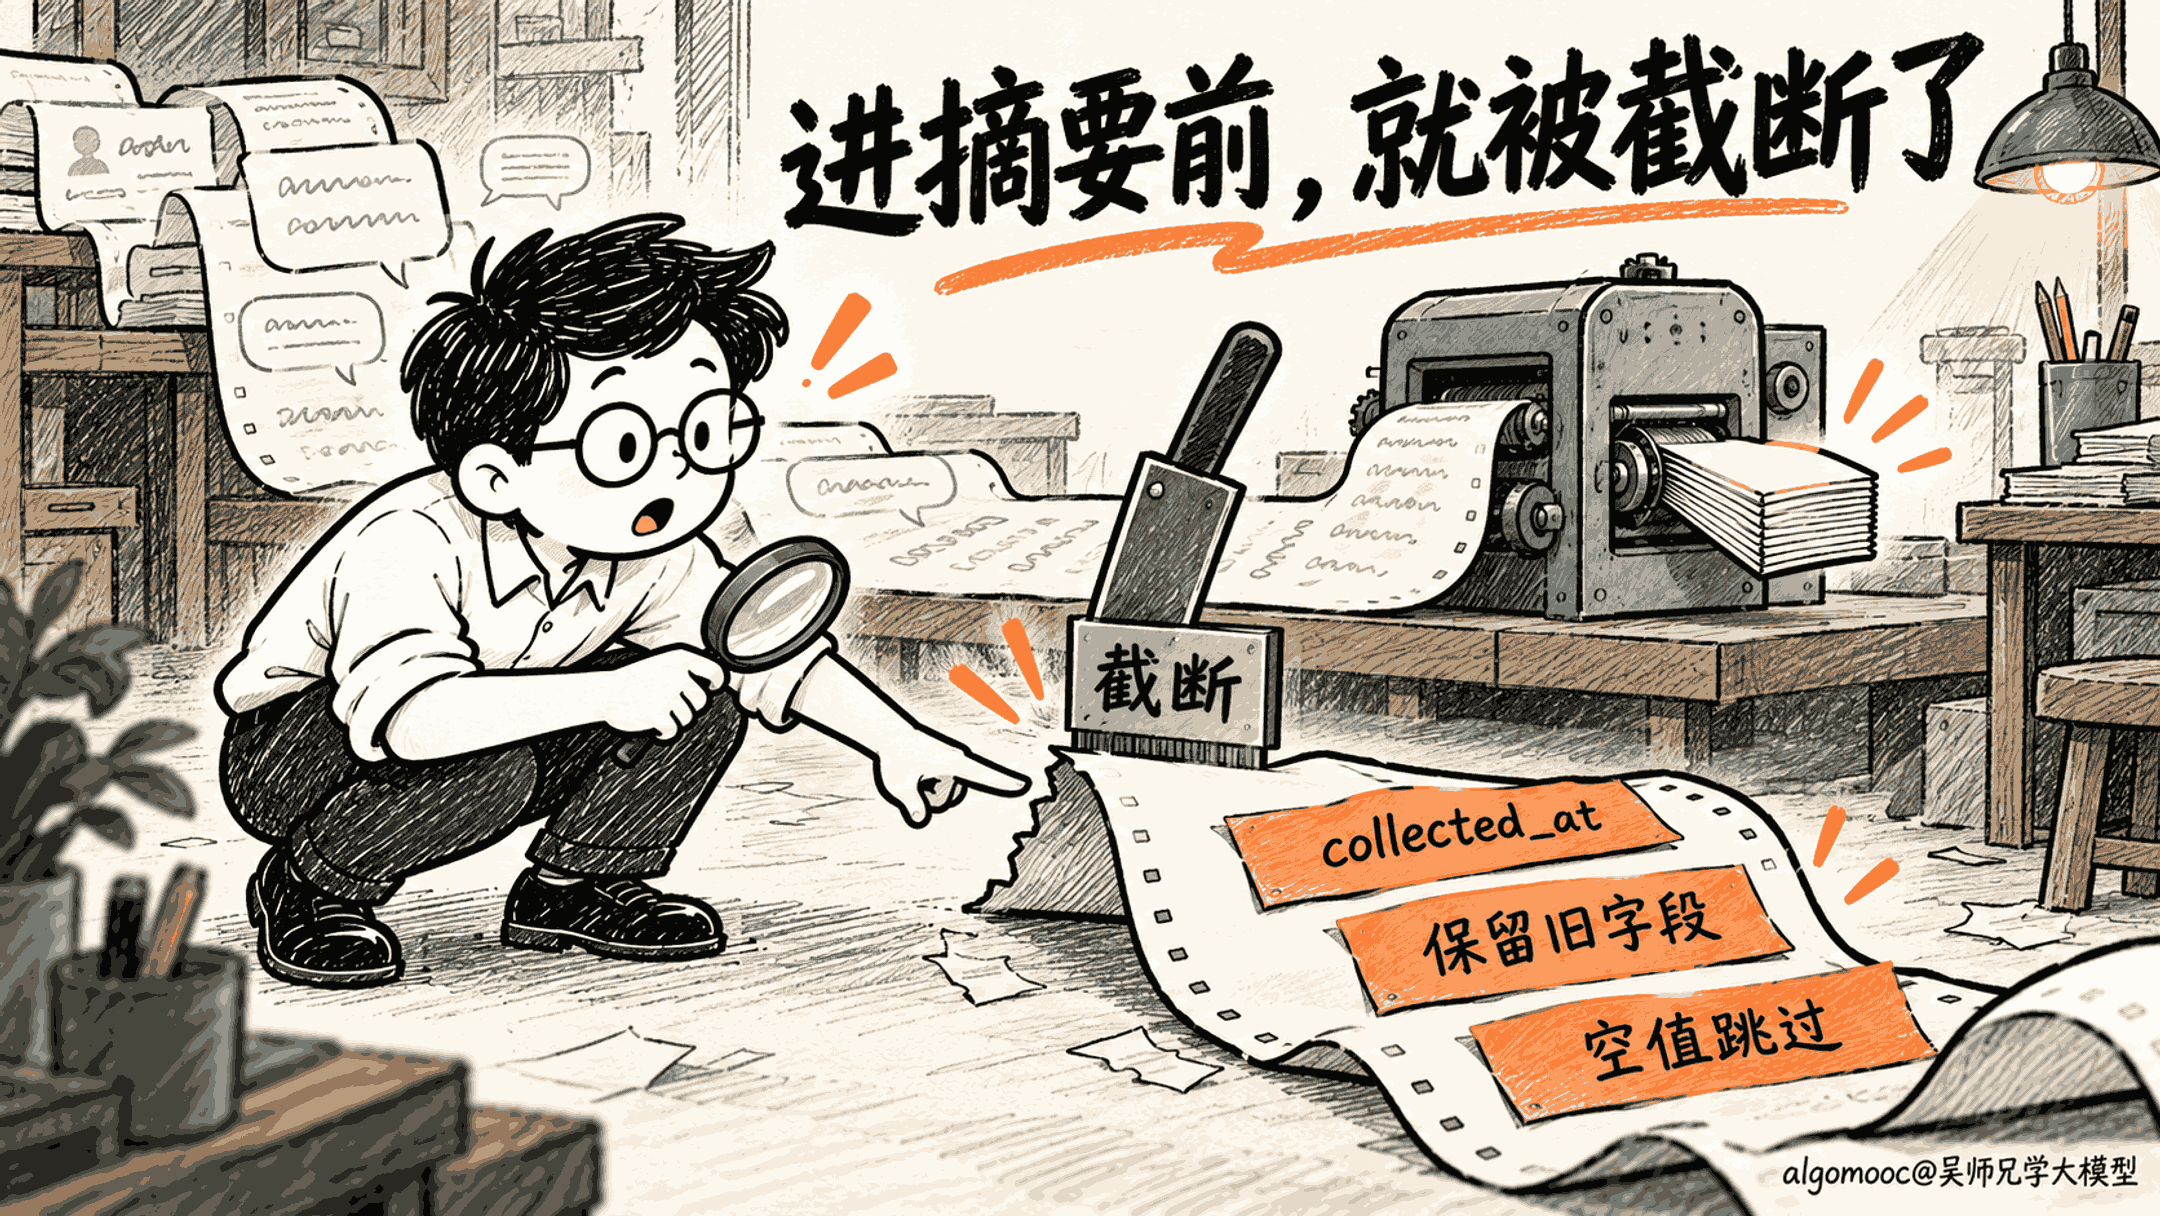
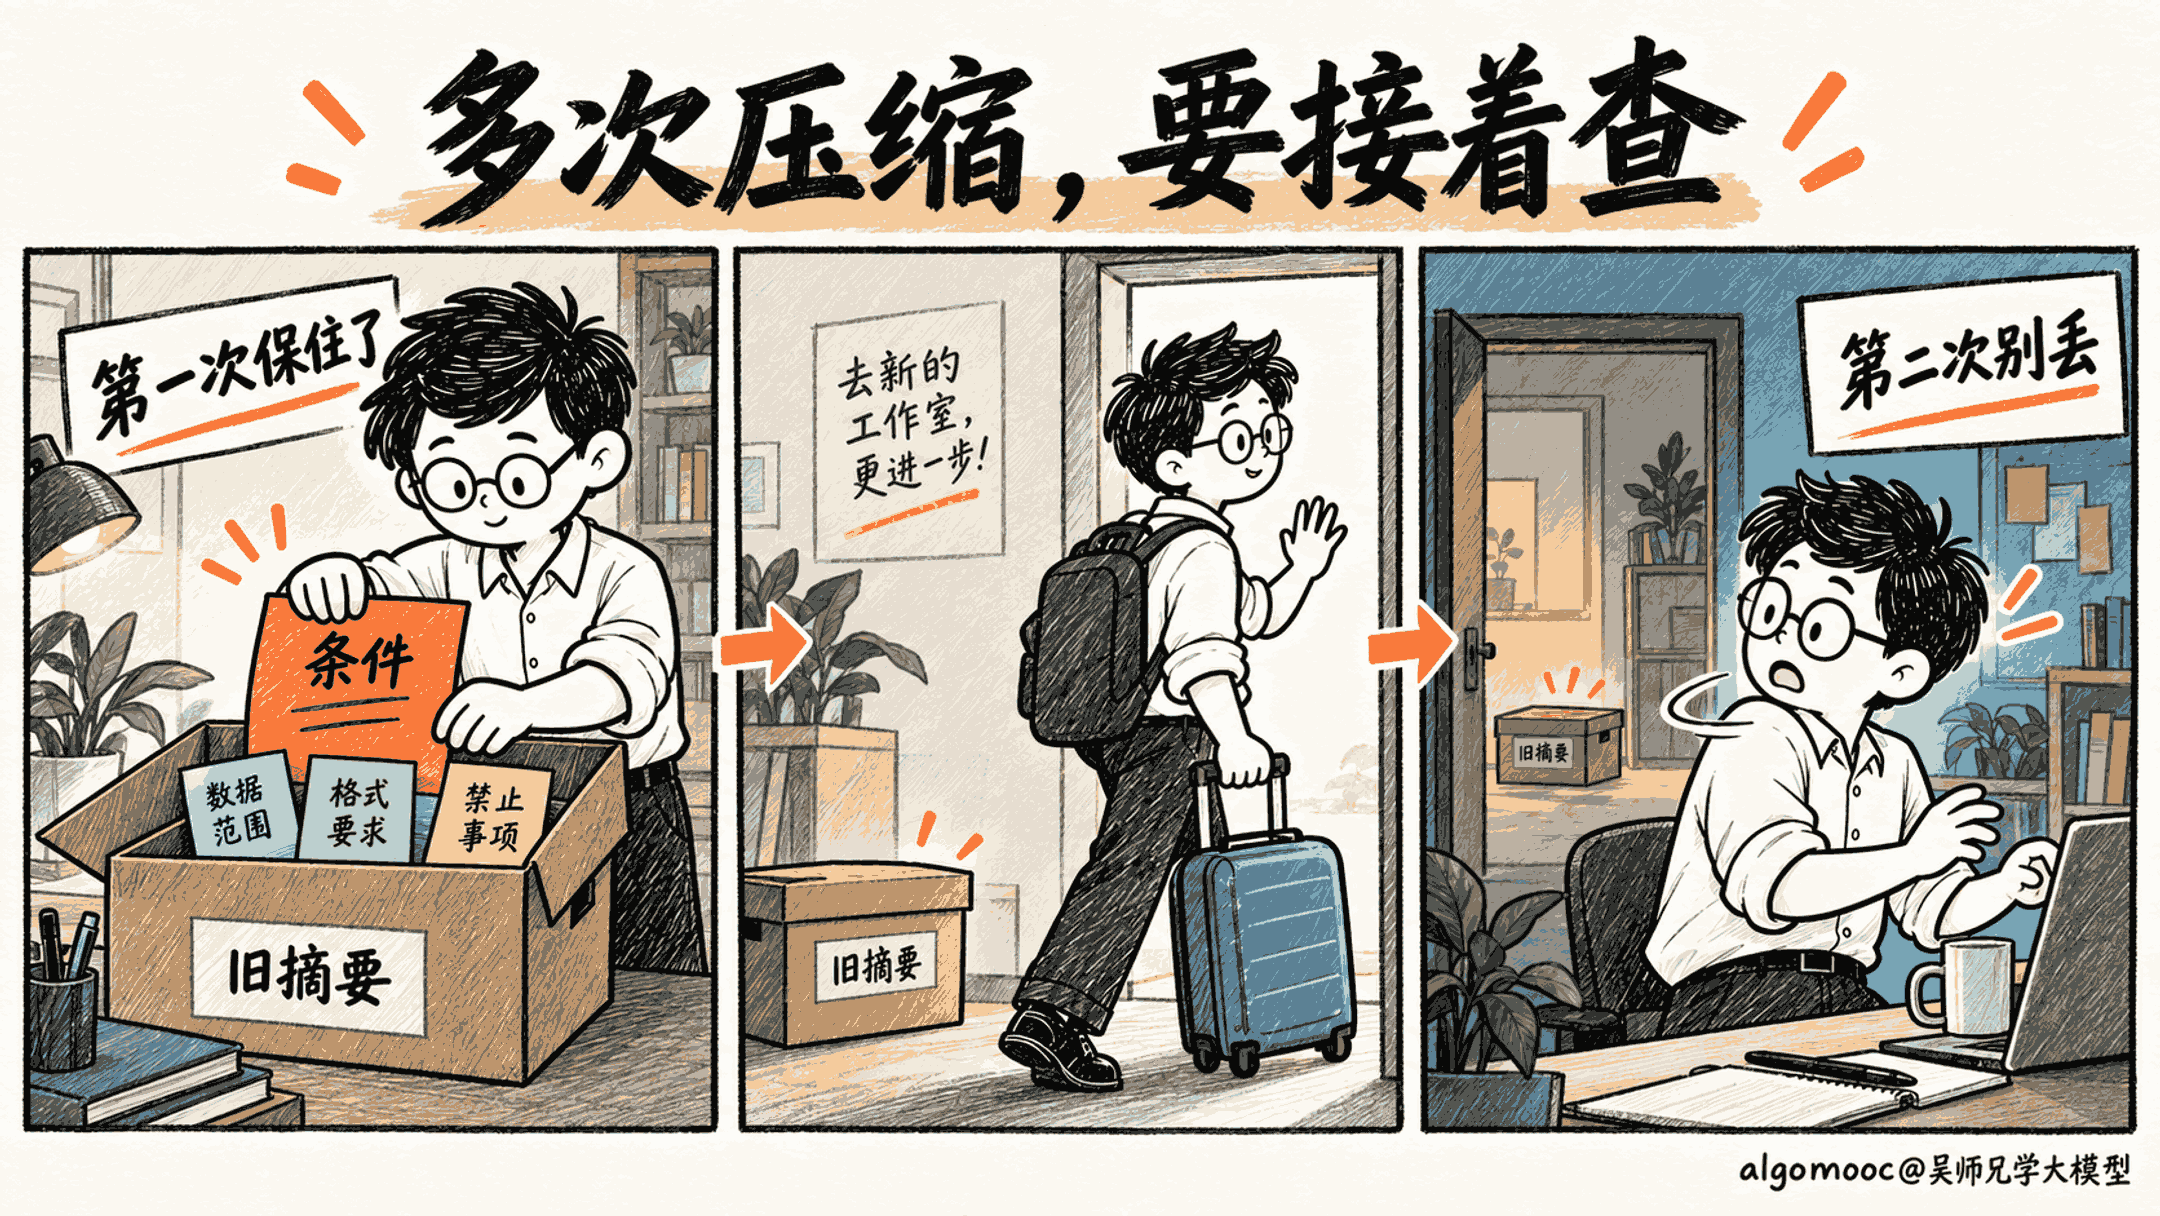
这件事要沿着压缩前后的输入去查。因为关键内容可能在摘要生成之前就被截掉,也可能第一次保住了,第二次又丢了。
摘要保留了话题,却没保留动作条件
“补采集时间”说明要做什么,collected_at、保留旧字段、空值跳过,才决定具体怎样做。前者换一种说法通常不影响任务,后者稍微变动,输出就可能不同。
把这段任务交给一个没看过聊天记录的开发者,他至少会问:改哪个文件?输出字段叫什么?旧字段能不能删?空值怎么处理?已经改到哪一步?这些问题的答案,构成了继续工作的最小上下文。
普通聊天摘要更关心讨论了哪些主题、有哪些主要观点。Agent 的上下文还要支撑后续动作。它需要保留精确对象、当前决定和未完成事项,有些内容只有几个字,却比整页背景介绍更关键。
例如,讨论中曾比较过 timestamp 和 collected_at,最后选了后者。摘要如果只写“讨论了时间字段命名”,保留的是过程的主题,没有保留决定。下一轮模型又要从两个名字里猜一次。
再如,已经决定跳过空值,摘要却写成“需要处理空值”。一个确定条件被改成了开放问题,后续模型可能补默认时间,也可能抛错。每种做法看起来都有道理,任务却已经换了。
因此,检查摘要时,仅仅对照它有没有胡说还不够。要追问一句:让一个新接手的人只读这份内容,能不能确定下一步允许怎样改,遇到什么情况应该停下来找原文?
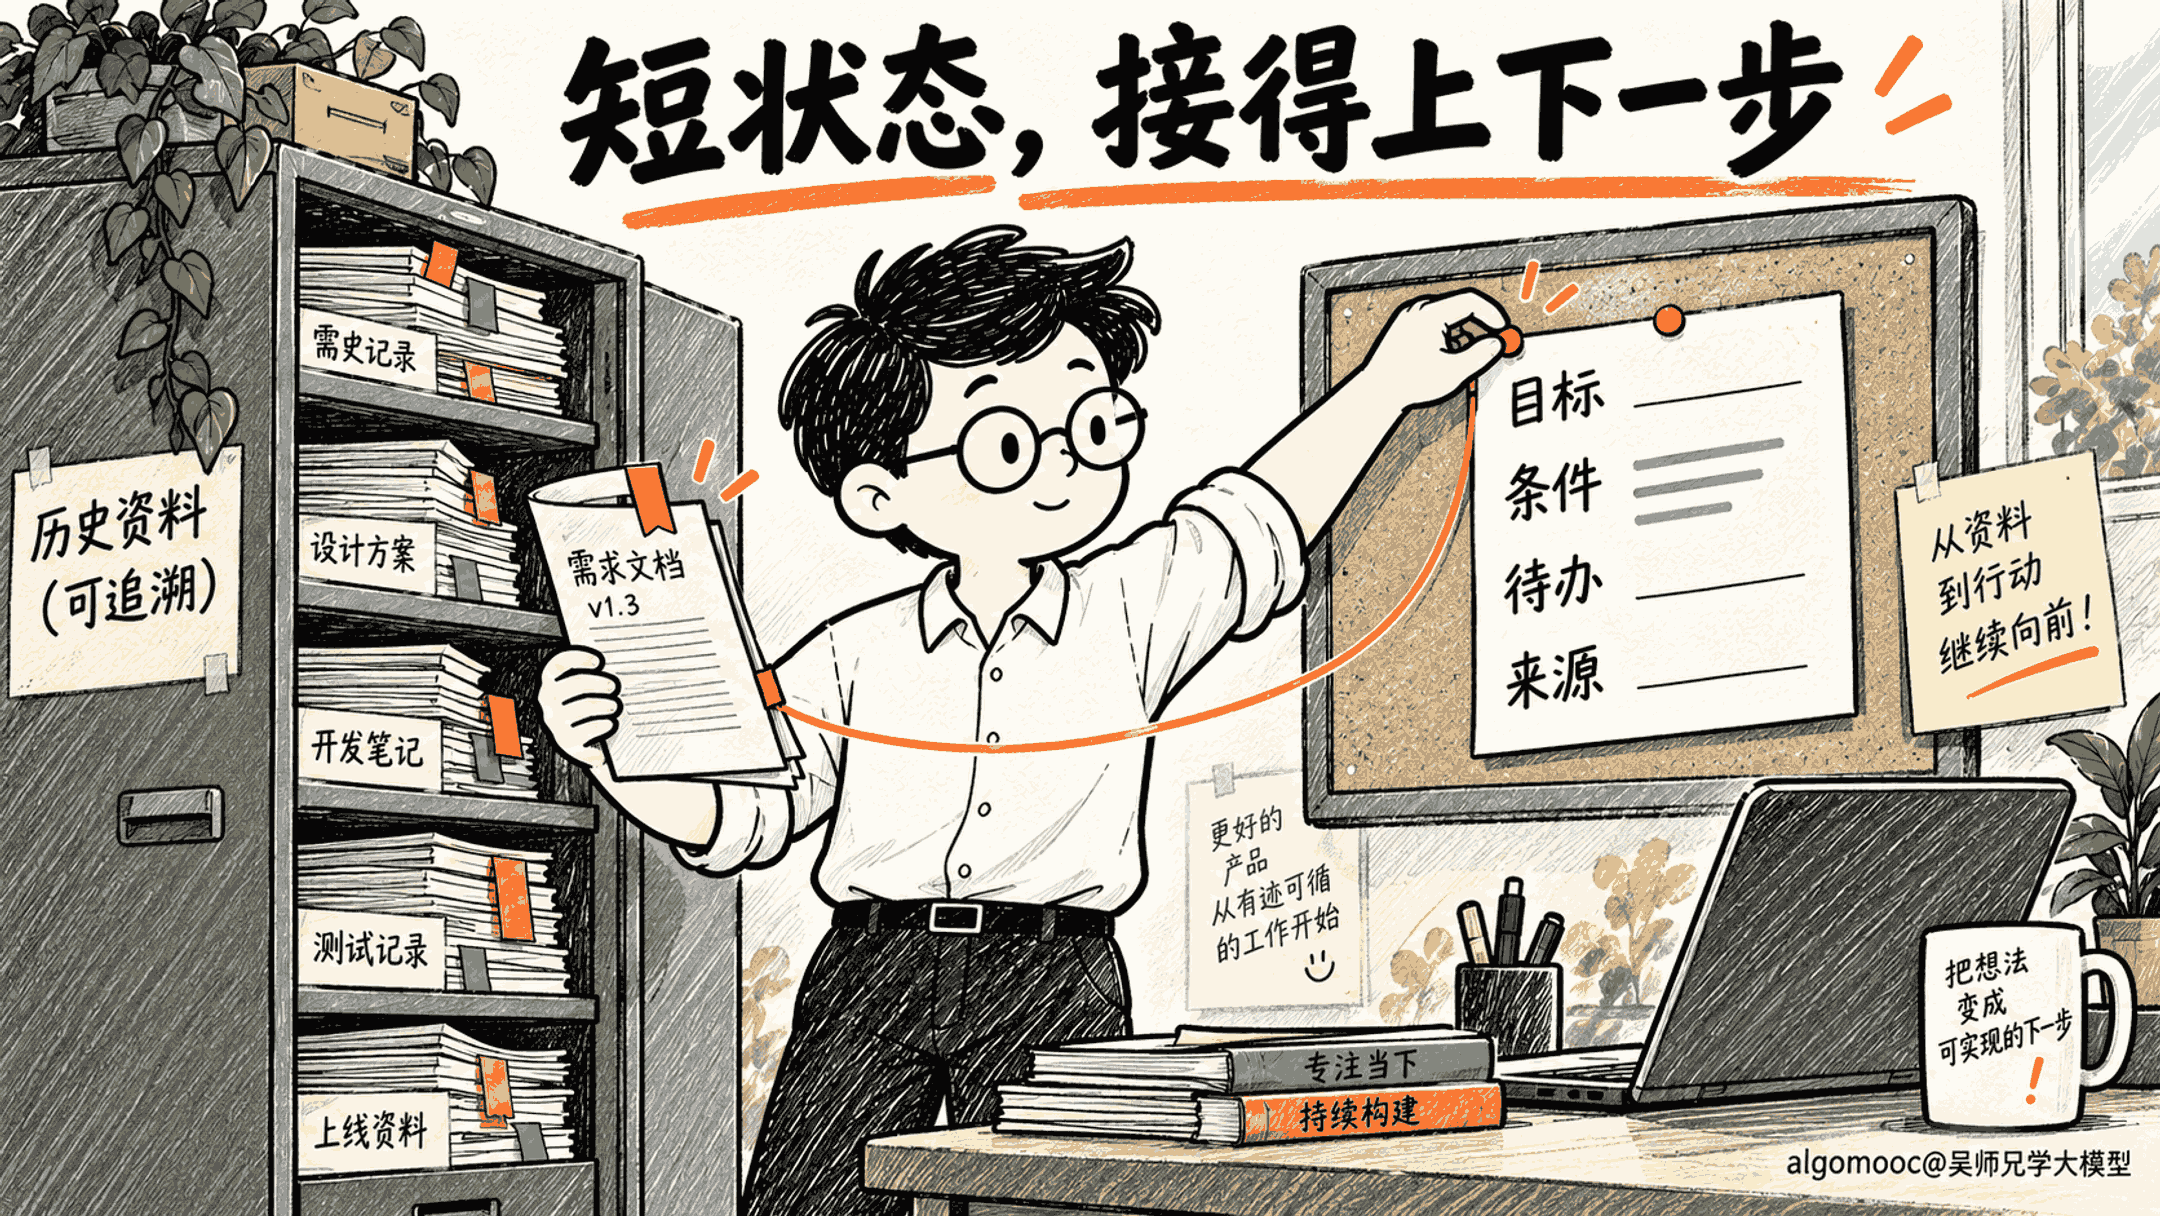
这个标准会改变你对信息重要性的排序。冗长的推理过程可以缩短,最终采用的字段名要精确保留;重复的解释可以删掉,用户最后一次修正应当留下;已经完成的探索可以归档,下一步依赖的证据要能找回来。