本文目录
先用 30 秒讲清楚
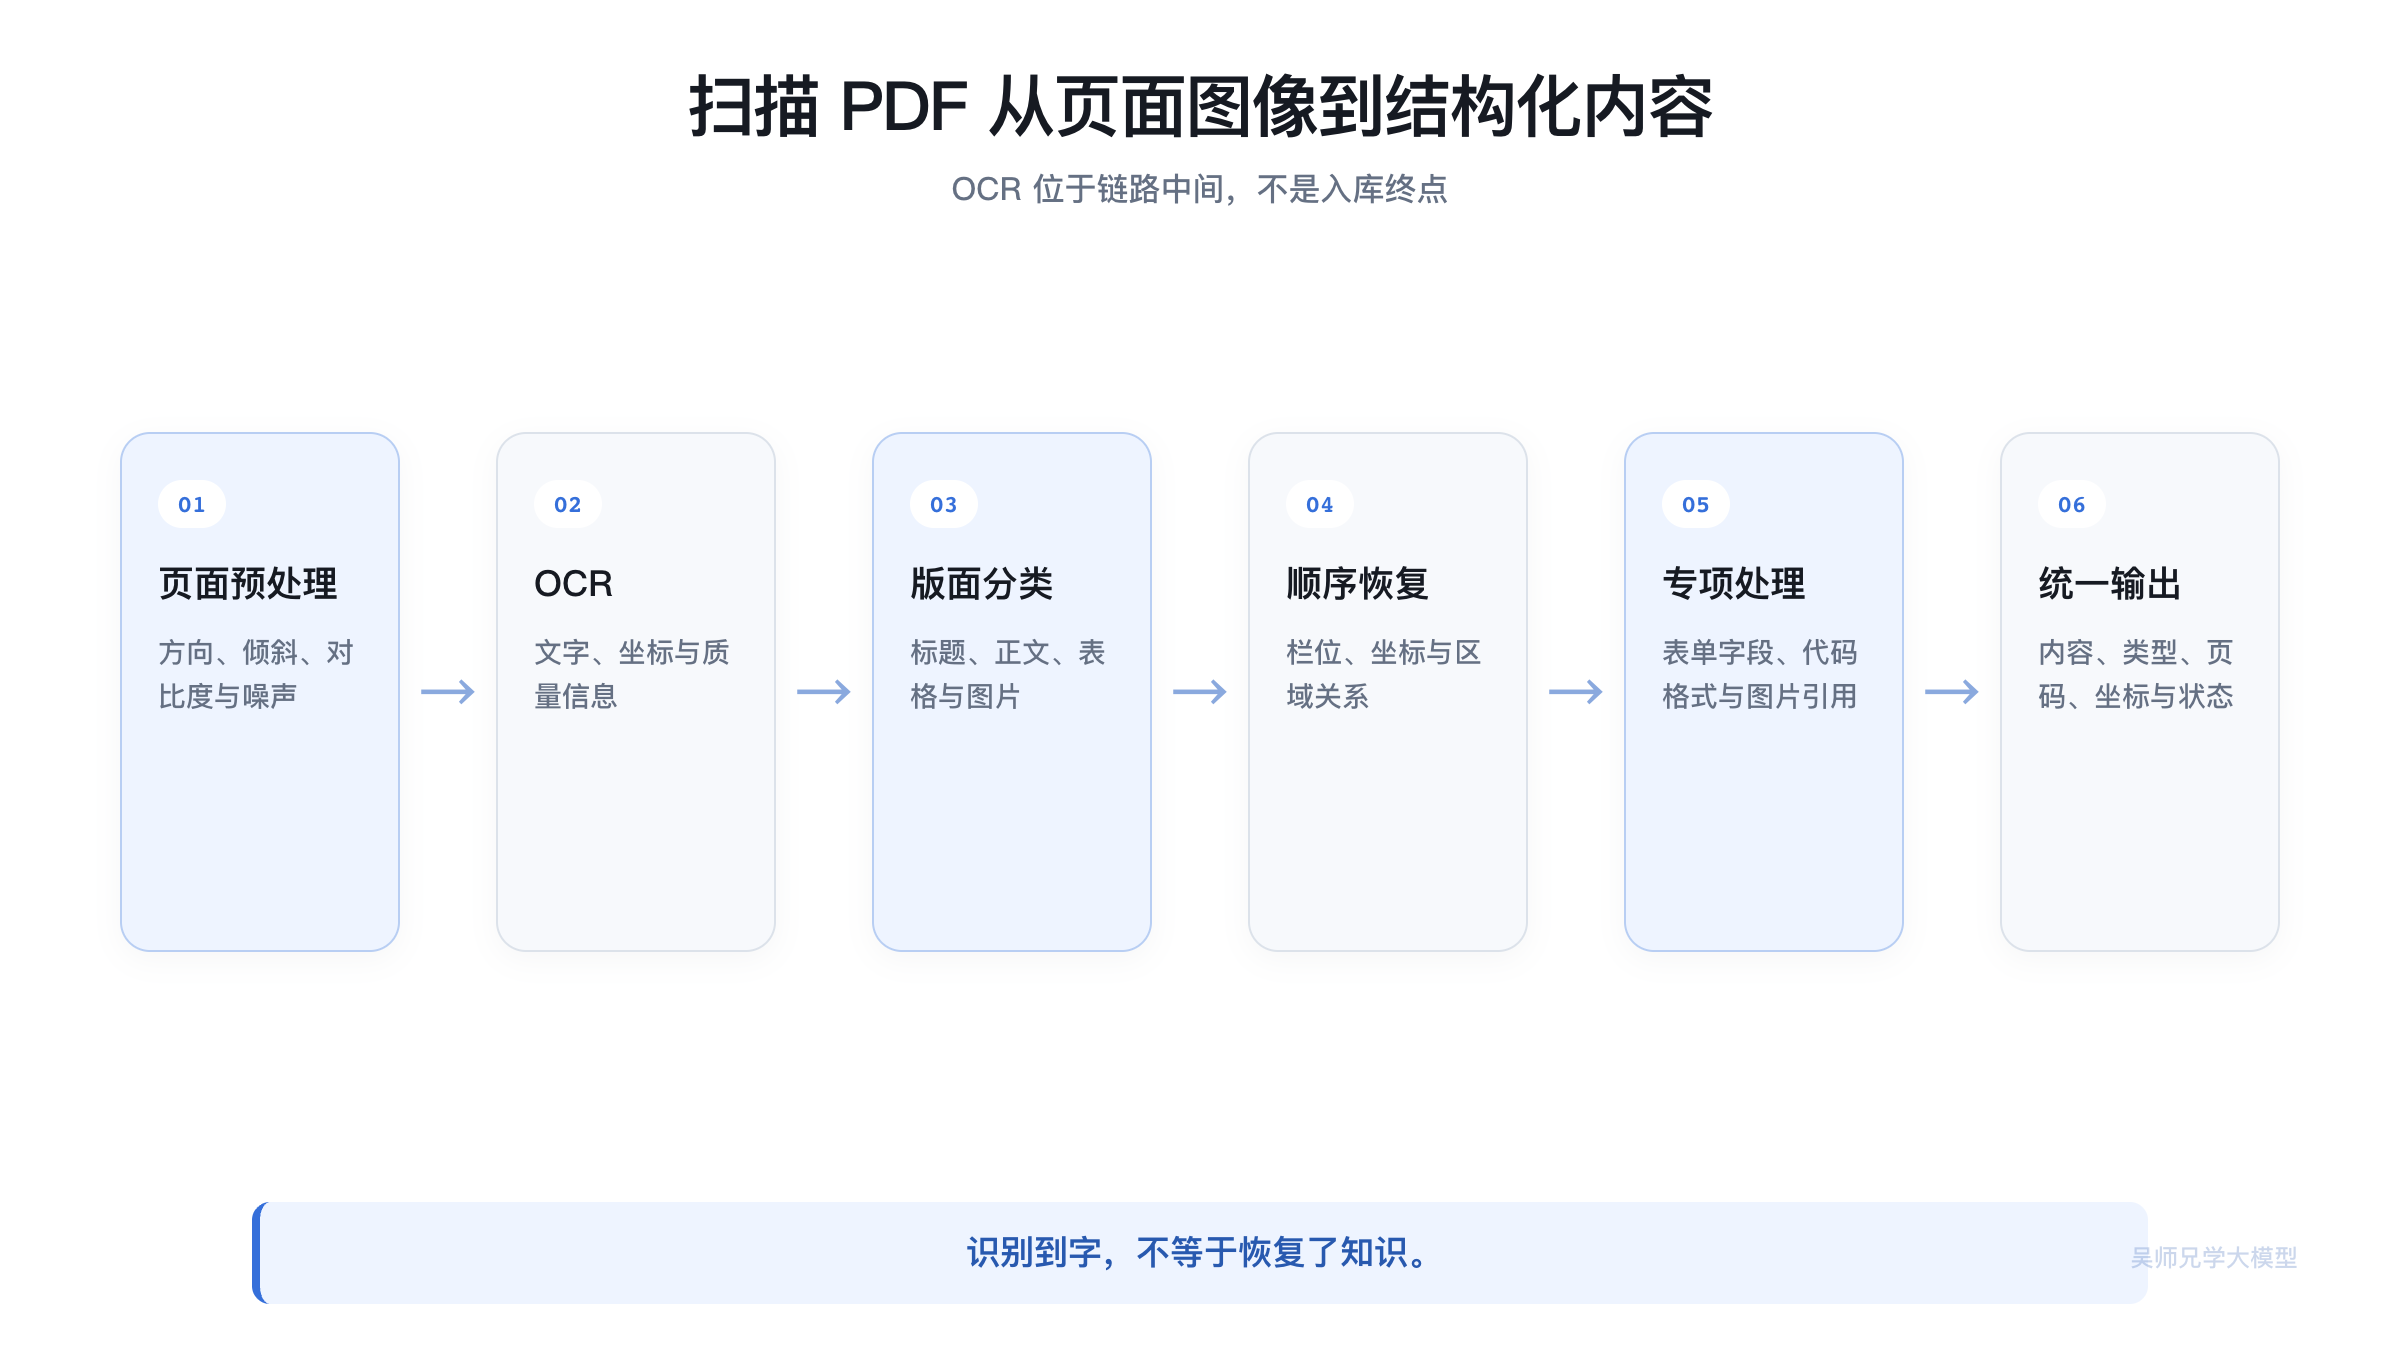
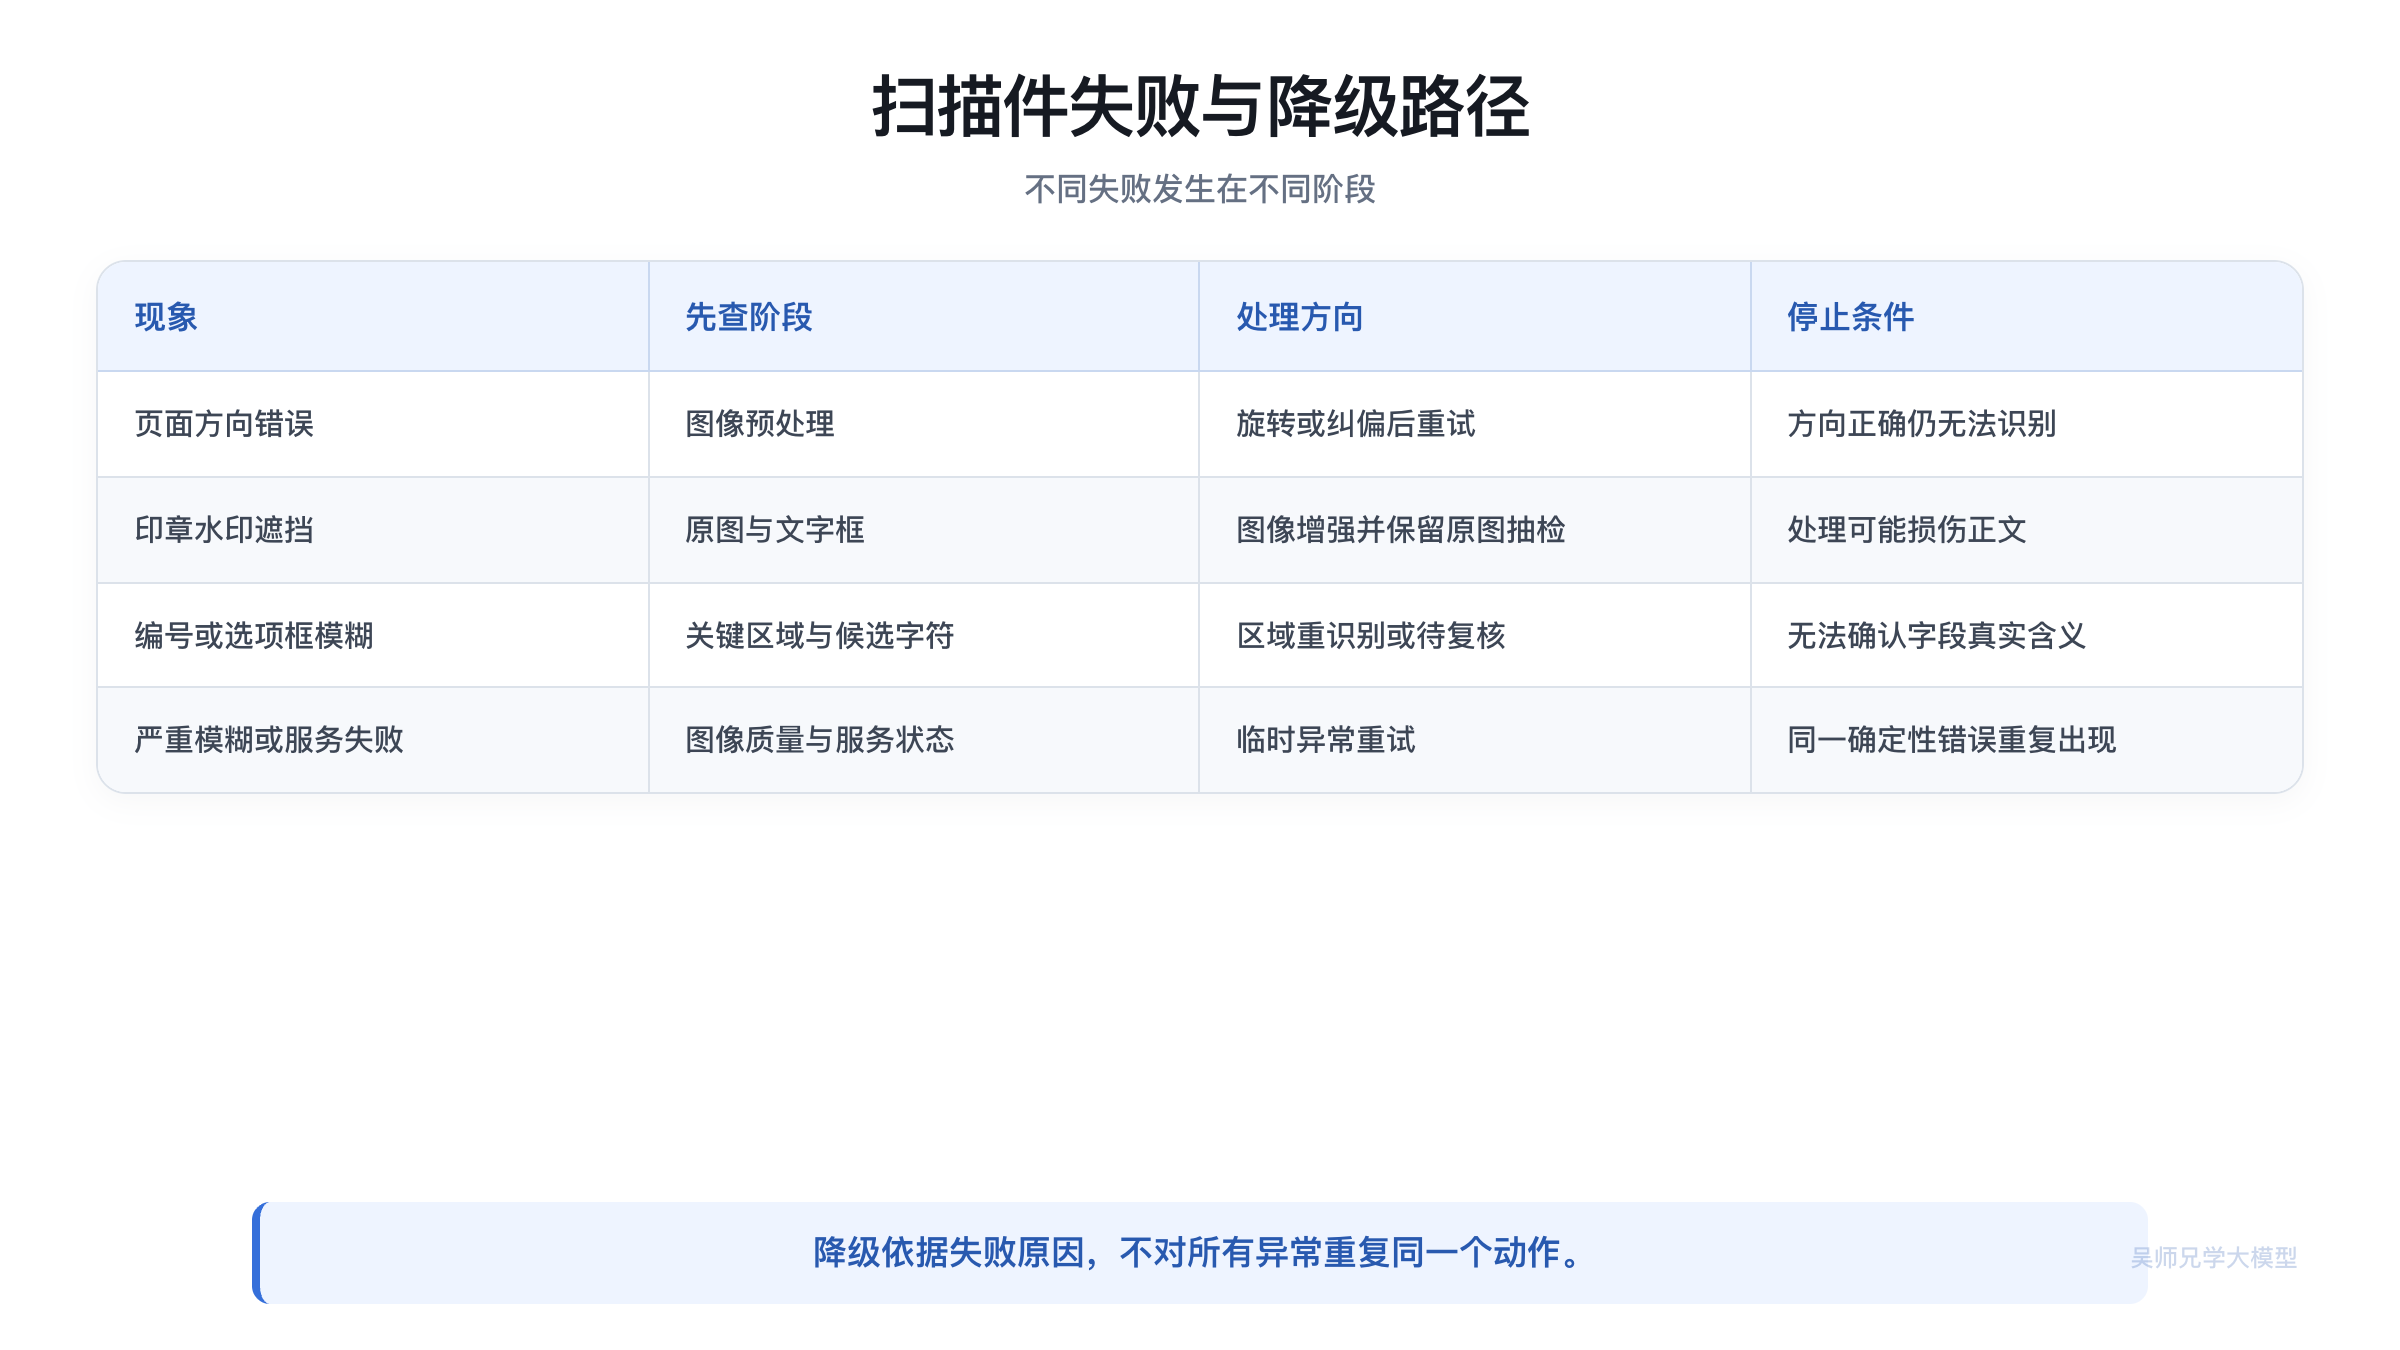
先判断 PDF 是否有可用字符层;没有时把页面按合适分辨率渲染为图像再做 OCR。OCR 结果必须保留坐标,继续经过版面分类、阅读顺序恢复和表格识别。某页低置信度或超时时,应标记、重试或降级,而不是让一页失败拖垮整份文档。
先看一个教学场景。
用户打开一份扫描 PDF,页面清清楚楚,文字、表格和印章都看得见。系统也显示文件上传完成。可程序读取页面时,只拿到几个页码或一段水印,正文几乎为空。后面的分块、向量化和入库没有明显报错,用户提问时却一直搜不到材料里的答案。
问题不在大模型,也不一定在向量库。真正的原因是这份 PDF 没有可用字符层,页面本质上是一张张图片。
于是面试官会继续问:
你怎么判断一页 PDF 需要 OCR?识别完成后为什么不能直接把文字塞进向量库?遇到模糊页、表格页和失败页又怎样降级?
如果回答只有“调用 OCR 接口提取文字”,很快就会遇到下一层追问。因为 OCR 只是把像素变成文字候选,距离可检索、可引用的内容还差版面、顺序、结构、位置和质量控制。
先判断:这一页真的需要 OCR 吗?
页面判断不能只做“字符串为空”这一项检查。扫描页常见的误导信号是:页码、页眉或水印能够被读取,于是结果并非空字符串,但真正占据正文区域的内容仍然是一张图。
更实用的做法,是把页面先分成三类。
第一类是可直接使用页。有效文字框覆盖正文区域,阅读内容与程序提取结果基本一致,这类页面不需要额外 OCR。
第二类是需要识别页。正文区域主要由大图覆盖,已有文字只集中在页眉、页脚或少量标签,页面应进入 OCR 与版面恢复。
第三类是可疑页。页面既有字符层又有大块图像,或者提取结果与视觉内容明显不匹配。它不能只因为“有字”就放行,也不应该在没有检查时直接覆盖原字符层。系统需要保留两种候选、记录判断原因,再由代表性样本确定采用哪条路线。
判断信号可以来自有效文字数量、文字框在正文区域的覆盖、重复页眉特征、页面图像占比,以及提取文字与视觉区域是否对应。它们共同回答的是“正文有没有被程序拿到”,而不是给 PDF 贴一个永久标签。
阈值会受字号、语言、页面尺寸和文档类型影响。上线前需要用实际页面校准,并把误判页留在回归集中;这里没有一个能跨资料直接照搬的数字。
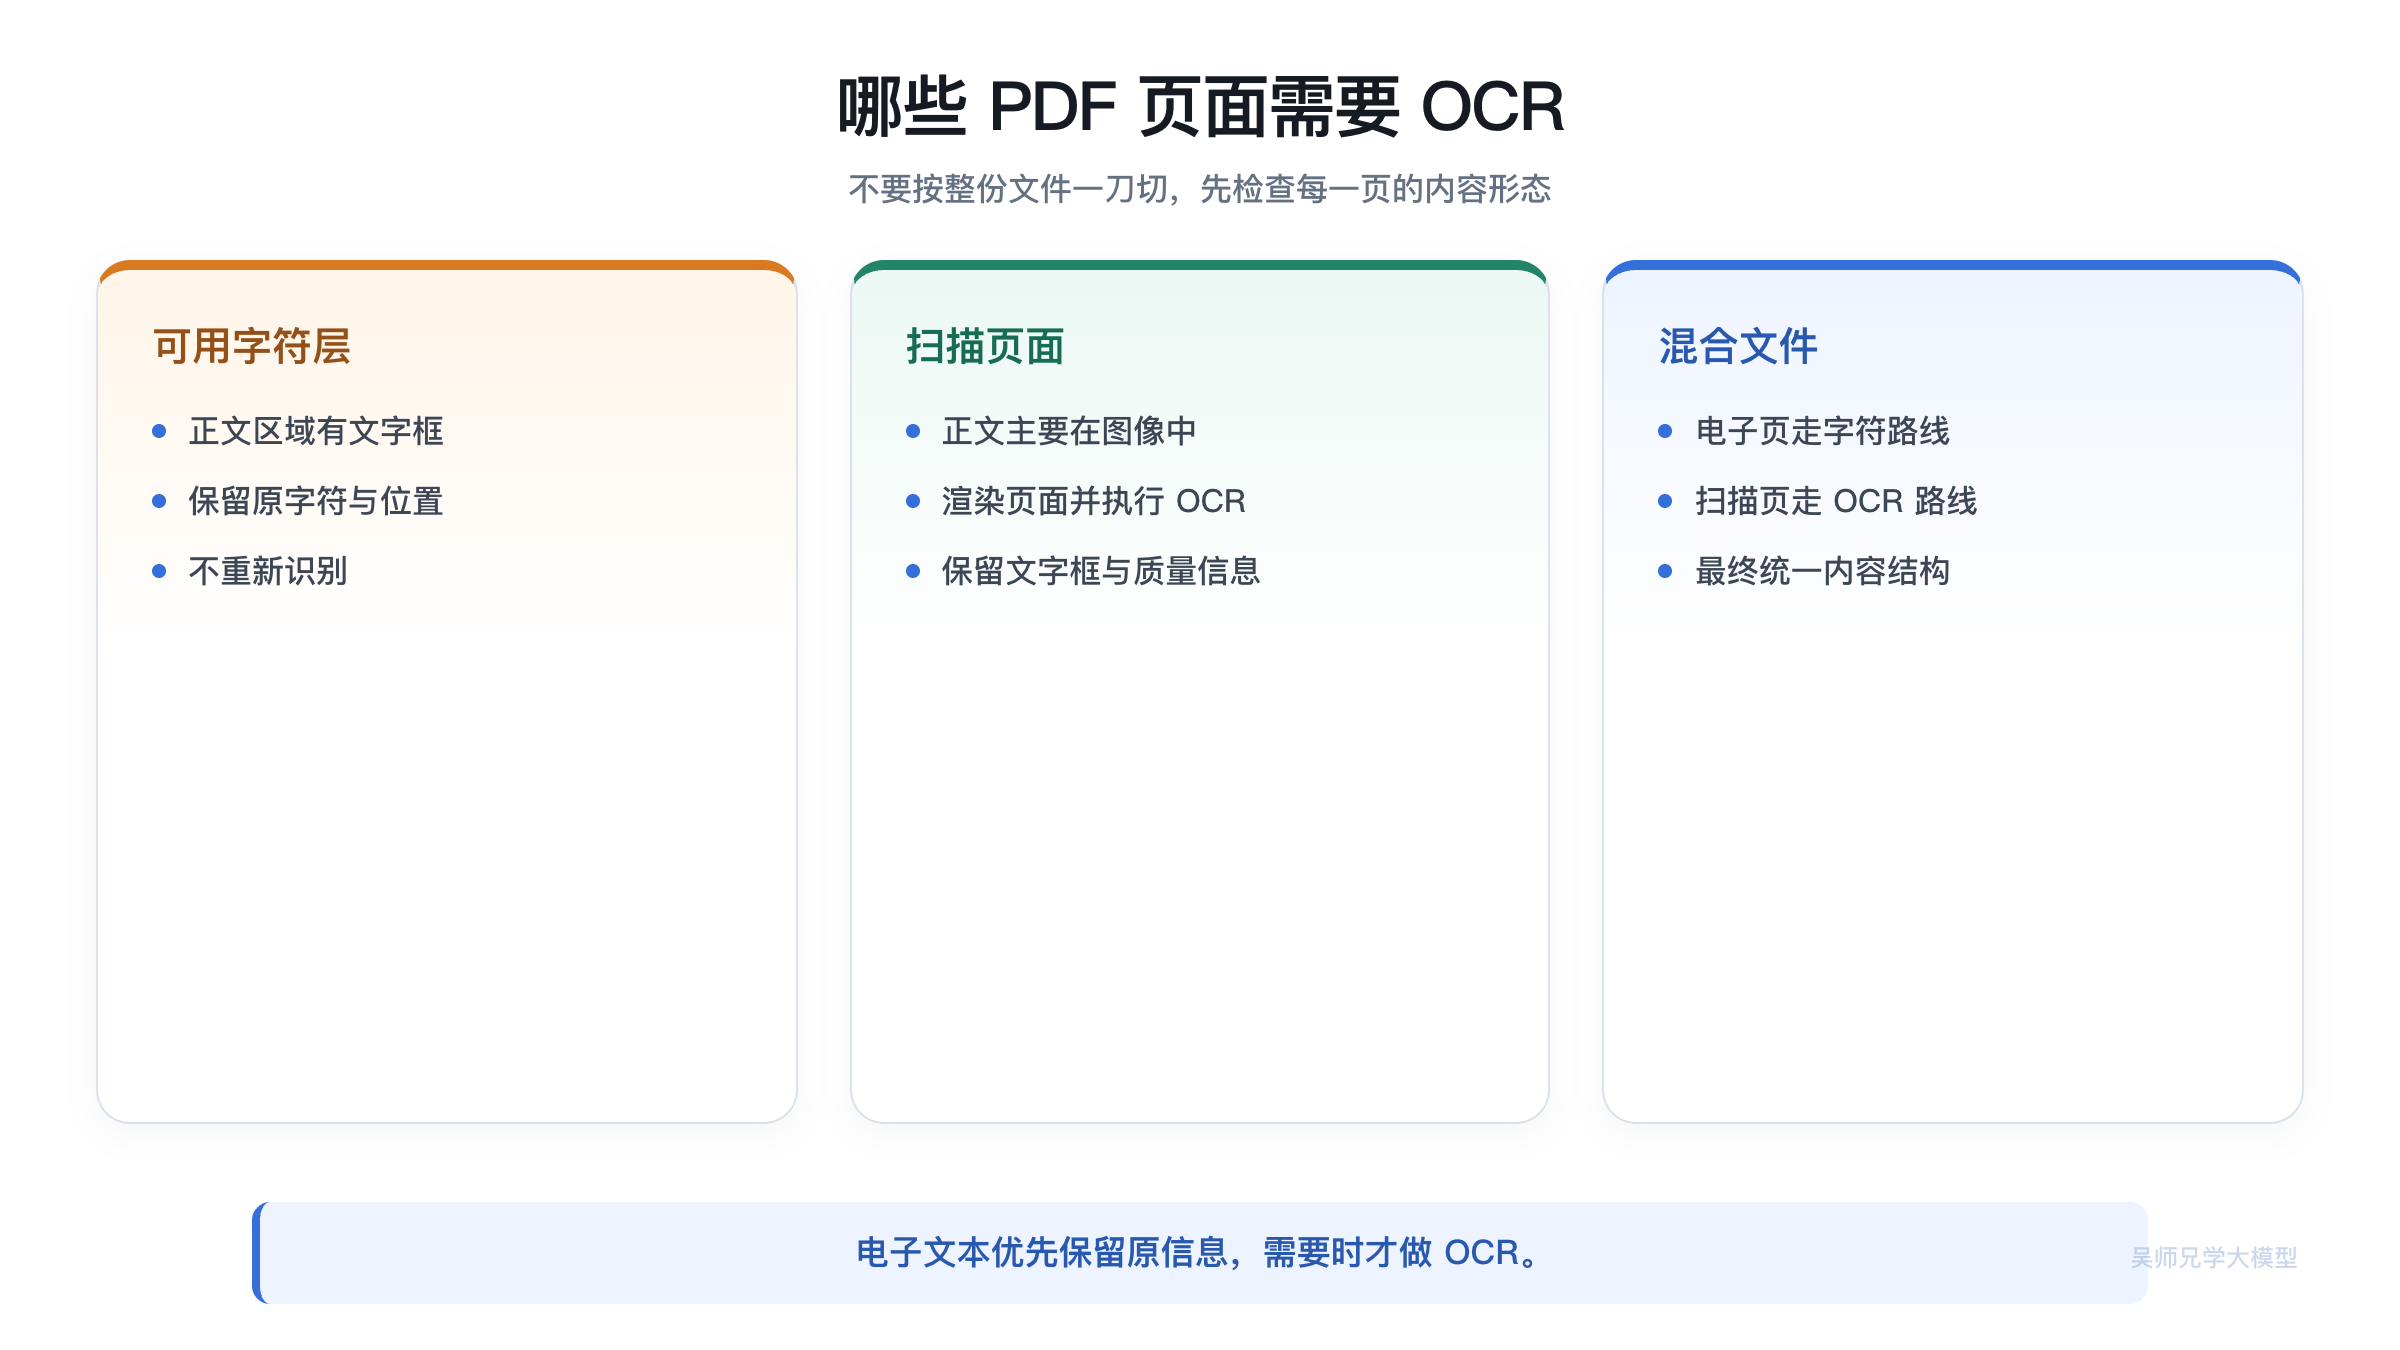
先在页面级区分可用字符层、扫描图像和混合内容。电子文本优先保留原信息,需要时才进入 OCR。
页面级判断的产物不应只有一个布尔值。最好同时记录分类、判断信号、采用的文字来源和是否需要复核。后面发现漏字时,团队才能知道是 OCR 本身失败,还是页面一开始就被分到了错误路线。
OCR 之后,还有哪几步才能进入 RAG?
继续追问 · 4 个问题
- 怎样判断字符层不可用,而不是一律做 OCR?
- OCR 有文字但顺序错时,你查哪一层?
- 低置信度页面怎样重试、降级与进入人工复核?
- 怎样验证 OCR 结果仍能回到原页和原区域?
回答前,逐项自查
- 准备电子 PDF 与扫描 PDF 对照样本
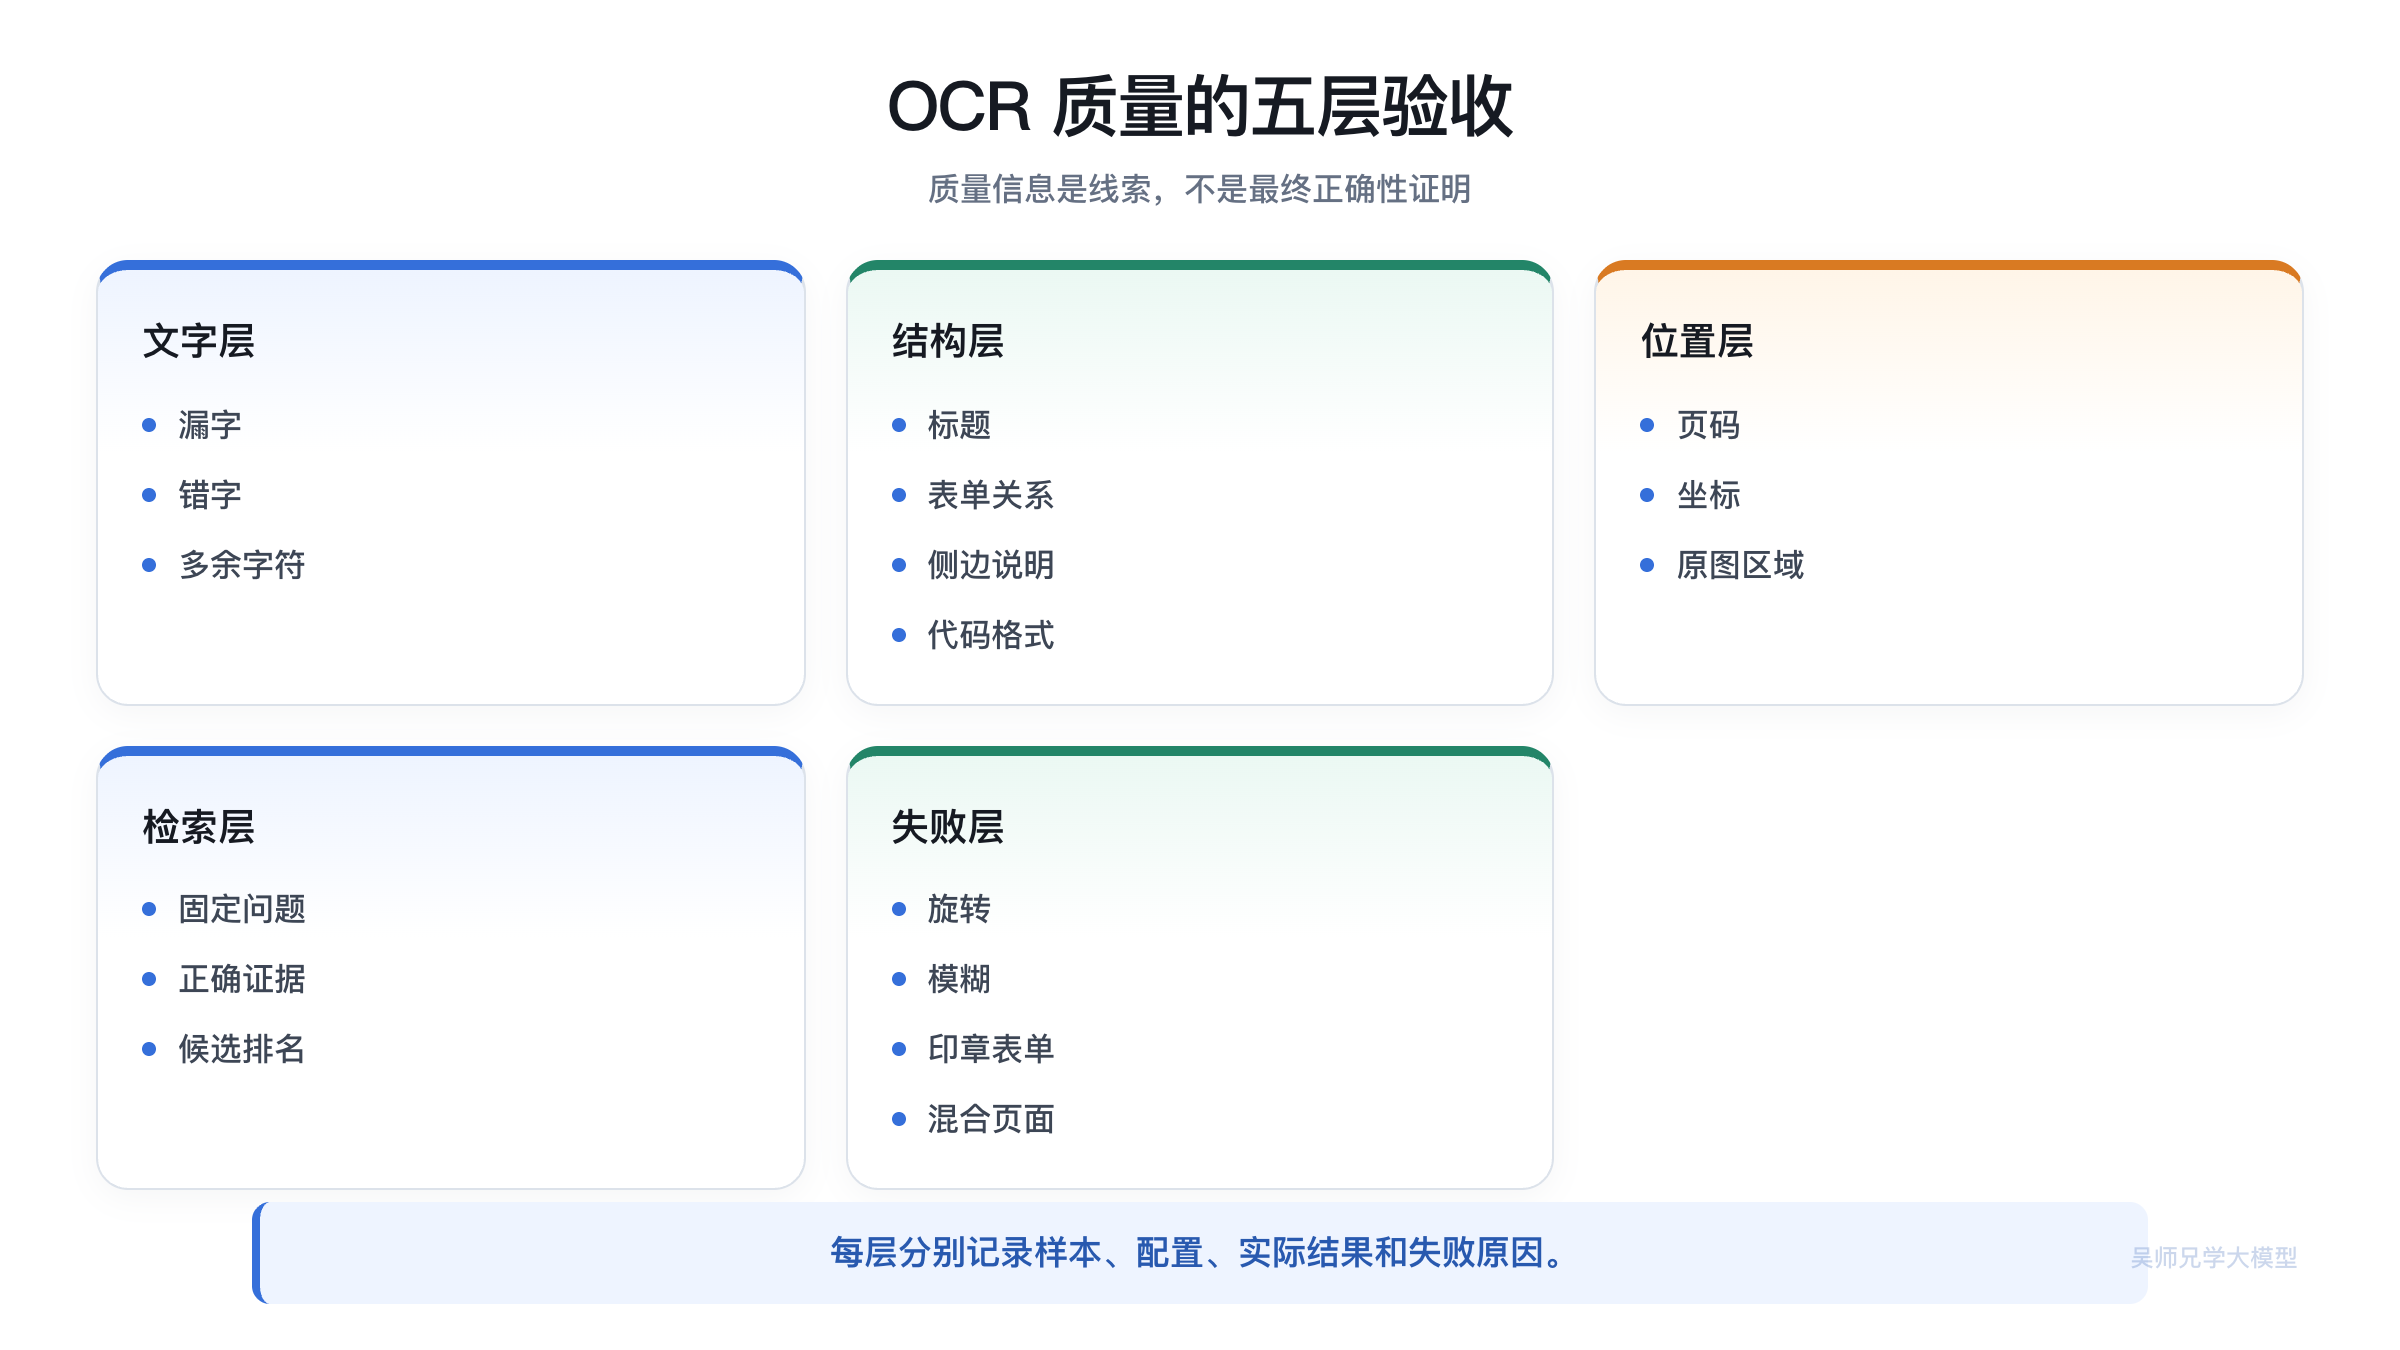
- 保留 OCR 文本框、坐标和置信度
- 列出按页失败时的处理状态
- 用真实问题检查召回与原页定位