本文目录
先用 30 秒讲清楚
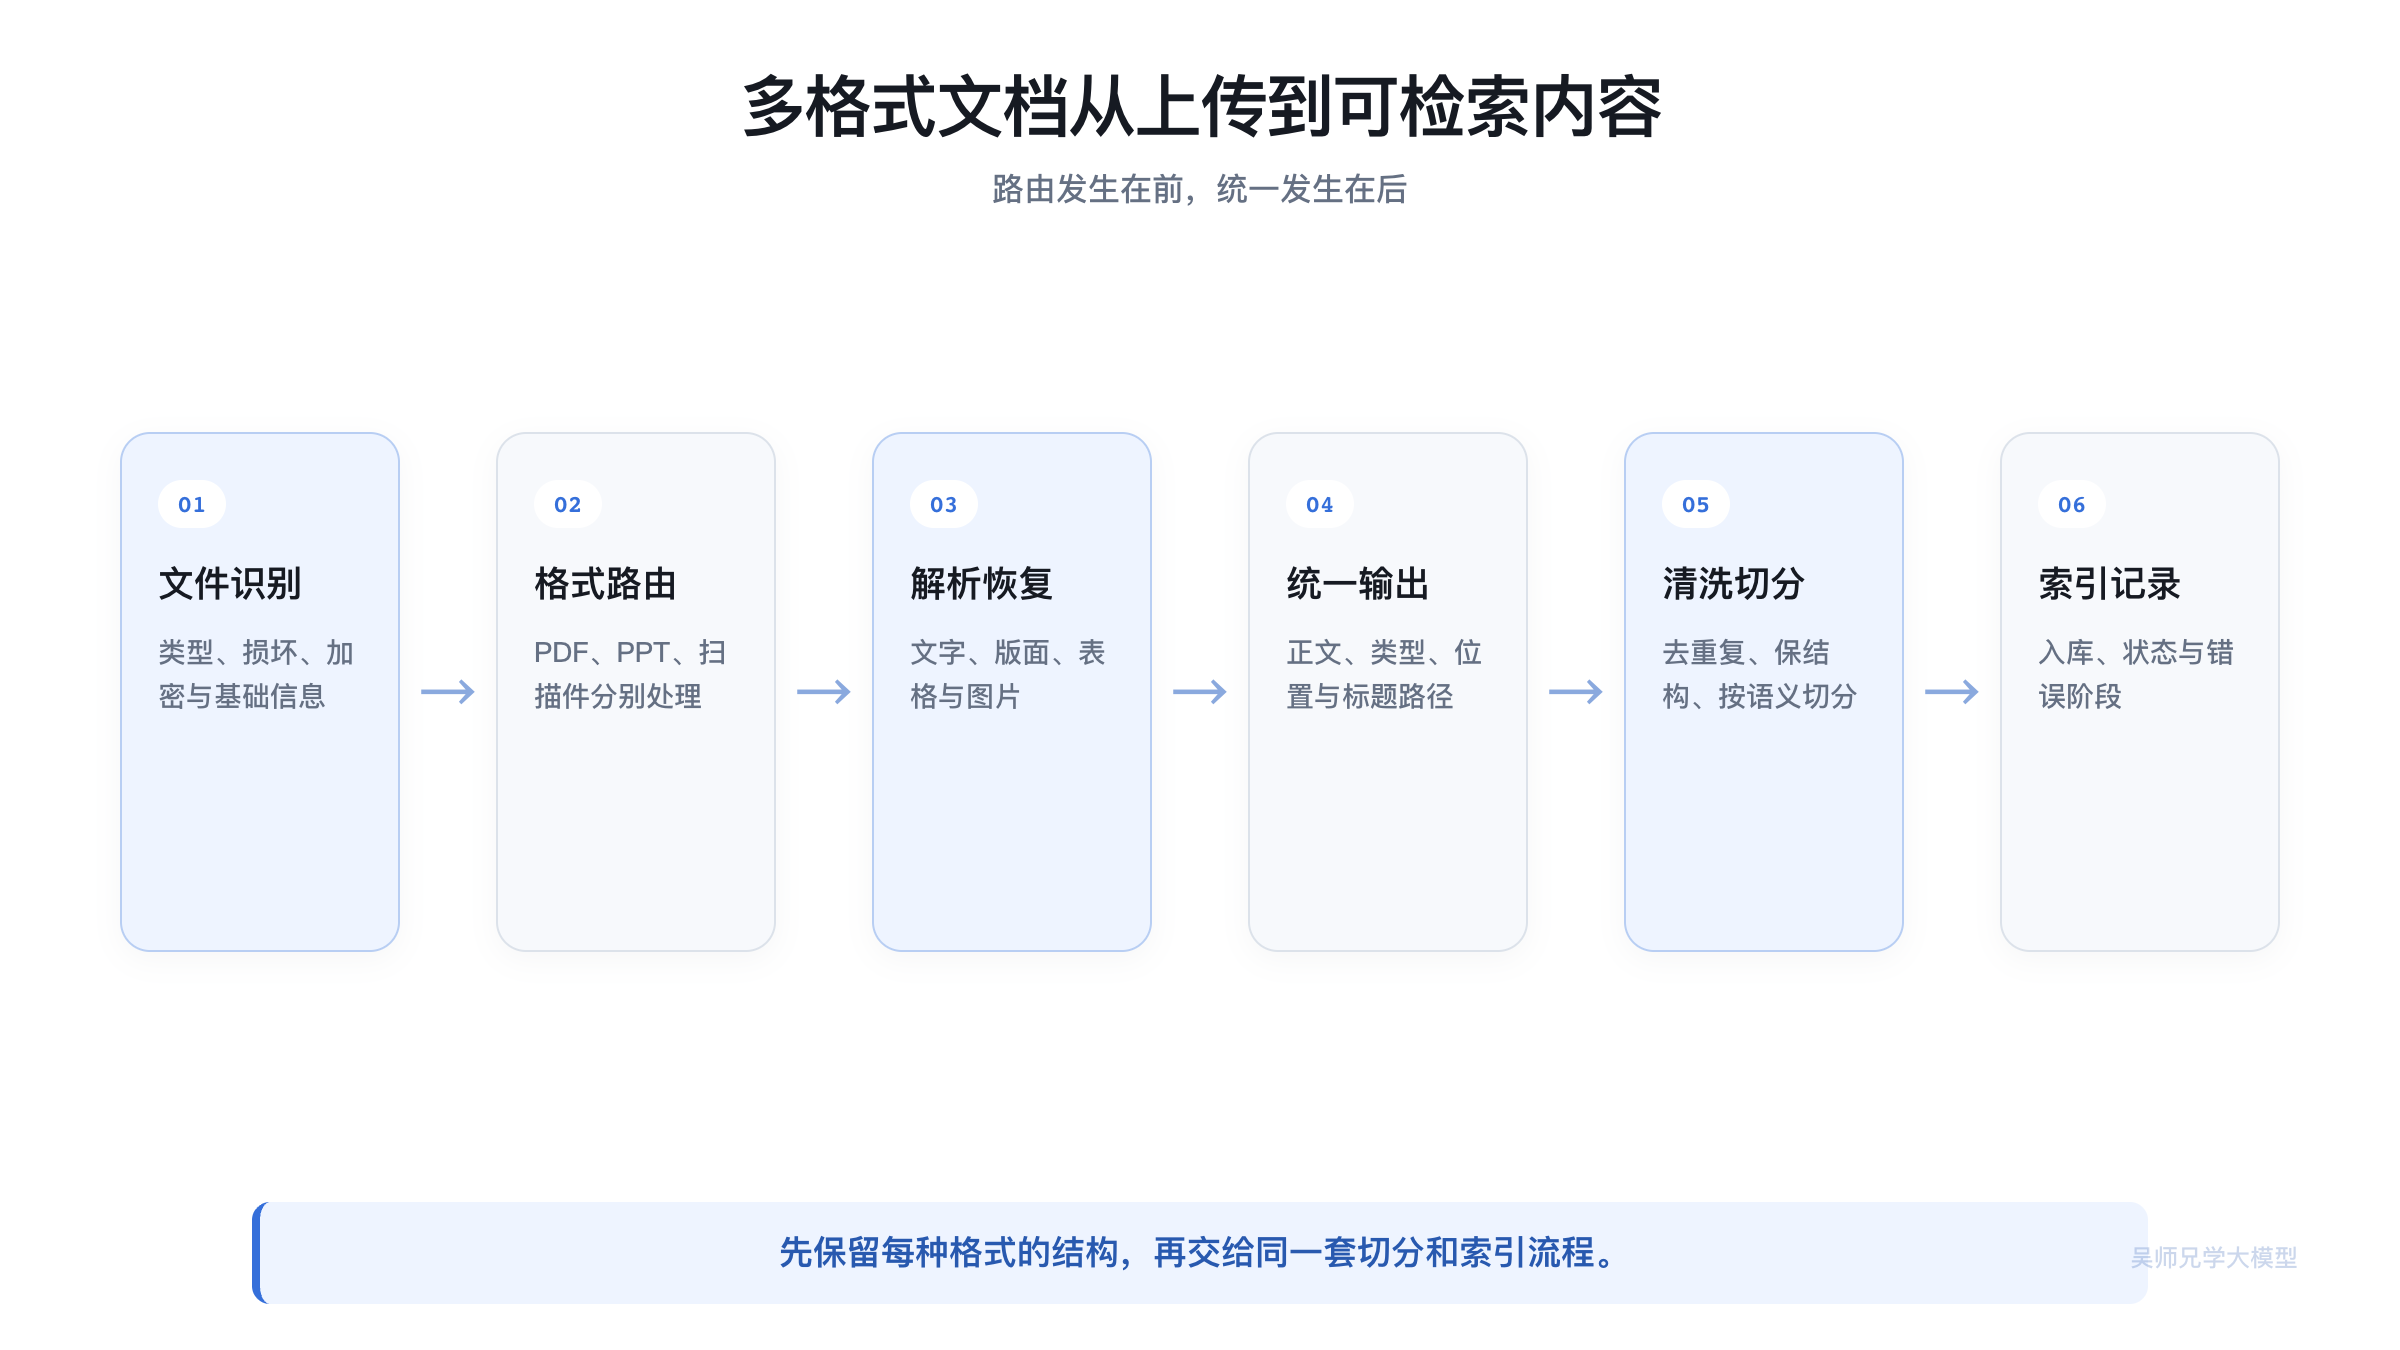
不能先把所有文件粗暴转成纯文本。PDF 需要处理字符层、布局和页码,PPT 要保留标题、项目符号与页序,扫描件要经过 OCR,视频则依赖字幕与时间戳。工程上应先按格式路由到不同解析器,再统一输出正文、内容类型、层级路径、位置和来源字段。
先看一个多格式入库场景。
同一个知识库页面里,用户上传了一份制度 PDF、一套培训 PPT 和一张扫描图片。三个文件都显示“上传成功”,但这并不等于它们已经变成了可以检索的知识。
有的 PDF 能直接读取字符,有的整页只是一张图片。PPT 的标题、项目符号和页序本身就在表达结构。扫描件没有可复制的正文,必须先经过文字识别。三类文件若都粗暴转成一大段纯文本,格式虽然统一,标题、位置、表格关系和图片信息却可能一起消失。
这对应一道 RAG 项目面试题:
PDF、PPT 和扫描件应该怎样进入同一个知识库?为什么不能只写一个通用解析函数?
一种常见但不完整的回答是:“判断文件后缀,调用不同的库,再把文字拼起来。”
这只能算说出了入口。面试官还会追问:不同解析器统一什么?页面只成功一半怎么办?怎样证明内容能够被检索,而不是只拿到一堆字符?
为什么“上传成功”不等于“可以检索”?
文件上传解决保存问题。RAG 入库要把内容转成可搜索、可引用、能定位到原文的单元。
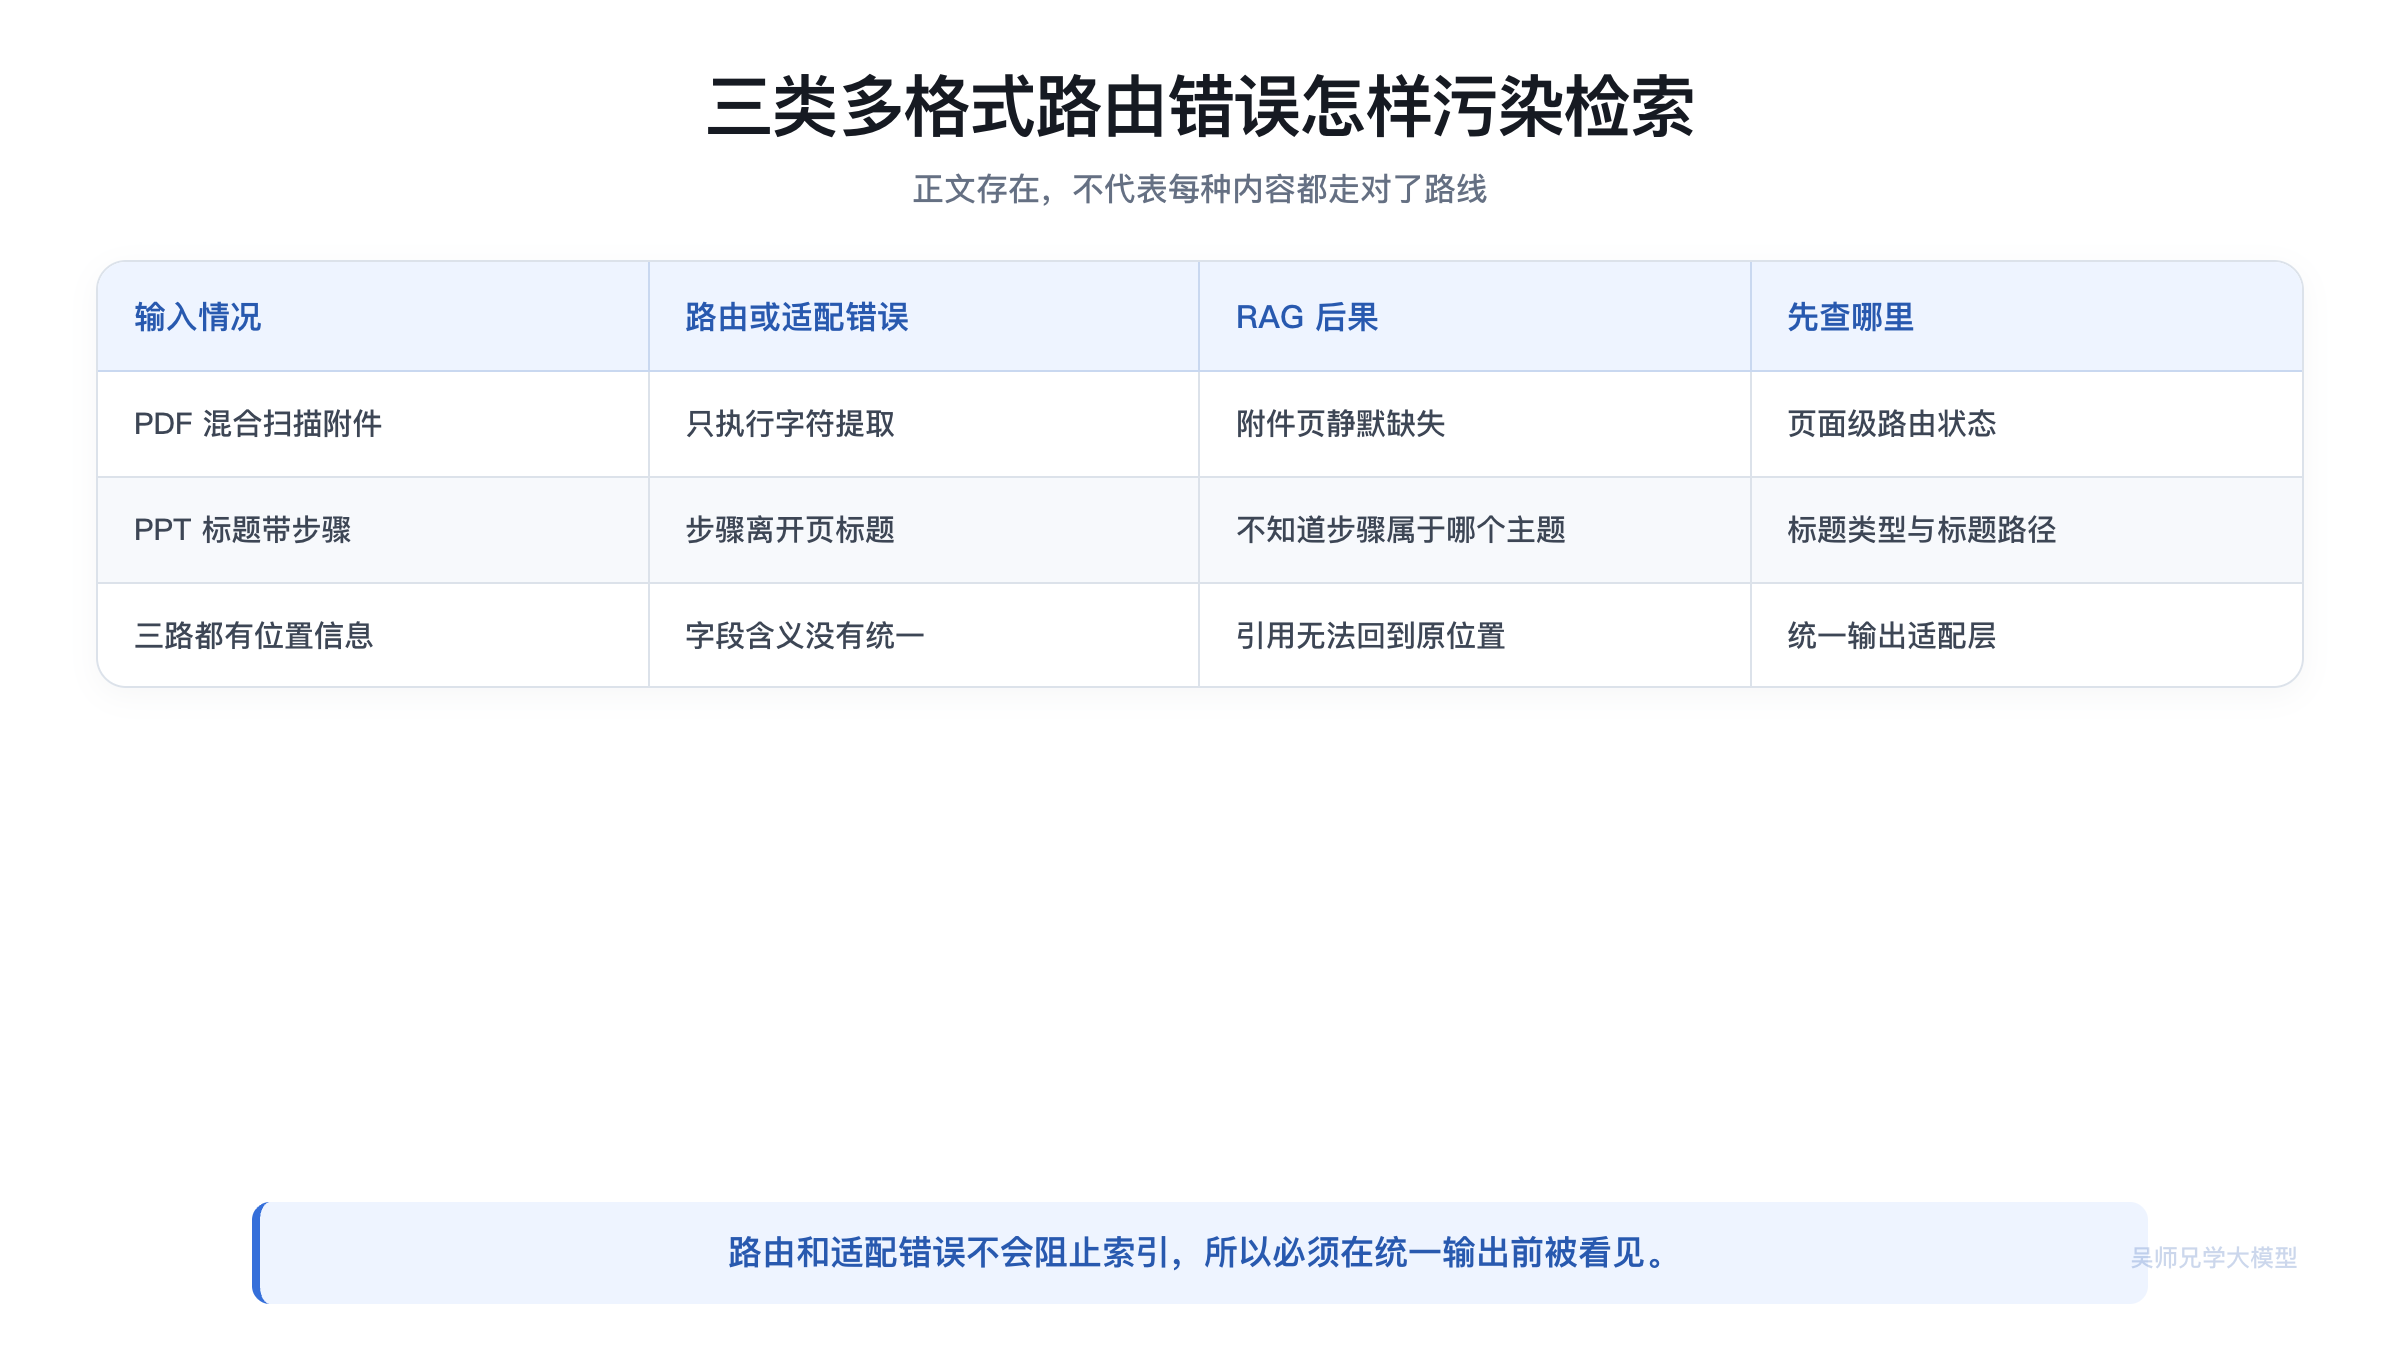
RAG 可以分成离线知识入库和在线问答两个阶段。文档解析处在离线阶段最前面。解析器交给后面的内容如果已经丢失或错乱,分块、向量化和入库仍可能正常运行,只是它们会忠实地处理一份错误材料。
多格式入库首先判断“知识以什么形式存在”,不能只看文件能不能打开。
电子 PDF 的正文可能存在字符层,可以按页读取文字,但多栏排版、表格和浮动图片仍需要版面信息。扫描 PDF 看上去也是 PDF,页面内部却可能只有图像。PPT 不是一篇连续文章,一页中的标题、文本框、项目符号、图片和备注共同组成一张幻灯片。纯文本没有复杂版面,却还可能遇到编码与段落清洗问题。
只按扩展名分流还不够。同一个 PDF 中可能前几页有字符层,后几页是扫描附件。文件级判断之后,还要保留页面级判断和降级入口。
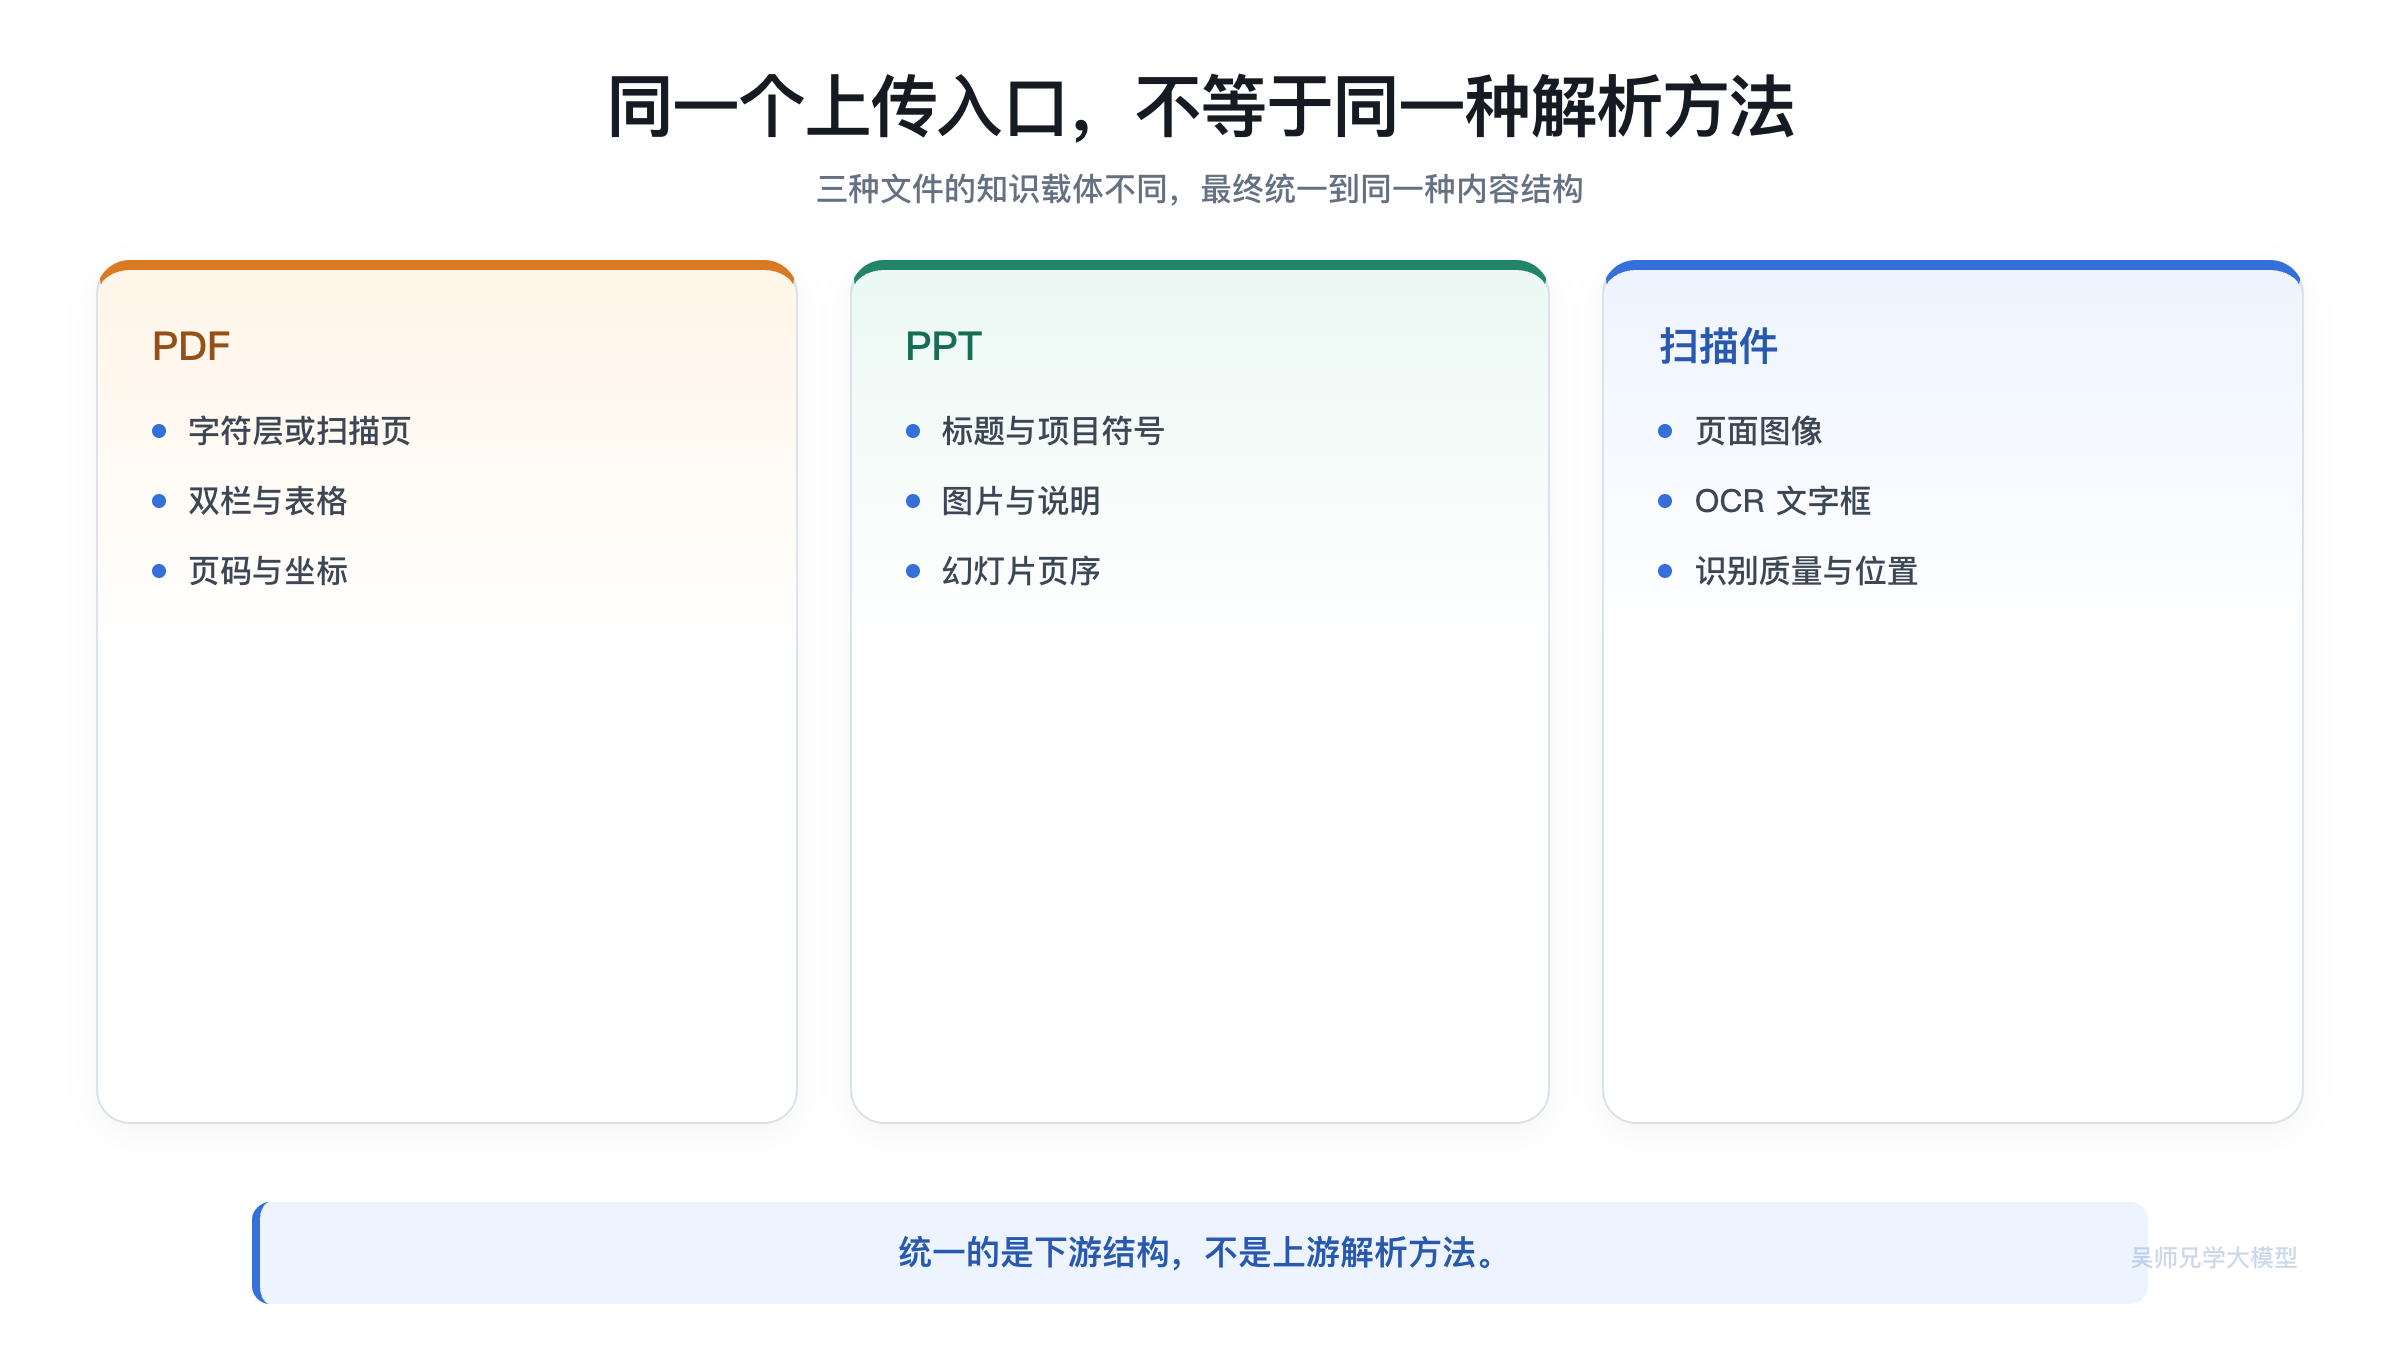
文件可以从同一个入口上传,但内容形态不同。统一的是最后交给下游的结构,不是上游处理方法。
这张图有个关键边界。解析器负责忠实恢复内容、结构和位置,不负责生成漂亮答案。后面的检索器按问题找证据,大模型再根据证据组织回答。
一条多格式解析链路应该怎么走?
继续追问 · 4 个问题
- 你支持哪些文件类型,每种格式进入哪个解析器?
- 统一输出结构里,哪些字段对检索和引用是必需的?
- 解析器失败时是终止整份文件,还是按页降级?
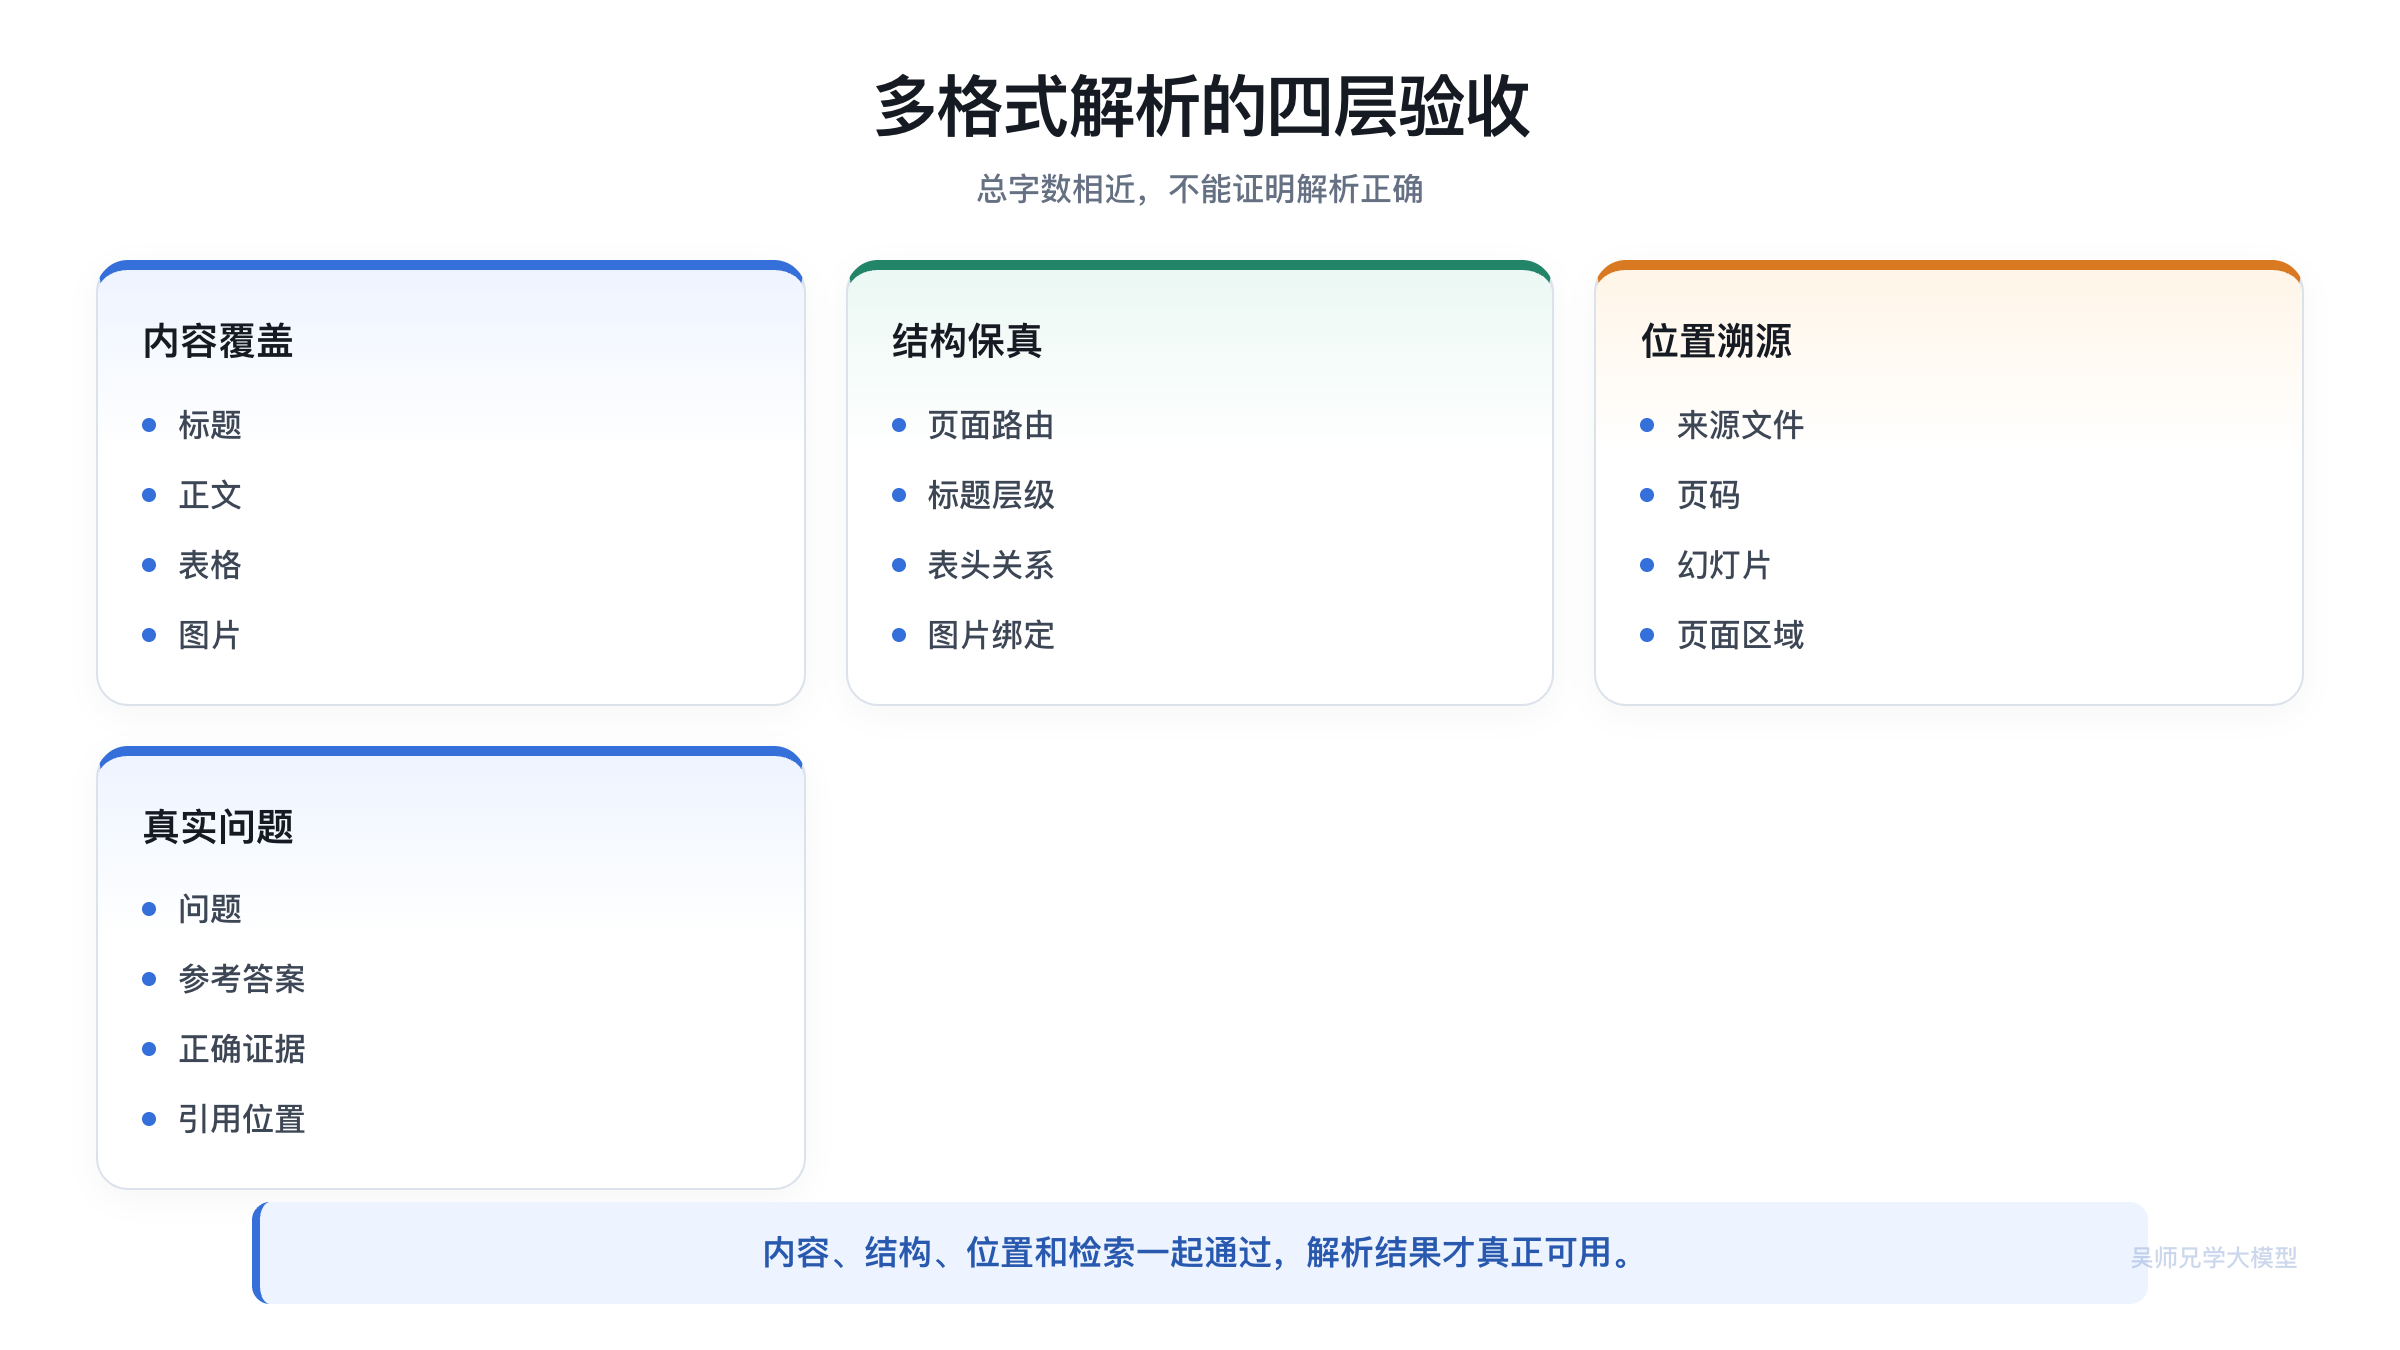
- 如何证明统一格式后没有丢掉表格、标题和页码?
回答前,逐项自查
- 画出格式路由与统一输出结构
- 准备每类文件的一份失败样本
- 说清解析失败后的降级路径
- 展示一个 chunk 的正文与 metadata