跳到主内容RAG 知识库如何动态更新?重复上传怎么做到不重复、不漏写? · AlgoMooc面试题 · RAG 项目面试题
RAG 知识库如何动态更新?重复上传怎么做到不重复、不漏写?
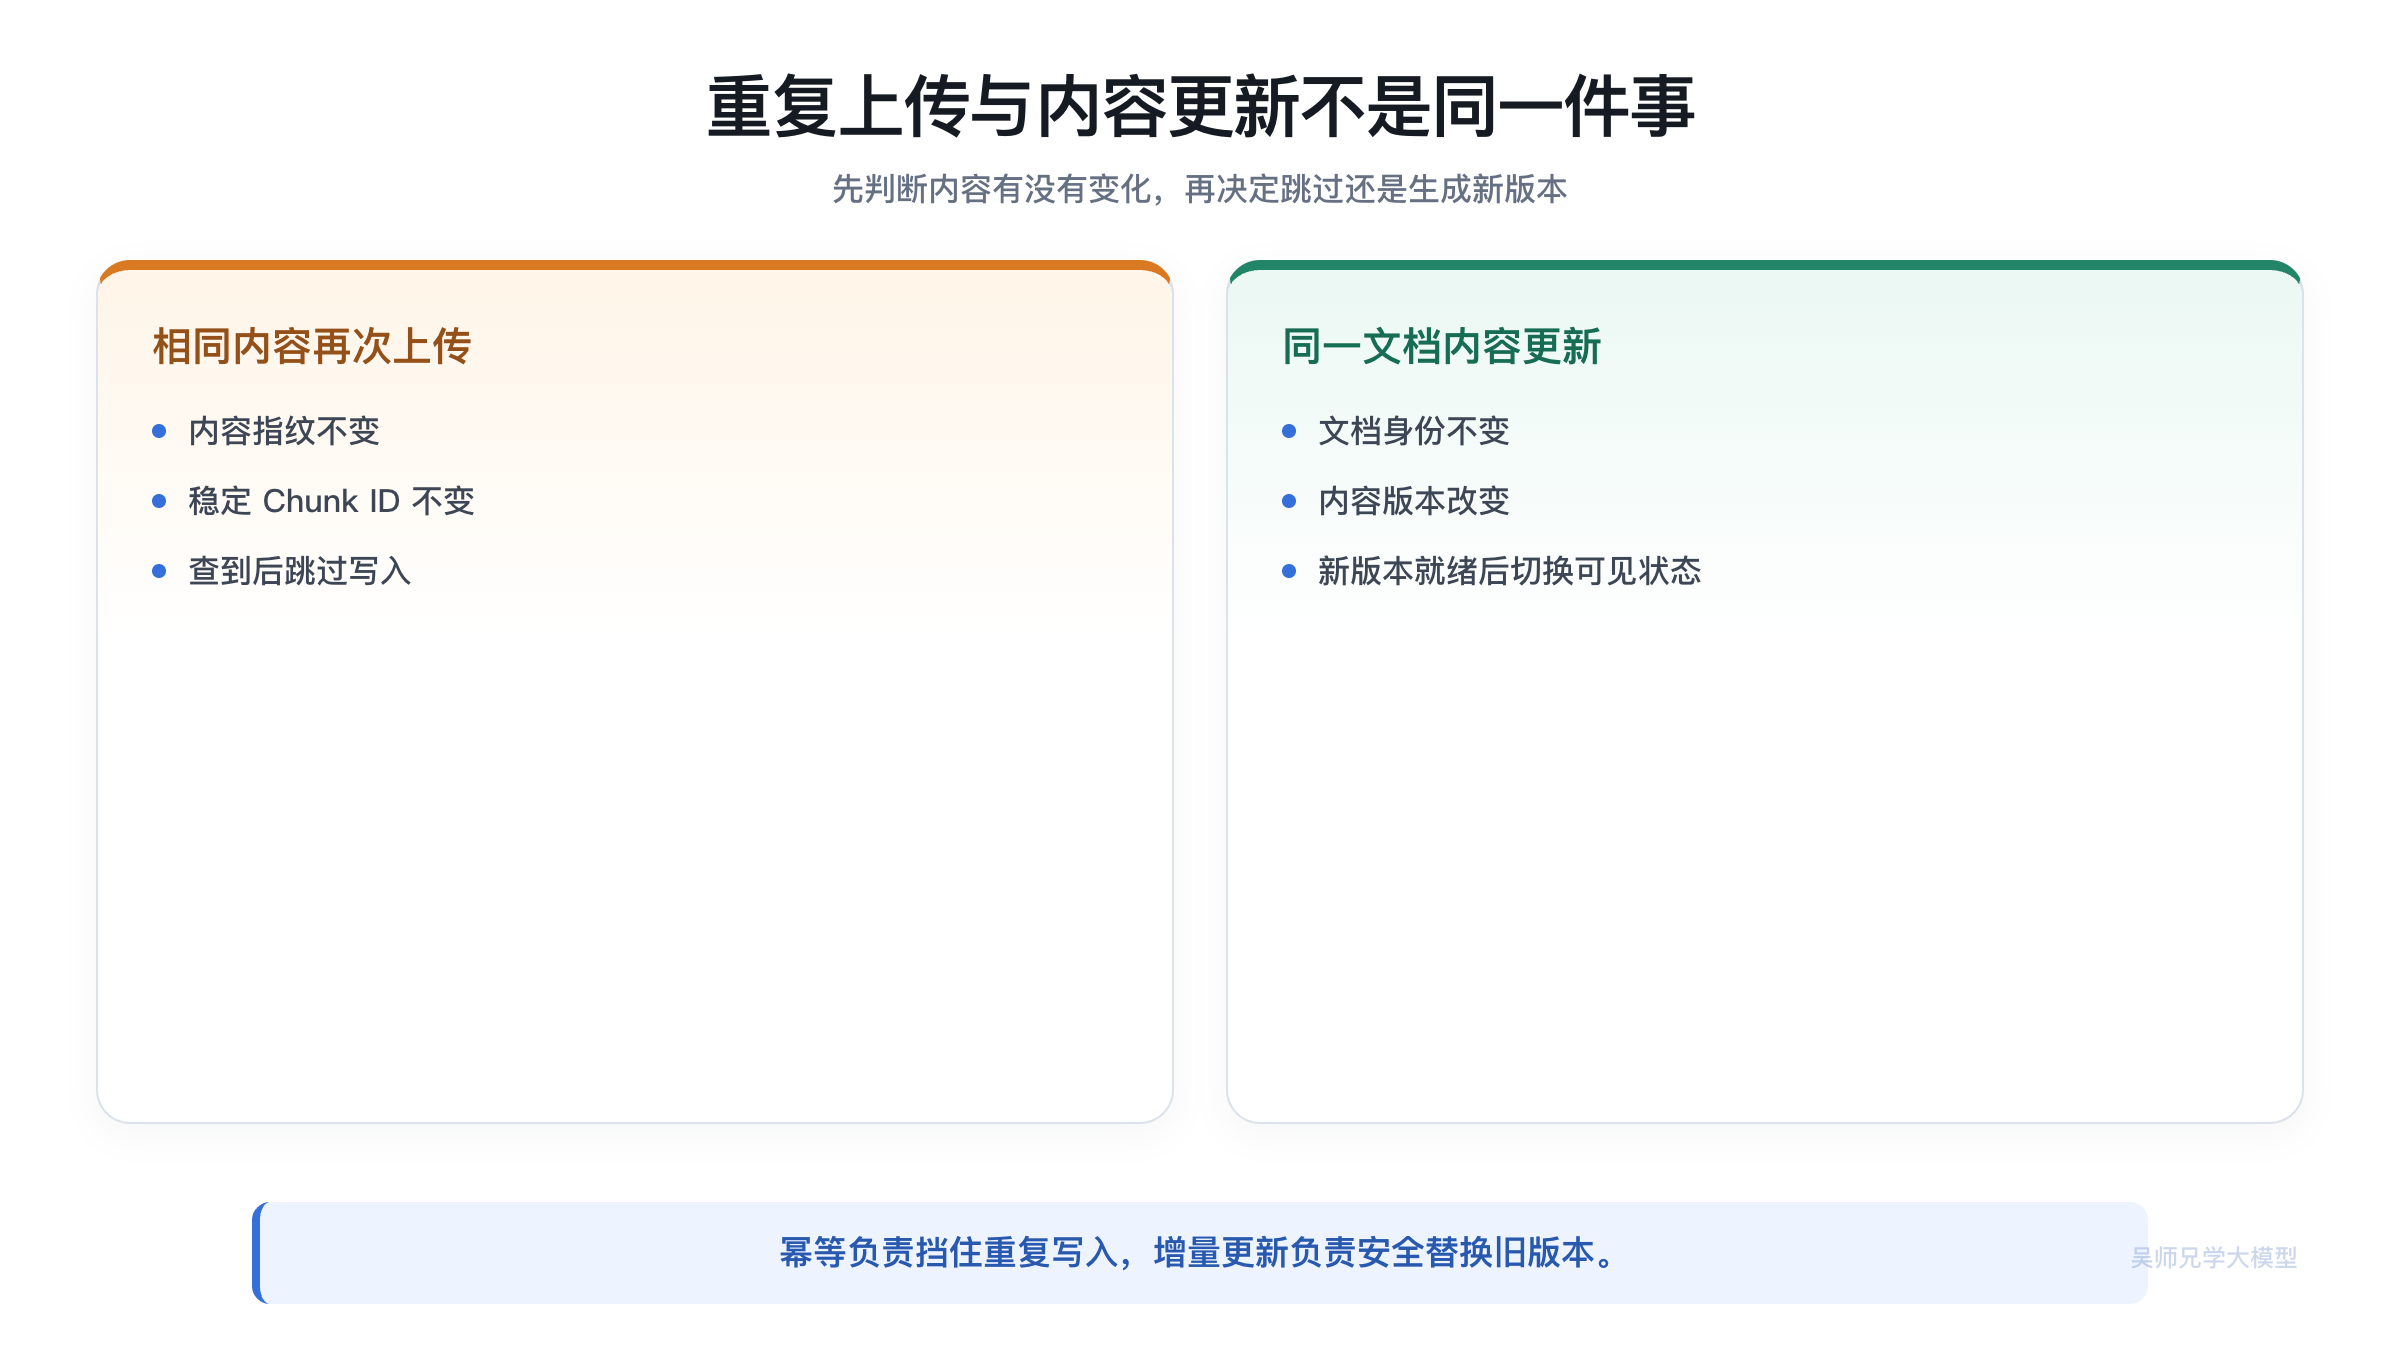
这条思路最关键的不是选哪种哈希算法,而是先定义“同一个 Chunk”到底由什么决定。
文件名不变,正文可能已经修改;文件改名,正文也可能完全相同。多个知识库还可能各自出现同名文件,如果 ID 没有包含知识库范围,就可能发生不该有的碰撞。
两份不同制度可能恰好引用同一段通用说明。它们虽然文字相同,来源、权限和版本却不同。用户查看引用时,也必须回到正确文档。
因此,一个可讨论的稳定 ID 通常要组合几类信息:知识库或租户范围、稳定文档标识、内容位置或结构标识、规范化内容。
去掉无意义空白、统一换行,能避免排版差异制造新 ID。但如果把标点、数字或大小写全部抹掉,原本不同的条款也可能被误判为相同。
更稳妥的是让文档在首次进入系统时获得稳定身份,后续改名仍指向同一文档。至于一份同内容文件上传到另一个知识库,是复用向量还是保存独立记录,要根据权限与引用需求决定,不能只看哈希相同就跨范围合并。
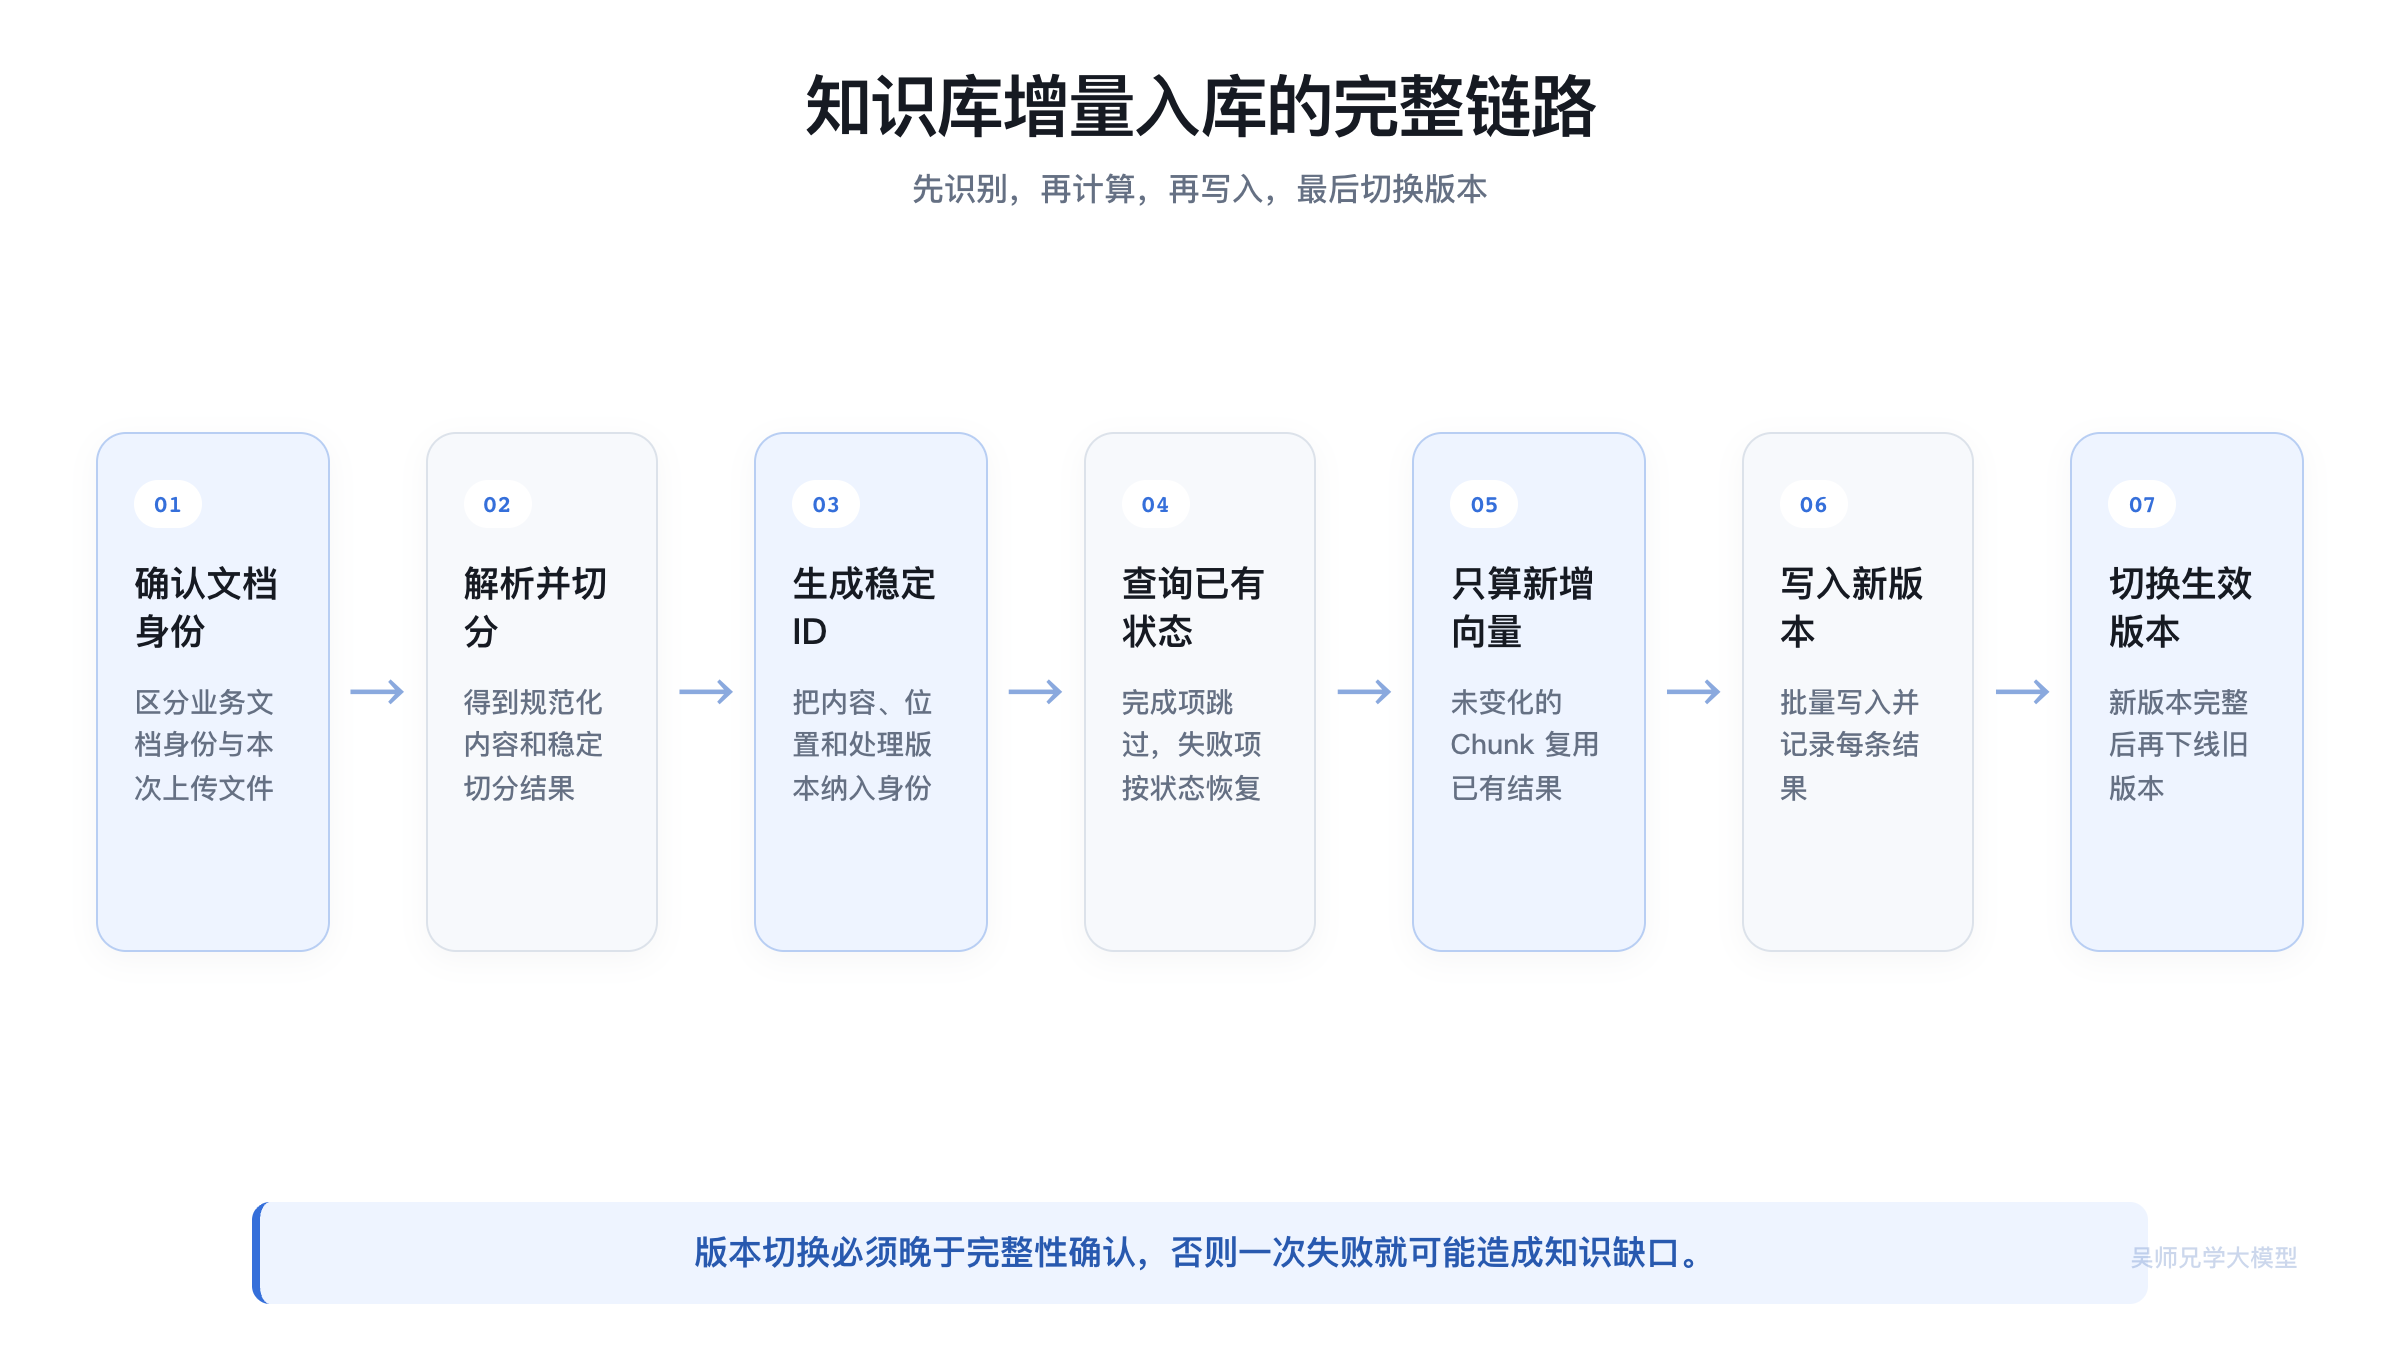
一条增量入库链路应该怎么走?
第四步,为每个 Chunk 计算稳定 ID,并批量查询哪些 ID 已经存在。
第五步,只把新增或变化的 Chunk 送去计算 Embedding。
第六步,批量写入文本、向量、来源、版本和状态等字段,并逐条检查结果。
第七步,记录新增、跳过、失败以及待清理的旧 ID,完成文档版本校验。
这七步最好落成显式状态,而不是依靠一条任务日志猜进度。文档版本可以依次处于“已接收、解析完成、待向量化、部分写入、校验通过、当前有效、已停用”。Chunk 也记录自己是否已生成向量、是否成功写入。重试读取状态后只推进尚未完成的步骤,并且每次状态转换都检查前置条件。
下面是一段教学伪代码,只说明“按状态补齐”和“校验后发布”的顺序:
version = load_or_create_version(document_id, source_digest)
chunks = parse_if_needed(version)
embed_missing(chunks)
upsert_missing(chunks)
verify_complete(version)
publish_if_newer(document_id, version)
load_or_create_version 必须在并发下返回同一个版本身份,upsert_missing 必须使用稳定 Chunk ID,publish_if_newer 则要防止旧任务晚到后覆盖新版本。任何一步失败都保留已完成结果,但不会让未校验版本进入普通检索。
稳定 ID 把查重放在 Embedding 之前。新增内容进入向量化和批量写入,失败与旧版本分别进入恢复和清理流程。
把查重放在 Embedding 之后,虽然也能避免向量库重复,却已经浪费了最昂贵的计算之一。
只在内存里去重也不够。任务重启或换一台工作节点后,内存状态会丢失。是否存在应该以持久化存储中的稳定 ID 与版本状态为准。
如果两个任务同时处理同一内容,它们可能都查到“不存在”,随后同时写入。稳定 ID 应当由存储层唯一约束兜底。即使两个工作进程都走到写入,最终也只能留下同一个身份的记录。
幂等不能只靠“先查一下”,还要让最终写入本身可重复。
文件只改了一段,旧 Chunk 怎么处理?
假设原文中的办理时间发生修改。新段落生成新 ID 并成功写入,旧段落仍然留在索引里。用户搜索时,两版内容可能一起被召回。
文档更新的目标是让一组新 Chunk 成为当前版本,同时让旧版本退出正常检索。
一种更安全的流程是先生成新版本全部 Chunk,在隔离状态完成数量、字段和关键证据校验。确认新版本完整后,再切换文档的当前版本标记,最后异步清理旧版本。
因为解析、Embedding 或批量写入都可能在中途失败。如果先删旧版,新版又只写入一部分,知识库就会出现缺口。
因为相关不等于可用。旧条款和新条款往往都能匹配同一个问题,检索器很难仅凭语义判断哪个是当前有效版本。
版本字段应该参与检索范围,而不是只作为展示信息。正常搜索只选择当前有效版本,审核或历史查询再显式进入旧版本。
即使原文件没改,只要切分算法升级,Chunk 边界就可能全部变化。系统需要把切分版本纳入处理记录,并明确这次是内容更新还是索引重建,避免把两类变化混在一起统计。
Bulk 一部分成功,一部分失败怎么办?
批量写入不是一个只有“成功”和“失败”的整体结果。
一批记录里,可能大部分已经成功,只有少数因为字段类型、内容长度或临时连接问题失败。如果只看到请求返回异常就整批重试,成功项也会再次进入写入路径。
如果 ID 和写入操作是幂等的,整批重试未必产生重复,但会增加无效请求,也会掩盖真正不可恢复的错误。
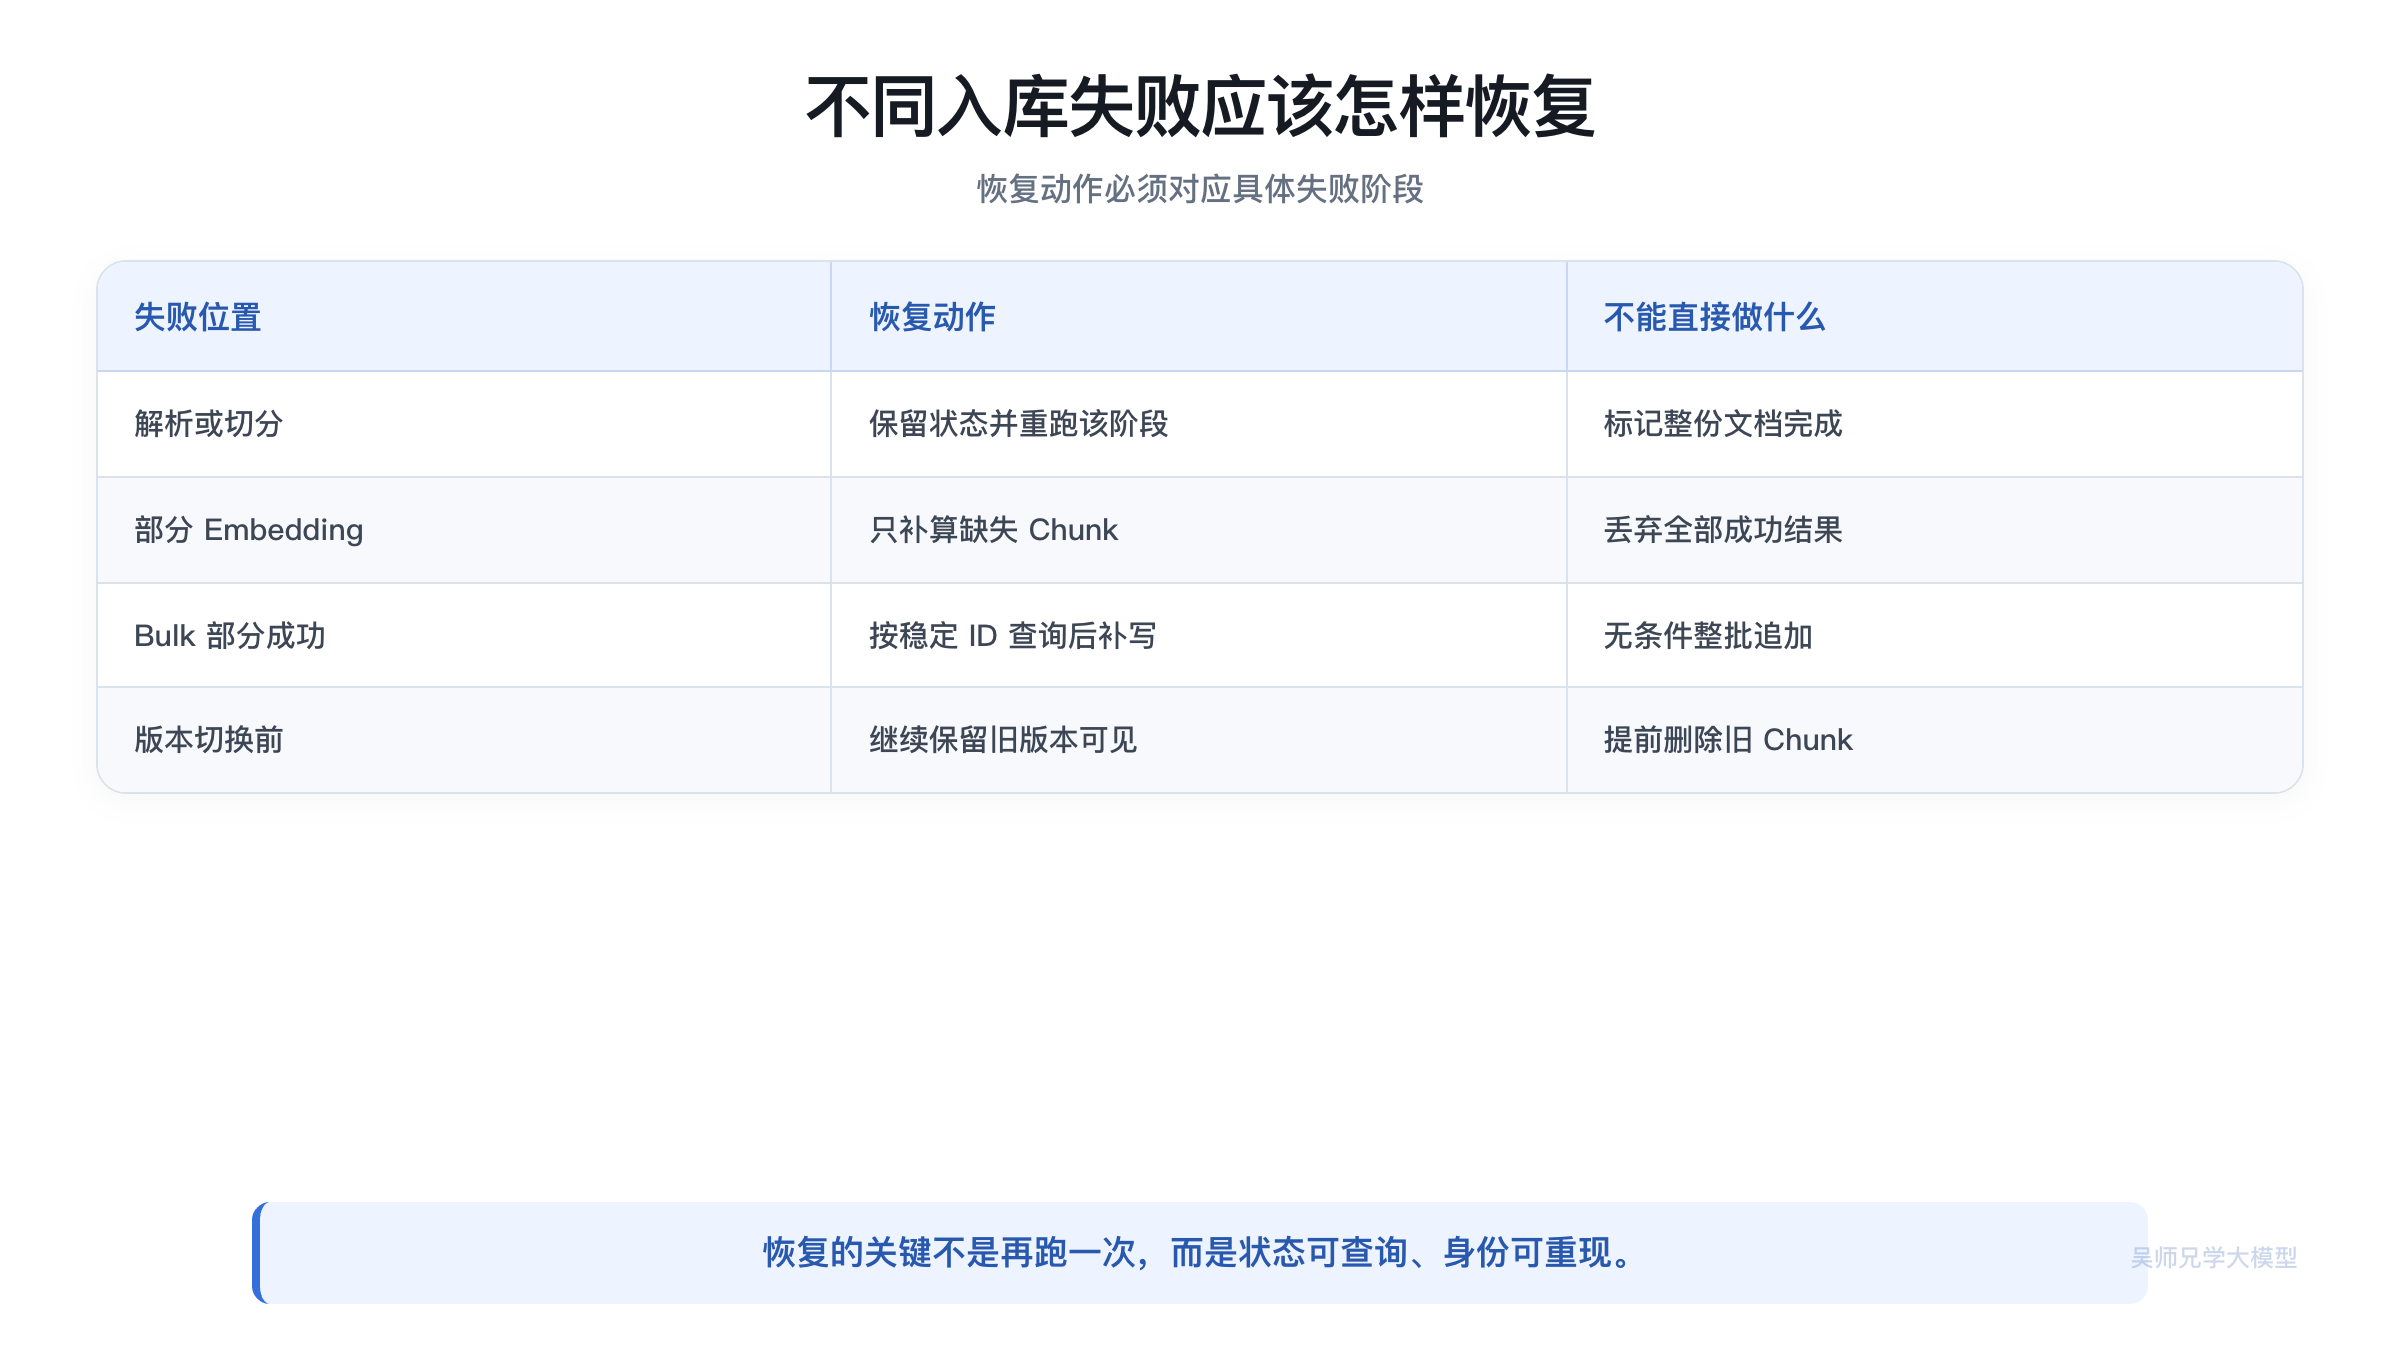
更稳妥的是逐条检查返回结果,保存成功 ID、失败 ID、错误类型和尝试次数。
连接超时、临时不可用等错误,可以在限制次数内重试。
字段映射错误、缺少必要来源、向量维度不匹配等数据问题,重复发送同一内容不会自己变好。它们应当保留现场,修复数据或配置后再补写。
超过重试边界的记录进入待处理队列,不能让任务永远循环。
临时错误可以有限重试,数据错误需要修复,已成功项保持原状态。相同稳定 ID 让补跑只补缺口。
系统应记录 Chunk 当前处于待向量化、向量完成、待写入、已写入还是失败状态。补跑时从未完成步骤继续,而不是重新解析和计算所有内容。
如果 Embedding 模型升级,旧向量不能直接与新模型输出混用。缓存键和记录里要带模型版本,这属于模型迁移,不应被普通重复上传逻辑静默跳过。
失败恢复还要区分“请求是否超时”和“服务端是否写入”。客户端看到超时,不代表后端一定没有完成。如果重试时换了随机 ID,就可能留下两份记录;继续使用相同稳定 ID 做 upsert,才能让未知结果收敛到同一状态。对不支持幂等写入的外部服务,可以为每个批次保存请求身份和已确认的结果,再逐条对账,不能只根据一次 HTTP 状态推断整批结果。
任务统计也应来自持久化状态,而不是进程内计数器。工作进程崩溃后,内存里的“成功 90 条”没有恢复价值;稳定 ID、步骤状态和错误类型才能告诉新进程还差哪些内容。恢复完成后重新核对目标 ID 集合与当前有效集合,避免某条记录既被计为成功,又没有真正进入可检索版本。
并发任务怎样避免互相覆盖?
用户可能连续点击两次,同一文件也可能被定时同步与手工上传同时触发。两个任务如果各自完成查重,再并发计算和写入,就会形成竞争。
即使两个任务都认为某个 Chunk 不存在,写入时仍使用同一个 ID,存储层的唯一约束会让它们指向同一记录,而不是各自生成一份随机身份。
每个文档版本应知道自己正在解析、等待向量化、部分写入、校验完成、已成为当前版本,还是已经失败。后来的任务看到前一个版本仍在处理中时,需要按产品语义决定复用、排队或取消,而不是直接把状态覆盖成成功。
新版本的 Chunk 可以逐步写入隔离区域,但只有整版校验通过,才更新“当前版本”指针。这个切换动作应当明确,不能让用户查询在一个请求里同时读到半套新版和半套旧版。
旧内容退出当前检索,不等于立刻物理删除。可以先标记为非当前版本,确认新版本稳定后再清理。这样失败回退时仍有可恢复对象,也避免删除任务与查询任务互相干扰。
假设版本 B 已经成为当前版本,较早启动的版本 A 任务此时才完成。系统不能因为 A 最后写完,就把当前版本重新切回 A。切换时需要比较文档版本或任务代次,只允许符合预期的新版本生效。
因此,幂等不只发生在 Chunk 写入。文档状态迁移、版本切换和清理任务也要可重复执行,并且在重试后保持同一结果。
锁与幂等也不是同一件事。文档级锁可以减少两个任务同时工作,但锁可能超时、进程可能崩溃,消息也可能被重复投递。幂等保证即使竞争仍然发生,重复执行也不会破坏最终状态;锁只是降低重复计算。面试里若只回答“给上传接口加分布式锁”,还没有解释锁失效后的正确性。
清理任务同样需要稳定范围。它只能删除某个文档版本中已经被新版本替代、且不再被当前指针引用的 Chunk。若按“文件名相同”批量删除,改名、回滚或并发发布都可能误伤。先切换可见版本,再按明确版本身份清理,失败后重复运行仍应得到相同结果。
四种更新故障,先查身份还是先查写入?
四种故障对应四类不同证据:重复先查稳定身份,改名先查文档边界,局部更新先查版本集合,补跑失败先查逐条任务状态。
同一文件连续上传两次
第二次应识别出相同稳定 ID。检查新增数是否保持不变,跳过列表是否对应已有 Chunk,Embedding 是否没有再次处理这些内容。
如果记录数没增加但 Embedding 仍全部重算,说明只做到了存储去重,没有做到计算去重。
文件改名后再次上传
如果改名仍表示同一文档,文档身份不应跟着文件名变化。如果它被视为一份新来源,也要确保引用、权限和版本都独立。
测试的重点不是强求唯一答案,而是验证身份规则与预期一致。
只修改一个段落
检查未变化块是否保持相同 ID,变化块是否生成新 ID,新版本完整后旧块是否退出当前检索。
再用能命中新旧内容的问题回归,确认正常搜索不会同时返回冲突版本。
批量写入中注入一条非法记录
检查成功项是否保留,失败项是否记录具体原因,修复后重跑是否只补写失败内容。
还要确认重试次数受控,字段错误不会被当作临时故障反复发送。
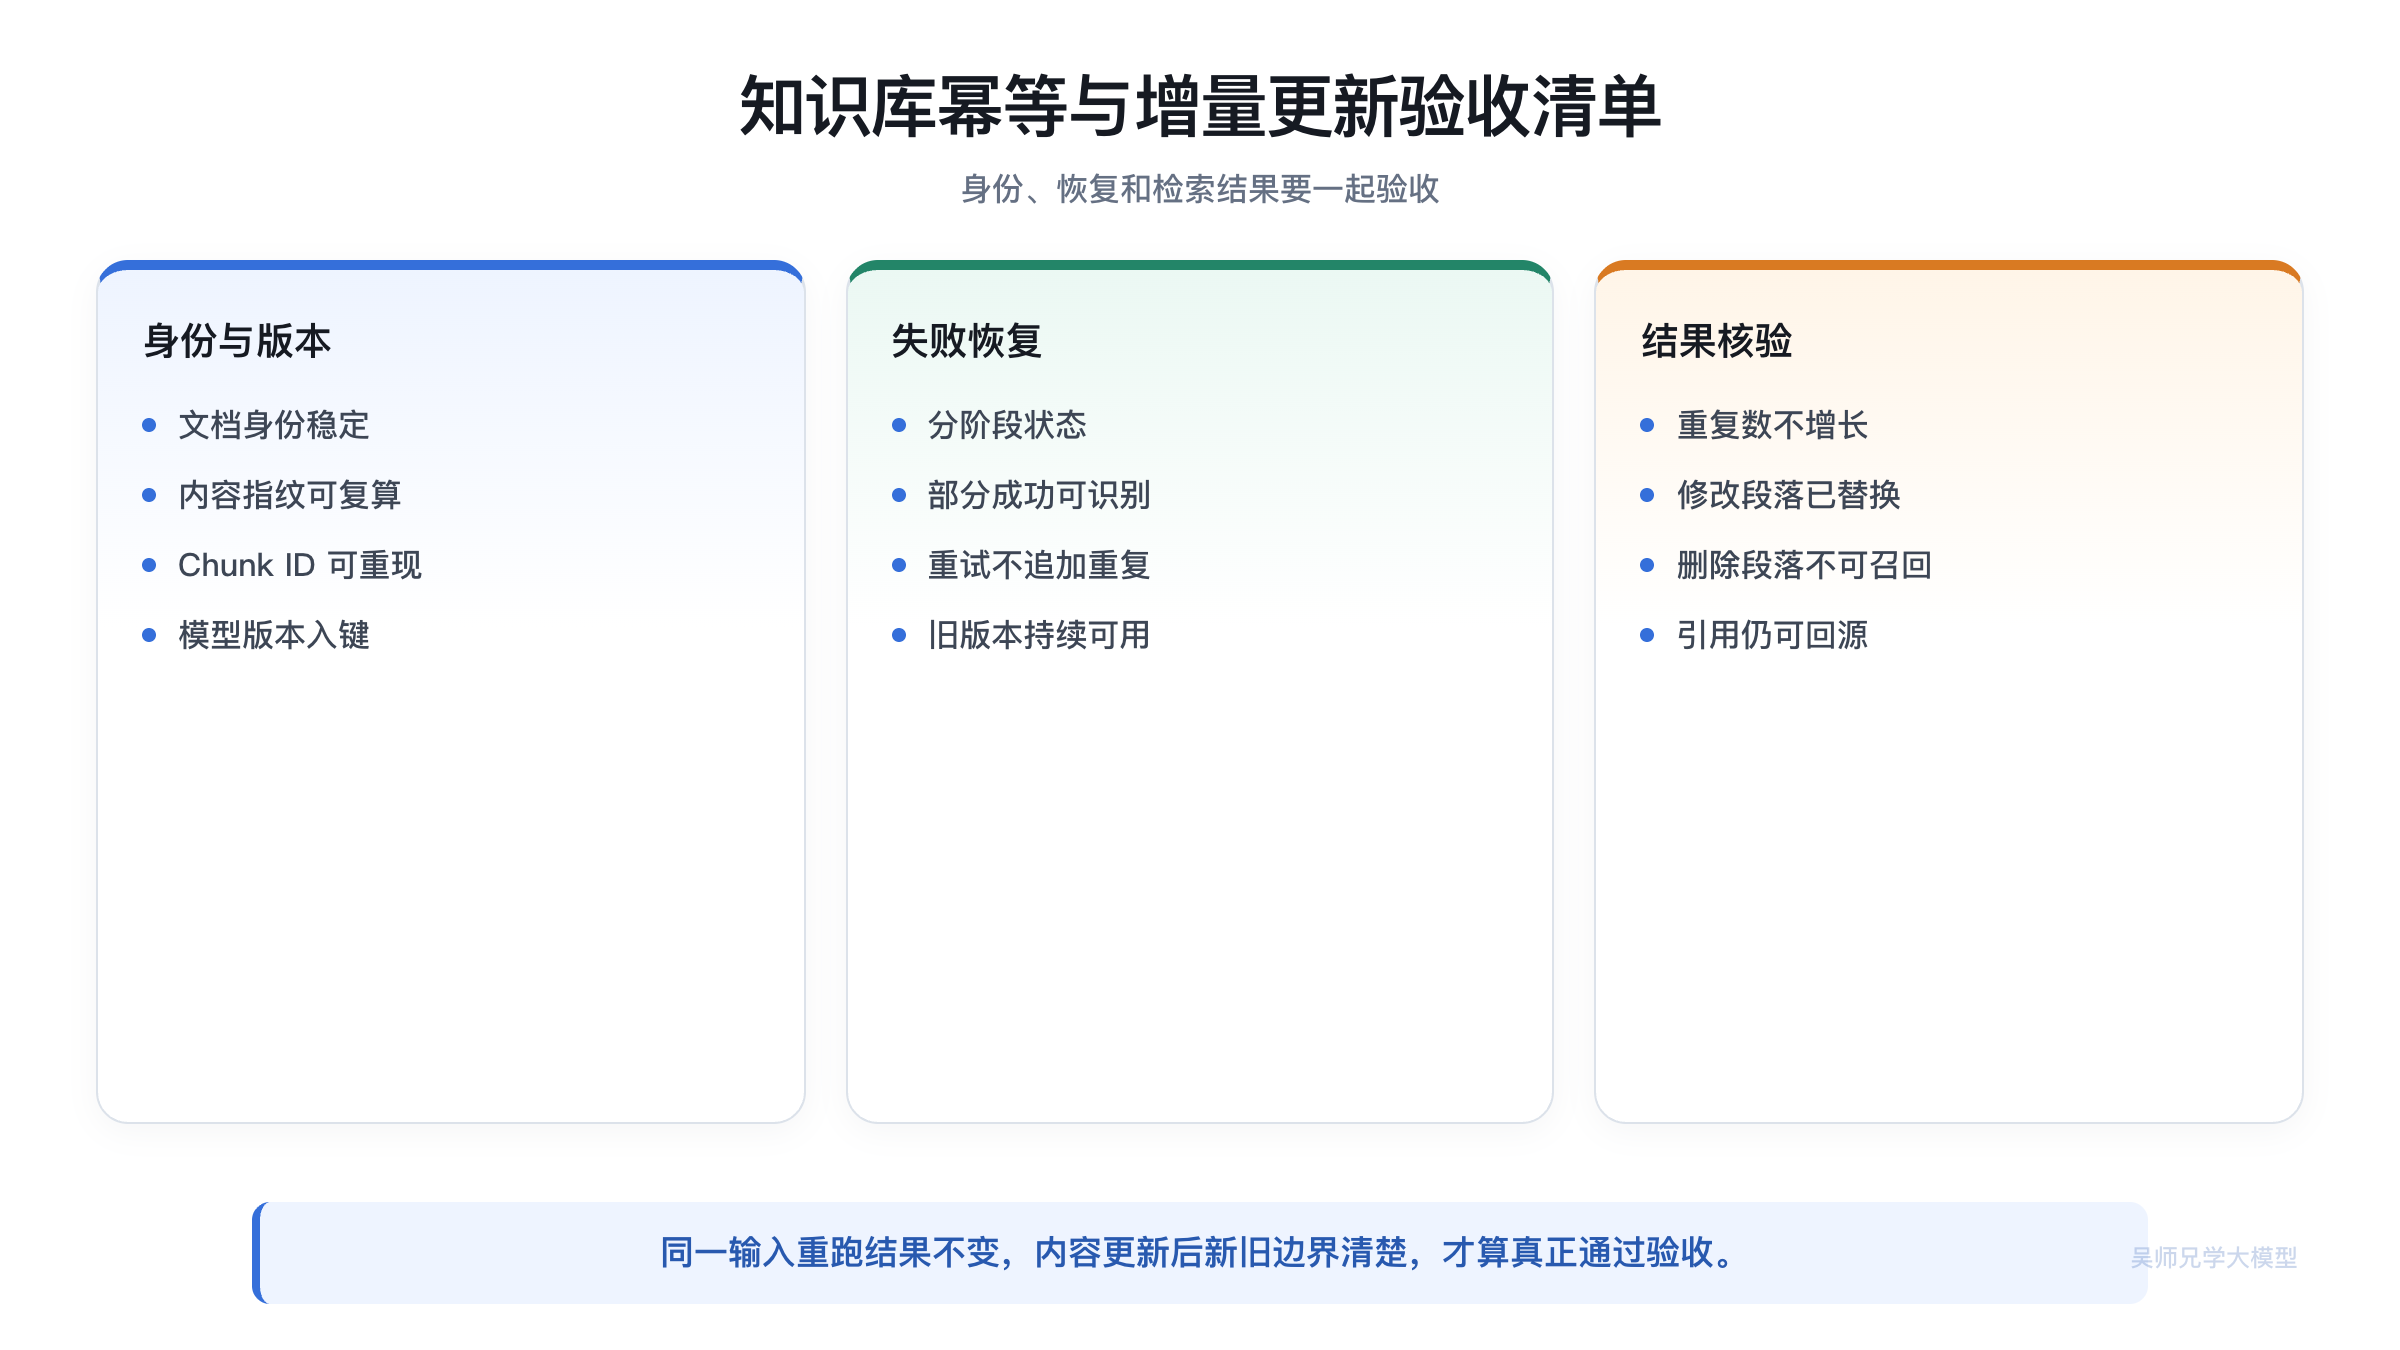
怎么证明幂等真的成立?
总数不变,可能是任务把旧内容覆盖错了;总数增加,也可能是文档确实新增了内容。
每轮测试至少保留文档版本、Chunk ID 集合、新增 ID、跳过 ID、失败 ID和待删除 ID。
再把测试拆成四组:完全重复、文件改名、局部修改、部分失败。
部分失败验证成功项不回滚、失败项能补写、不可恢复错误不会无限重试。
数据层看起来正确,不代表检索范围已经正确使用版本字段。给新旧段落各准备问题,检查当前查询只返回有效版本,引用仍能回到正确文件和位置。
可以再加入顺序扰动测试:让旧任务故意比新任务晚完成,让同一消息重复投递,让批量写入在不同位置超时。每次执行后都验证三条不变量:同一稳定身份最多一条当前记录;普通检索只读取一个已校验版本;当前版本的目标 Chunk 集合与实际可检索集合一致。只要其中一条被破坏,就说明系统仍依赖理想执行顺序。
这些测试要用稳定 ID 集合做断言,而不是只比较记录总数。总数相同仍可能少了一条新记录、多留了一条旧记录;集合差异能直接指出缺失、重复和错误生效的身份。把每轮输入版本、预期集合、实际集合与任务状态保存下来,失败后才能原样重放。
还应检查任务统计是否能互相核对。新增、跳过、失败、停用和当前有效 Chunk 的集合要能够解释最终索引状态。若汇总数字对不上具体 ID,报表再漂亮也无法帮助恢复。每次补跑后重新计算集合差异,确认没有既标记失败又已经生效的矛盾记录。
同时检查身份、版本、失败恢复和检索结果,才能证明系统既不重复,也没有漏写或混用旧内容。
幂等追问怎么接:别把“查重”当成答案
回答每个追问时,都要区分内容是否重复、版本是否切换成功,以及任务重跑后最终集合是否一致。
稳定 ID 为什么不能只用文件名?
因为文件名不是内容,也不是稳定身份。它可以在内容不变时被修改,也可以在内容变化时保持不变。ID 至少要考虑知识库范围、文档身份和规范化内容。
内容哈希相同,为什么不全局只存一份?
因为相同文字可能属于不同知识库、权限、版本和引用位置。向量是否复用可以单独设计,但检索记录不能因为文字相同就失去来源边界。
新块成功写入后,旧块为什么不会自动消失?
稳定 ID 只能说明新旧内容不同。删除或停用旧内容属于版本管理,需要在新版本完整校验后切换当前版本,再清理旧记录。
查重以后再写入,为什么仍可能重复?
两个任务可能同时查到不存在。最终存储还要对稳定 ID 做唯一约束,让重复写入在存储层保持同一结果。
批量写入超时,能不能整批重试?
可以重试可恢复错误,但应先读取逐条结果并继续使用相同 ID。更好的做法是只补失败项,同时区分临时错误和数据错误,避免无效循环。
Embedding 模型更新后,旧缓存还能用吗?
不能默认复用。缓存和向量记录应包含模型版本。模型迁移需要重新计算并切换索引,它不是普通重复上传。
从稳定 ID 讲到版本切换
现场时间有限时,按“稳定身份、版本集合、失败补偿”三个层次展开:
我会把重复上传、文档更新和失败重试分成三层。Chunk 先根据知识库范围、稳定文档身份、原文位置和规范化内容生成稳定 ID。入库前批量查 ID,已有块跳过 Embedding,只有新增或变化块进入向量化和写入。最终存储还要用唯一 ID 兜底,避免并发任务同时通过查重后写出两份。
内容变化会产生新 ID,但旧 Chunk 不会自动消失。因此我会先在隔离状态生成并校验新版本,确认完整后切换当前版本,再清理旧内容。正常检索只看当前有效版本,避免新旧条款一起被召回。
对批量写入,我会逐条保存成功和失败 ID,临时错误有限重试,字段错误保留现场等待修复。补跑继续使用相同稳定 ID,只补未完成步骤。验证时覆盖完全重复、文件改名、局部修改和部分失败,并检查新增、跳过、失败、待清理 ID 以及最终检索结果。
收尾时要让面试官听见三个可验证结果:相同输入不会新增记录,新版本校验前不会污染当前检索,部分失败补跑后目标 ID 集合仍然一致。有增量入库经历,就使用自己项目里的身份规则、失败记录和验证结果;没有完成版本切换,就不要把 Chunk 去重描述成完整的动态更新系统。