本文目录
先用 30 秒讲清楚
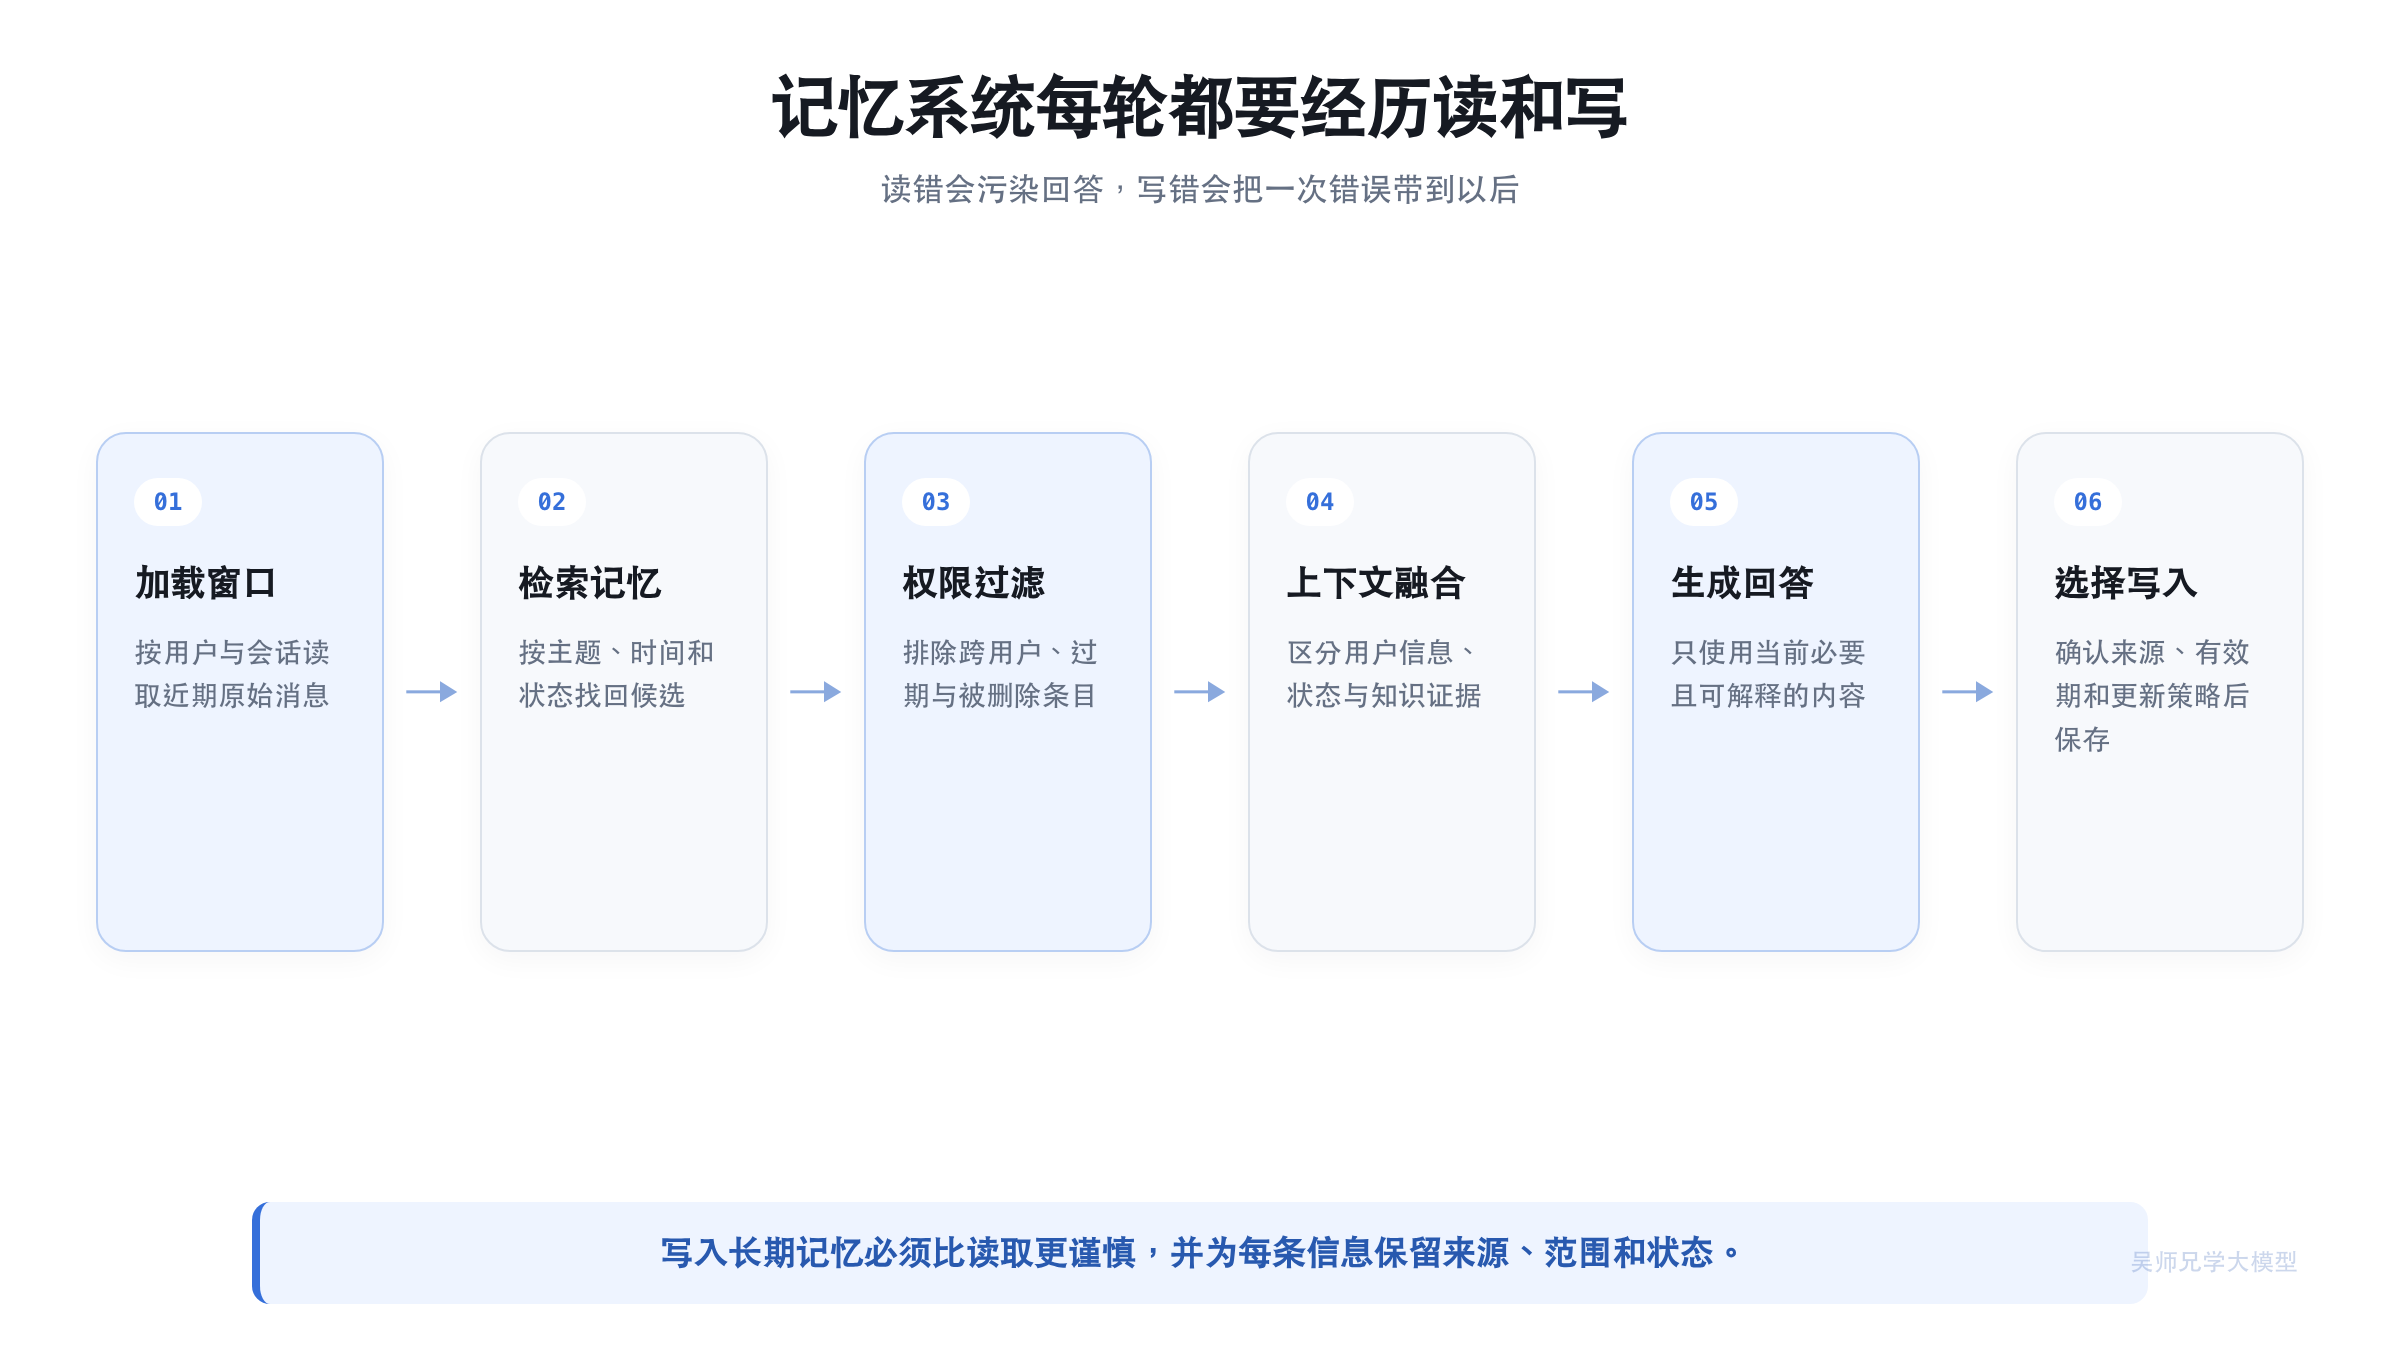
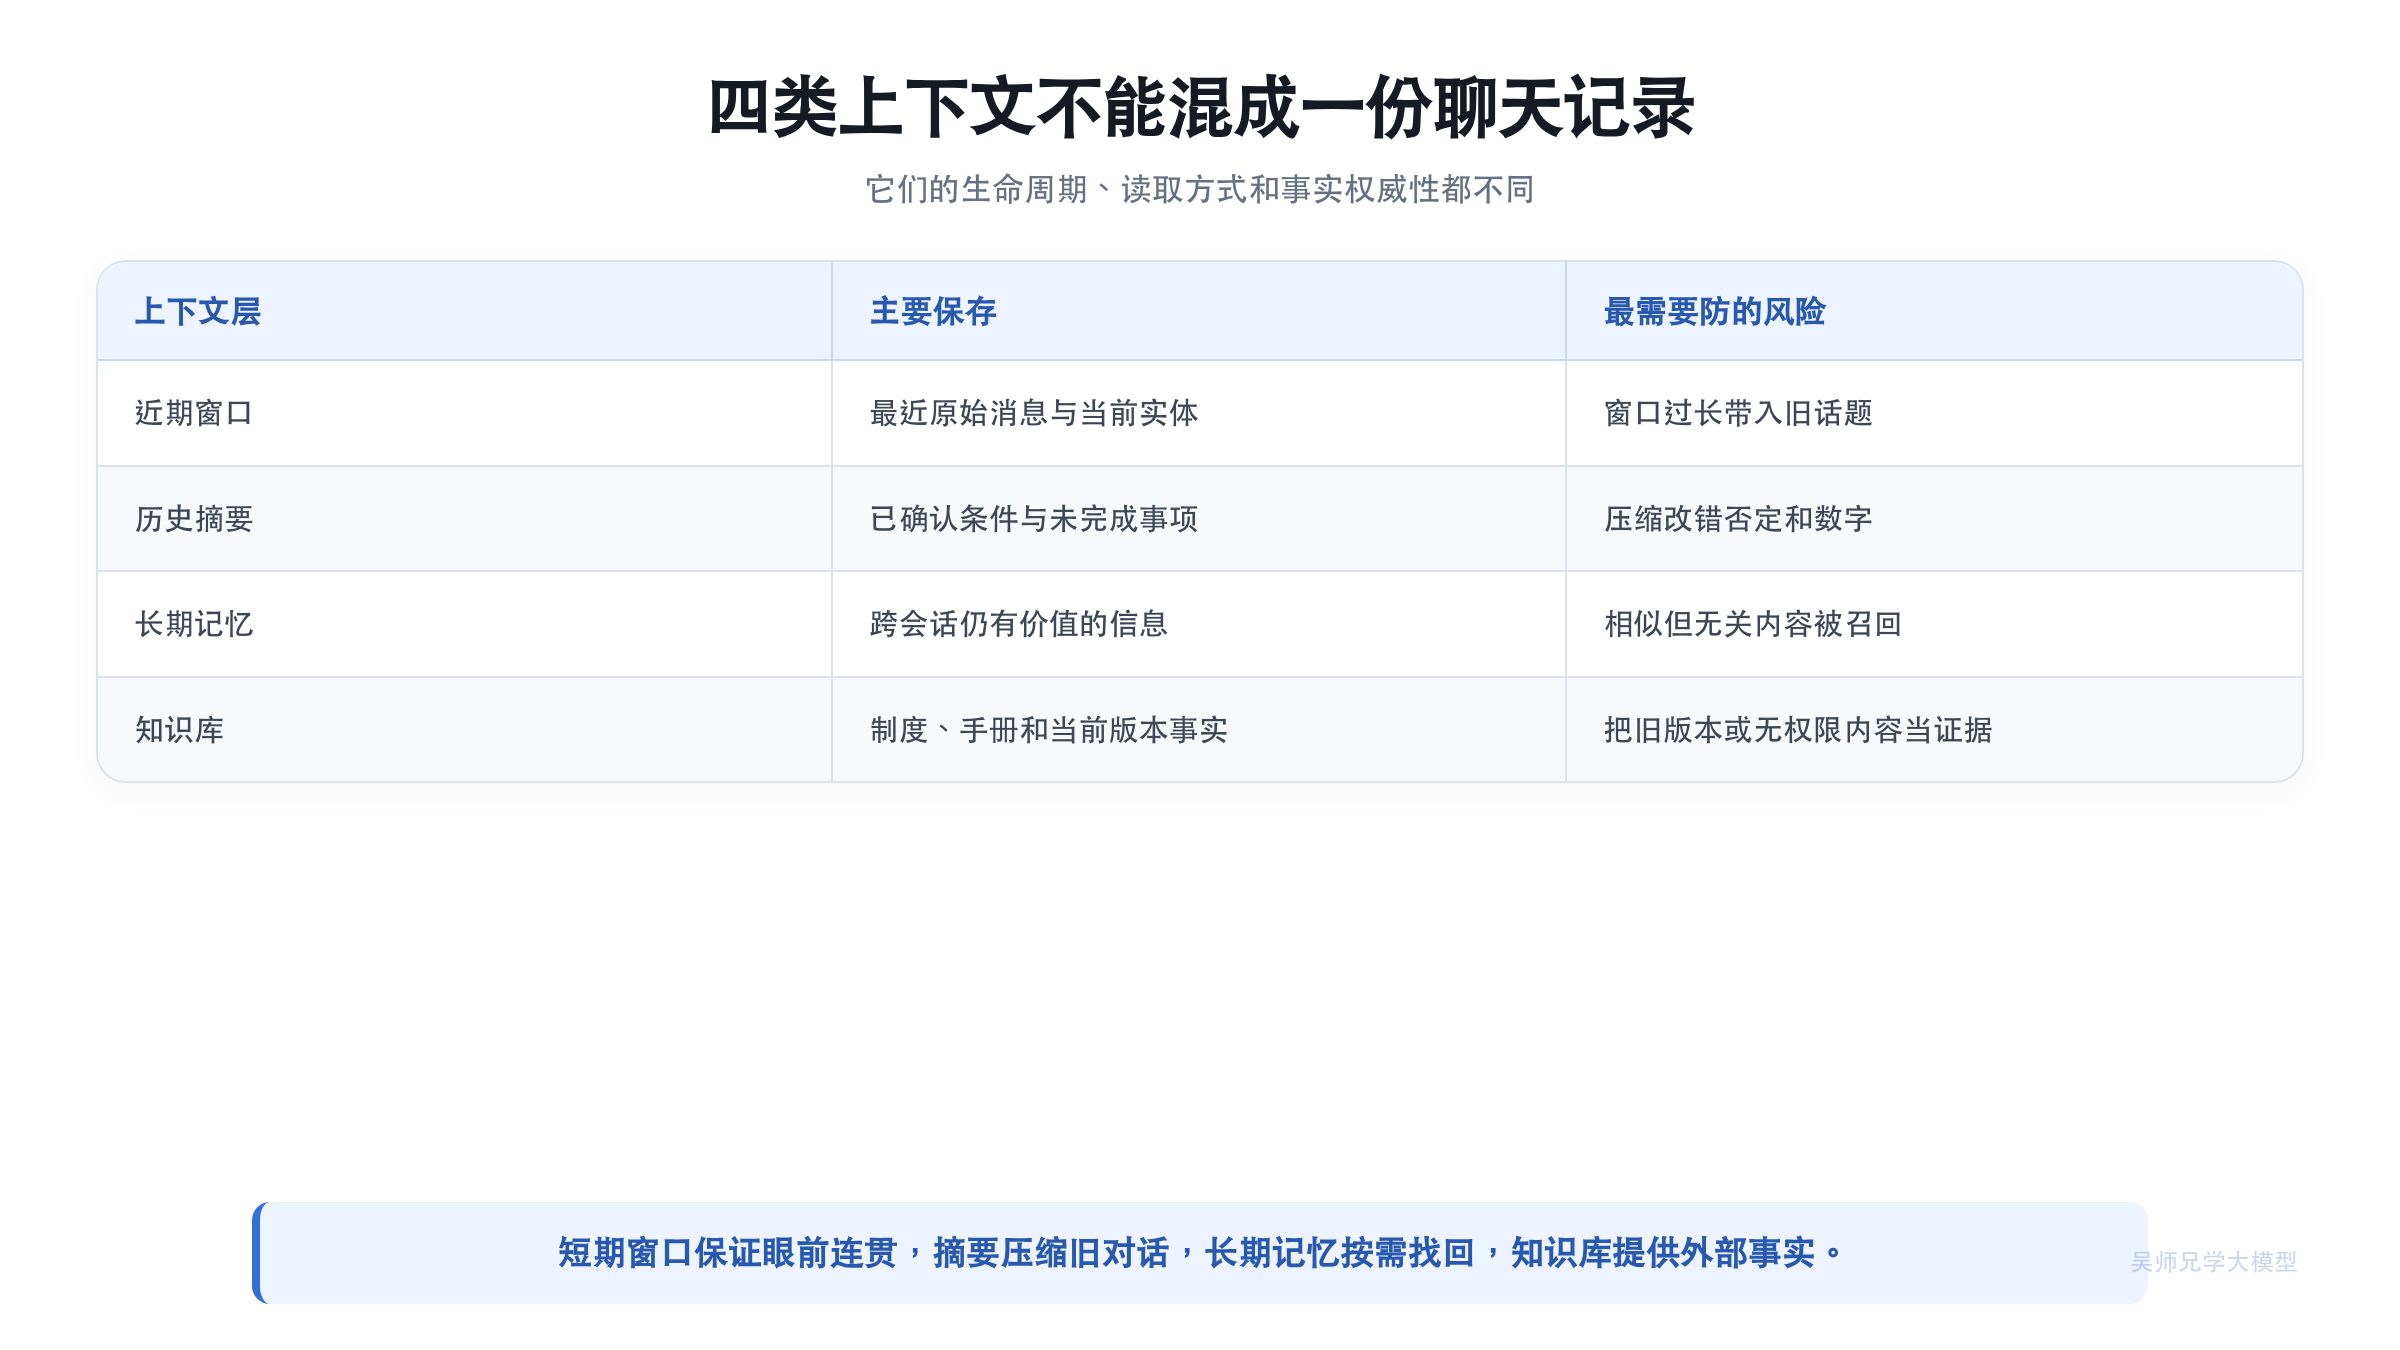
最近几轮适合放在低延迟的会话窗口,较早历史可压缩成摘要;跨会话且需要语义召回的内容再进入向量记忆或持久库。每轮同时从知识库取静态事实、从记忆模块取相关上下文,再经过过滤融合。必须有 TTL、用户隔离、删除与更新策略,避免旧记忆和隐私数据污染当前回答。
先纠正一个概念:聊天记录不等于记忆
聊天记录是原始事件:谁在什么时间说了什么。记忆是系统为了后续任务,从这些事件中选择、整理并允许再次使用的信息。两者如果不区分,系统很快会出现两个极端。
第一个极端是全量拼接。每次请求都把从第一轮开始的全部对话交给模型,Token 会随轮次持续增长,旧话题、寒暄和已经失效的条件也会干扰当前问题。上下文窗口再大,也不意味着所有历史都有价值。
第二个极端是固定保留最近几轮。这能控制长度,却会机械地丢掉较早但仍然重要的信息。例如用户先确认了预算,随后讨论十几轮功能细节;只看最近消息,系统可能忘记最初的约束。
因此记忆管理解决的不是“存不存聊天”,而是四个更具体的问题:哪些内容值得保留,保留到哪一层,什么时候应该取回,以及何时必须更新或删除。
多轮 Query 改写关注的是“怎样结合最近对话把当前问题补完整”;本题继续往后追问,专门讨论历史如何写入、隔离、更新、过期和删除。两个问题会使用同一段对话,但验收目标不同。
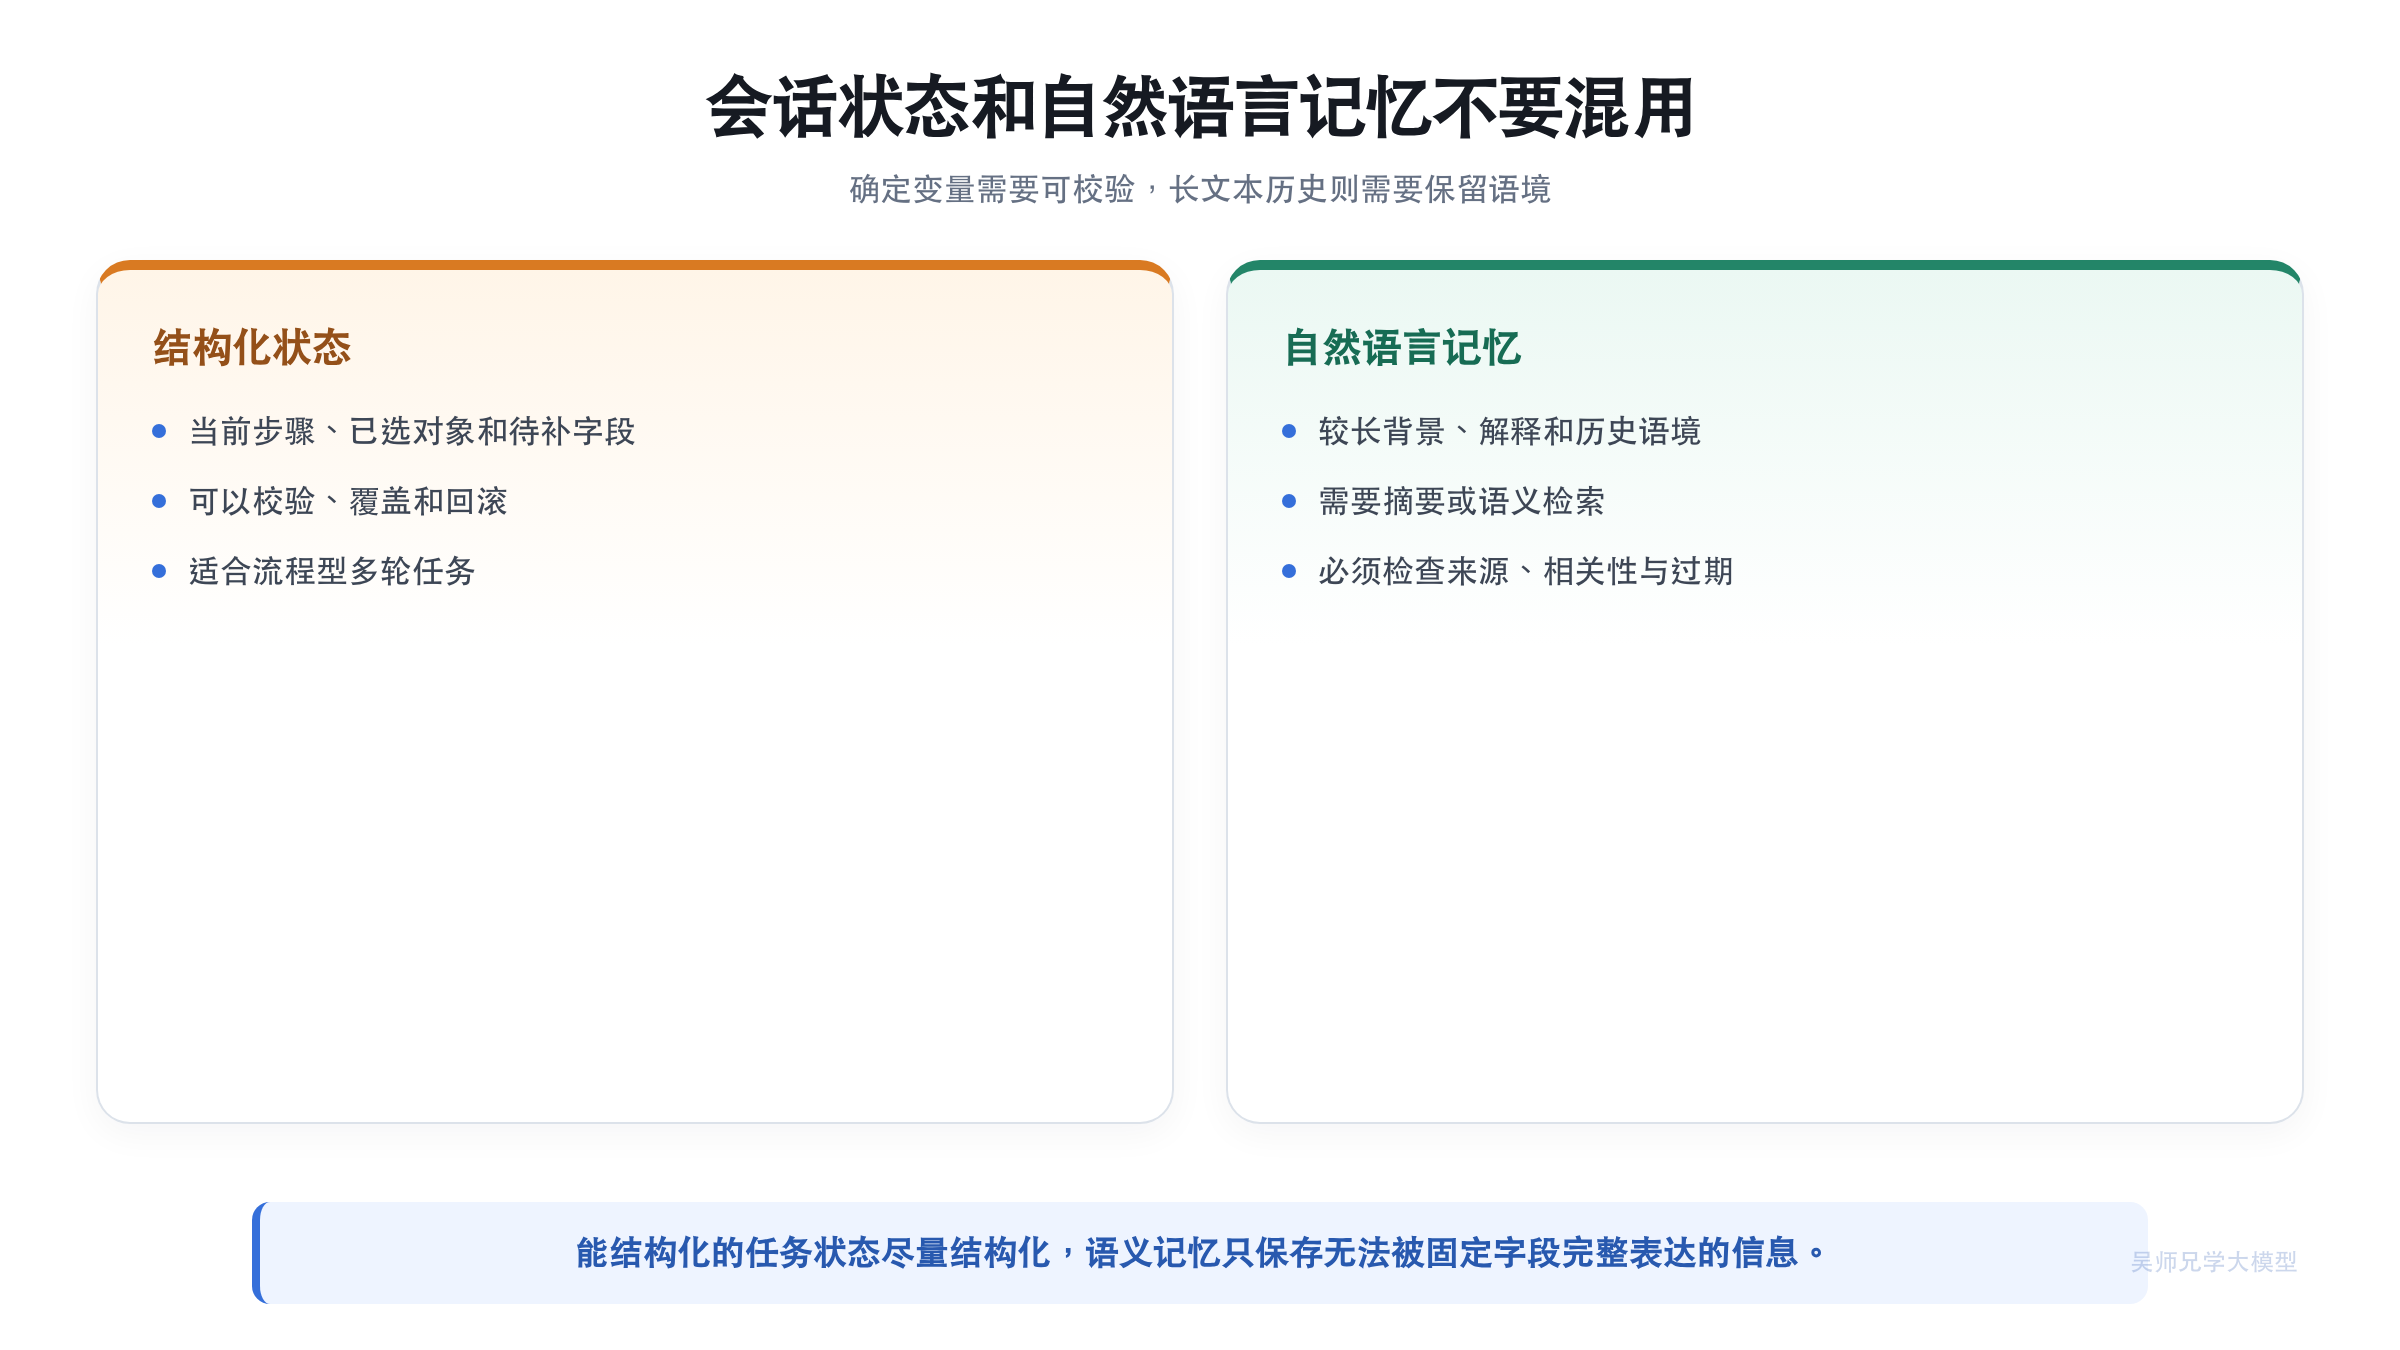
这里还要把知识库事实单独拿出来。企业制度、产品手册、合同条款属于可验证的静态知识,应由知识检索链路提供;“用户正在办理哪一步”“用户已经确认哪个选项”属于会话状态;“用户明确同意长期保存的语言偏好”才可能进入长期记忆。静态知识更新后,不能让一条旧对话记忆继续覆盖新制度。
三层记忆分别解决什么问题
短期窗口:保证当前任务连贯
短期窗口保存最近的原始消息、当前任务状态和临近上下文,适合按会话 ID 读取。它的优点是信息原始、更新快,模型可以看到用户刚刚确认的对象和条件;缺点是容量有限,窗口外的信息会自然消失。
窗口大小不应只用“几轮”定义。一次回复可能只有几十字,也可能包含长表格或大量引用。更稳妥的做法是同时受消息数、Token 预算和消息重要度约束:优先保留最近用户输入、尚未完成的任务状态和会影响当前回答的确认项,再删除无关寒暄或可从知识库重新获取的内容。
短期数据通常需要 TTL,也就是到期自动失效。在实际设计中,TTL 不能照搬一个固定数字,要根据产品是否需要恢复会话、用户是否登录、数据敏感性和合规要求决定。用户点击“新对话”时,系统也要明确这是只重置当前上下文,还是连持久化记忆一起删除,不能让界面上的“清空”与后台实际行为不一致。
继续追问 · 4 个问题
- 摘要把关键数字压错了,系统怎样发现?
- 向量记忆为什么会召回语义相近但语境错误的旧对话?
- 短期记忆和长期记忆分别存在哪里?
- 用户要求删除记忆时,索引和持久库怎样同步?
回答前,逐项自查
- 画出短期、摘要和长期记忆数据流
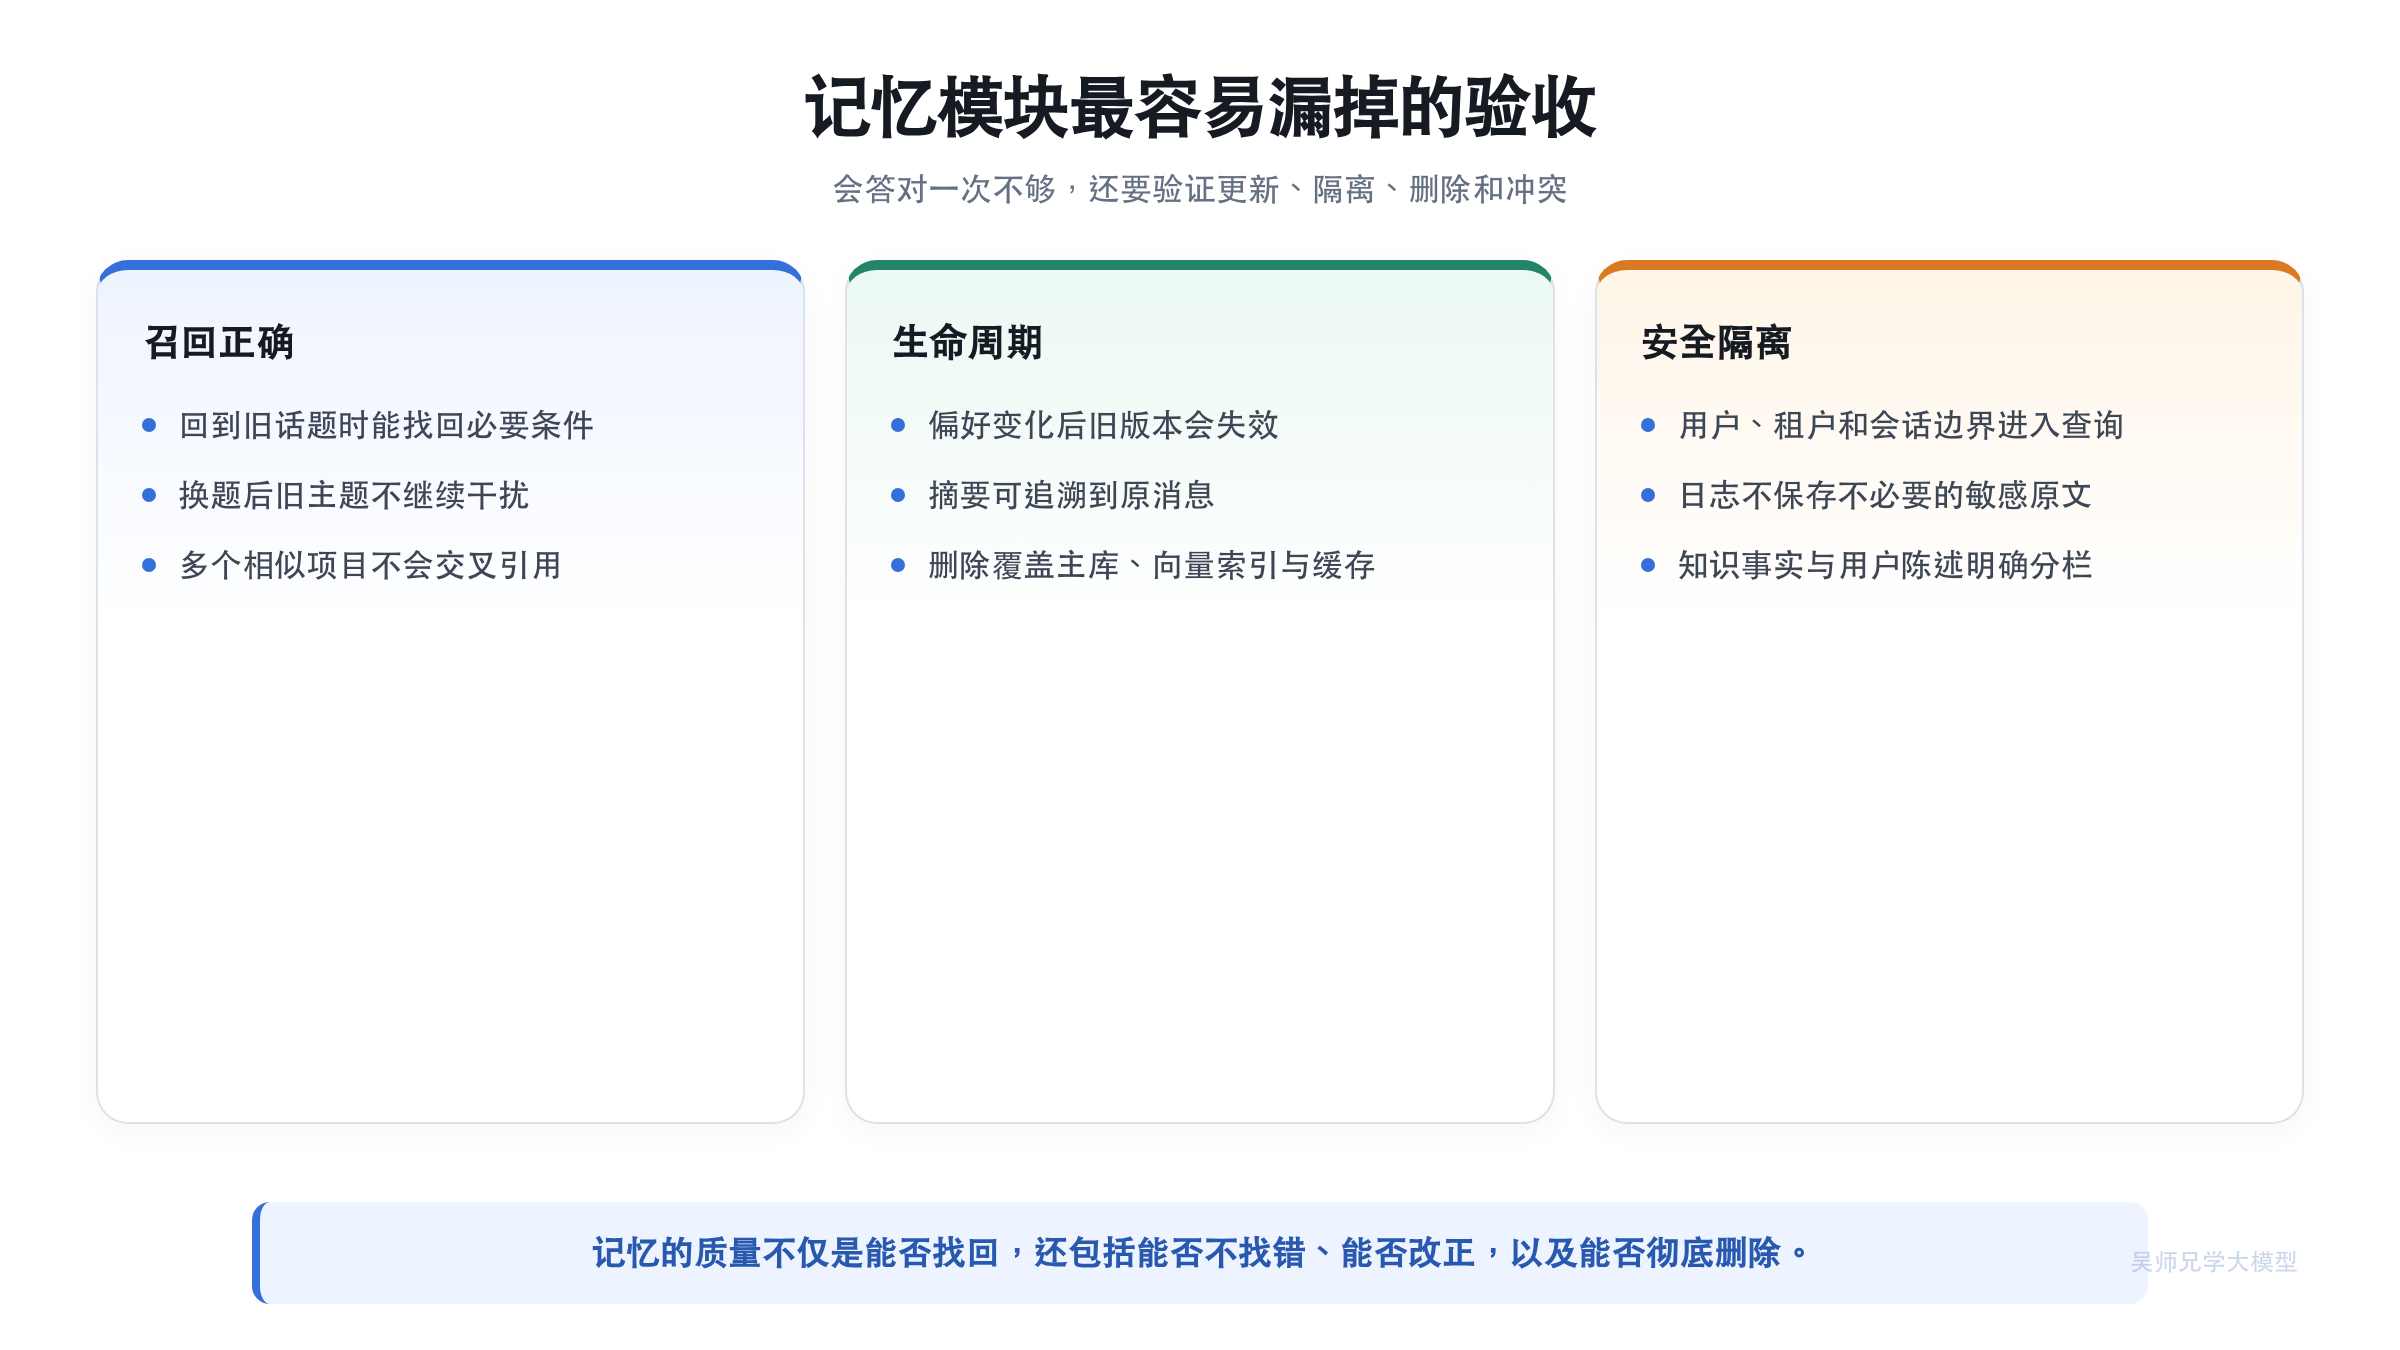
- 定义 TTL、用户隔离与删除机制
- 准备长对话回到旧话题的样本
- 检查摘要与原对话的一致性