本文目录
先用 30 秒讲清楚
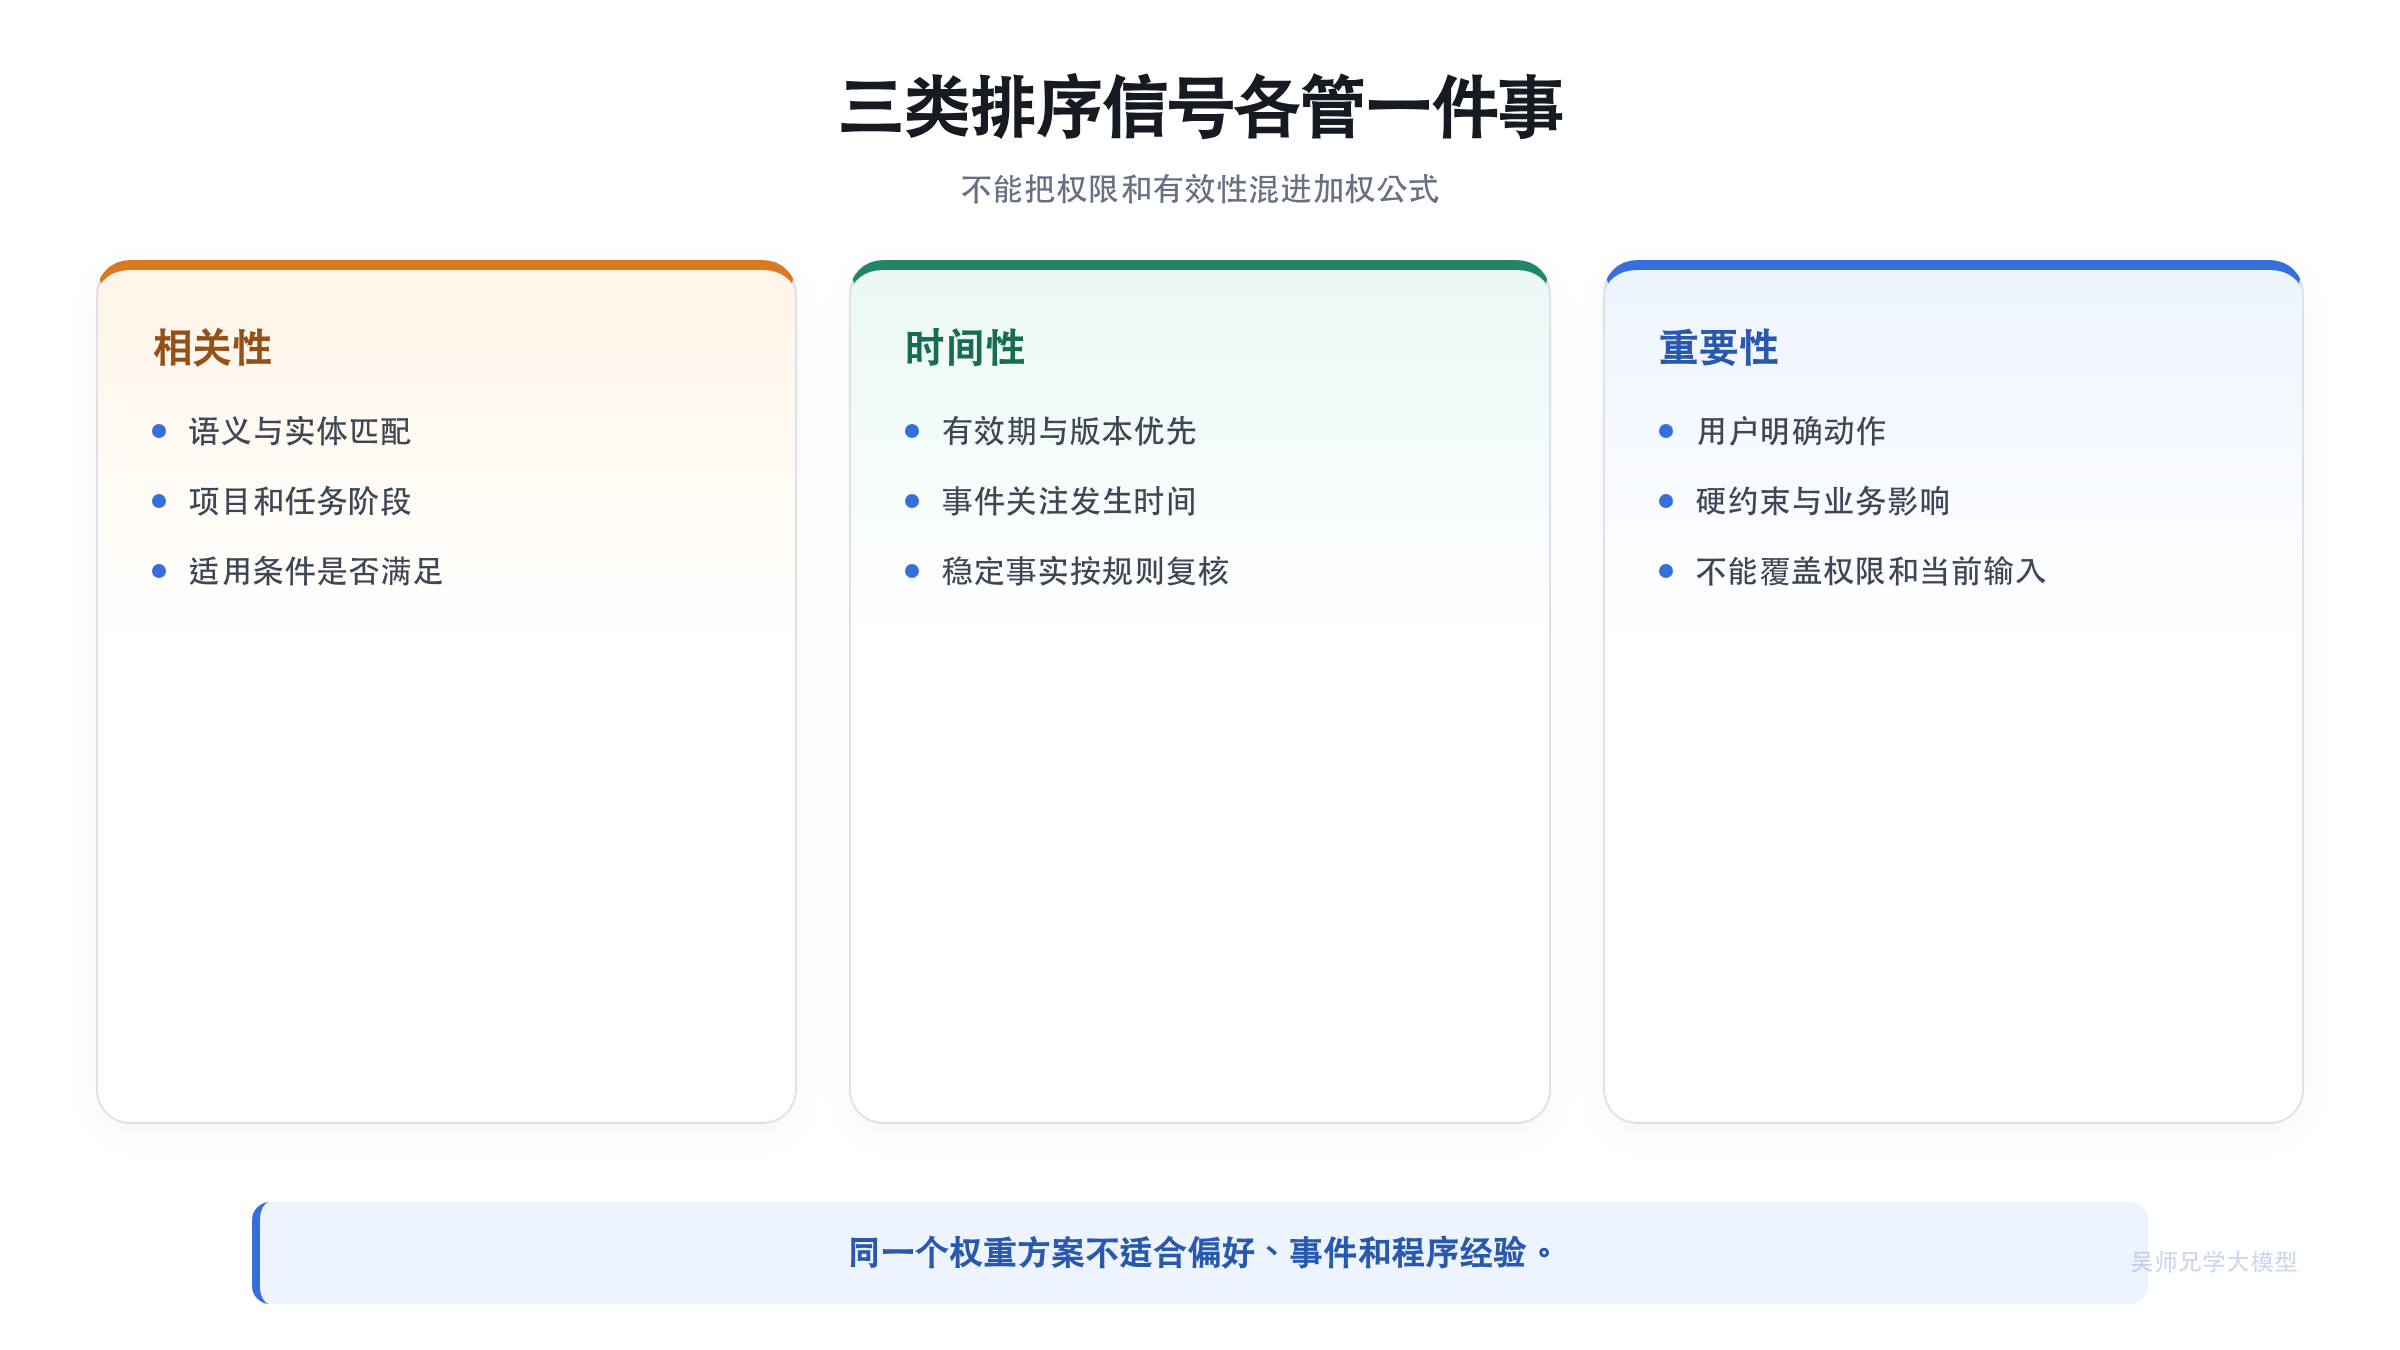
Agent 记忆检索先按用户、租户、项目、类型、有效状态、权限和时间做硬过滤,再结合结构化查询、关键词和向量生成候选,最后用语义相关性、作用域、时间性、重要性、来源与条件匹配重排。冲突不能静默取最高分,过期和无权记录不得入选,也必须允许无记忆结果。
面试官可能会问:“长期记忆已经存了很多条,为什么不能直接向量检索 TopK?”
因为“语义相似”只回答文本像不像,不回答这条记忆属于谁、当前 Agent 有没有权限、信息是否还有效、来源是否可信、是不是被新版本替代,以及它对当前任务到底有多重要。
用户今天问“帮我继续上次的 RAG 评测”,向量库可能召回一个月前的项目目标,也可能召回另一个项目里措辞相似的评测记录。旧目标语义很像,但当前阶段已经变化;另一个项目更像,却属于错误作用域。若系统只取相似度最高的几条,记忆越多,污染当前决策的机会反而越大。
这道题要回答的是一条检索与排序链路:先识别查询意图和主体,做权限、租户、类型、状态、时间与项目范围过滤,再生成语义候选,结合相关性、时间性、重要性、来源和条件匹配重排,最后去重、处理冲突、控制注入预算,并允许“没有任何记忆值得使用”。
先给出 30 秒回答
Agent 记忆检索不能只做向量 TopK。我会先根据当前任务构造检索意图,并用用户、租户、项目、记忆类型、有效状态、权限和时间范围做硬过滤;再对剩余候选计算语义相关性,并结合时间性、业务重要性、来源可信度、条件匹配和使用反馈做重排。不同类型的记忆使用不同权重和时效规则,当前用户明确输入与实时工具事实始终高于历史记忆。冲突条目不能静默选一条,而要成组裁决或请求确认;过期、被替代和无权限条目不得进入排序。最后限制条数和 Token,保留来源与时间注入上下文,并用正例、难负例、冲突和不应召回样本评估。
这段话的关键不是给出一个万能公式,而是把硬约束与软排序分开。
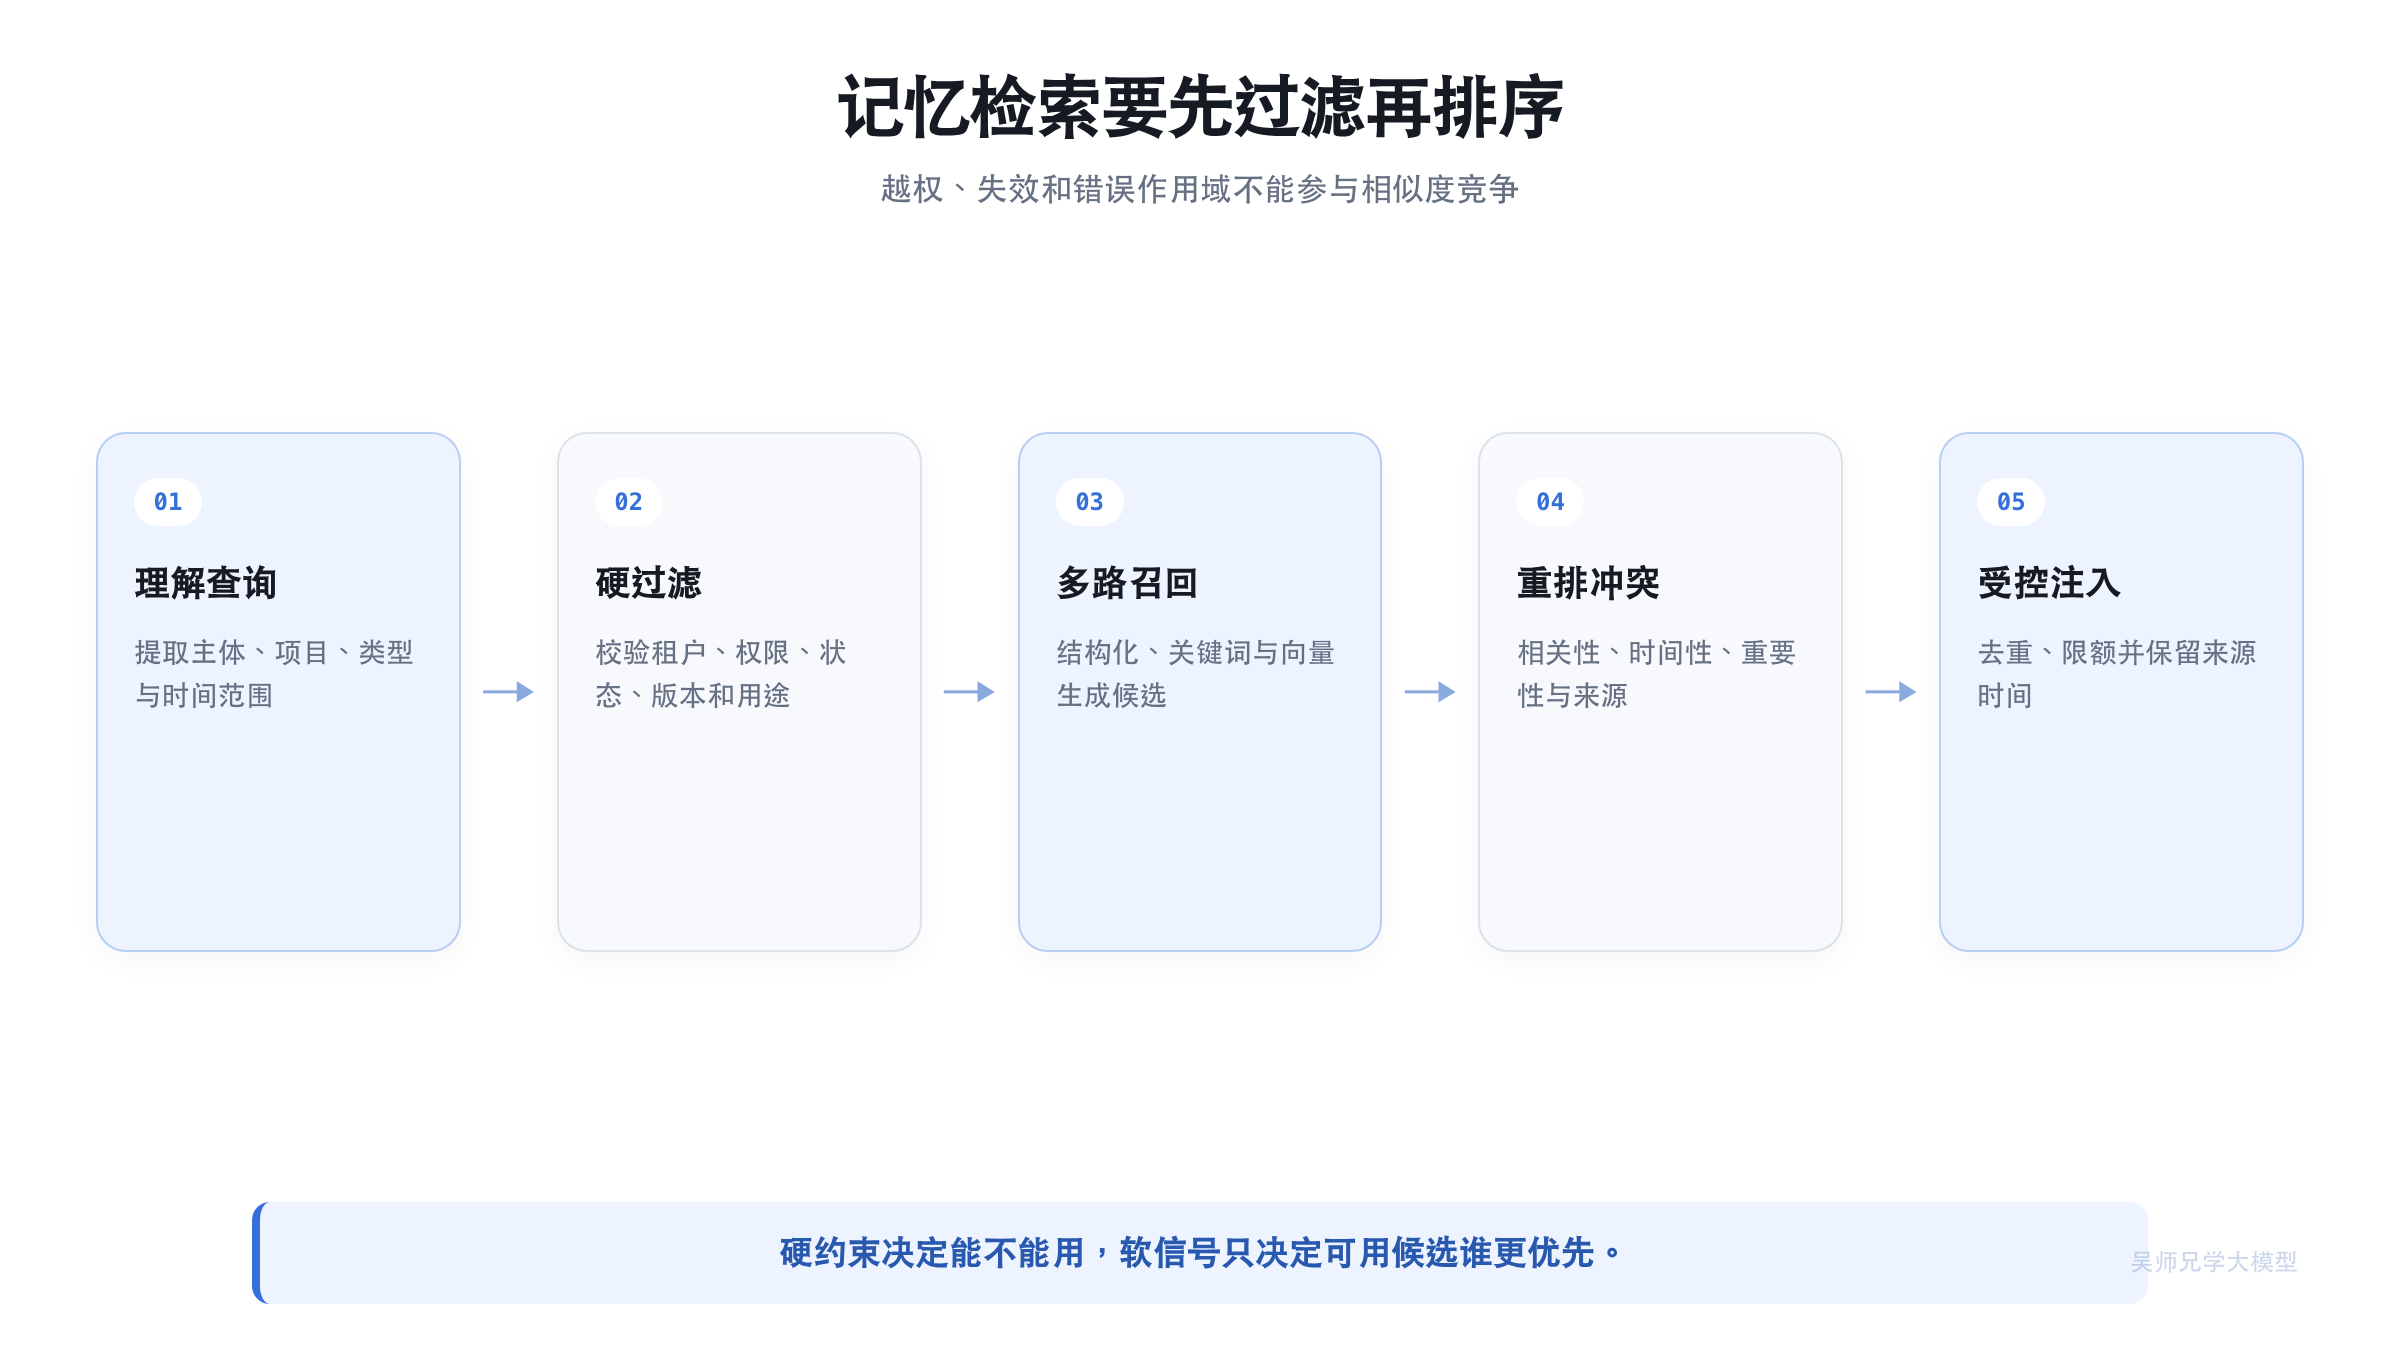
先排除不能用的记忆,再在可用候选里判断哪条更值得进入上下文。
第一步:先理解当前任务要找什么
用户输入不一定能直接作为向量查询。
“继续做昨天那个方案”包含指代,需要先从当前会话确定“那个方案”可能对应的项目和任务阶段。“还是按以前的风格写”需要检索表达偏好,而不是搜索所有历史文章。“上次为什么失败”更需要事件与失败记录,不是用户画像。
检索器可以从当前 State 提取几个结构化字段:主体是谁、任务或项目是什么、需要的记忆类型、时间范围、实体与关键词、当前目标、必须遵守的权限和预算。模型可以帮助解析自然语言,但主体、租户、权限和项目标识应来自可信上下文,不能由模型猜。
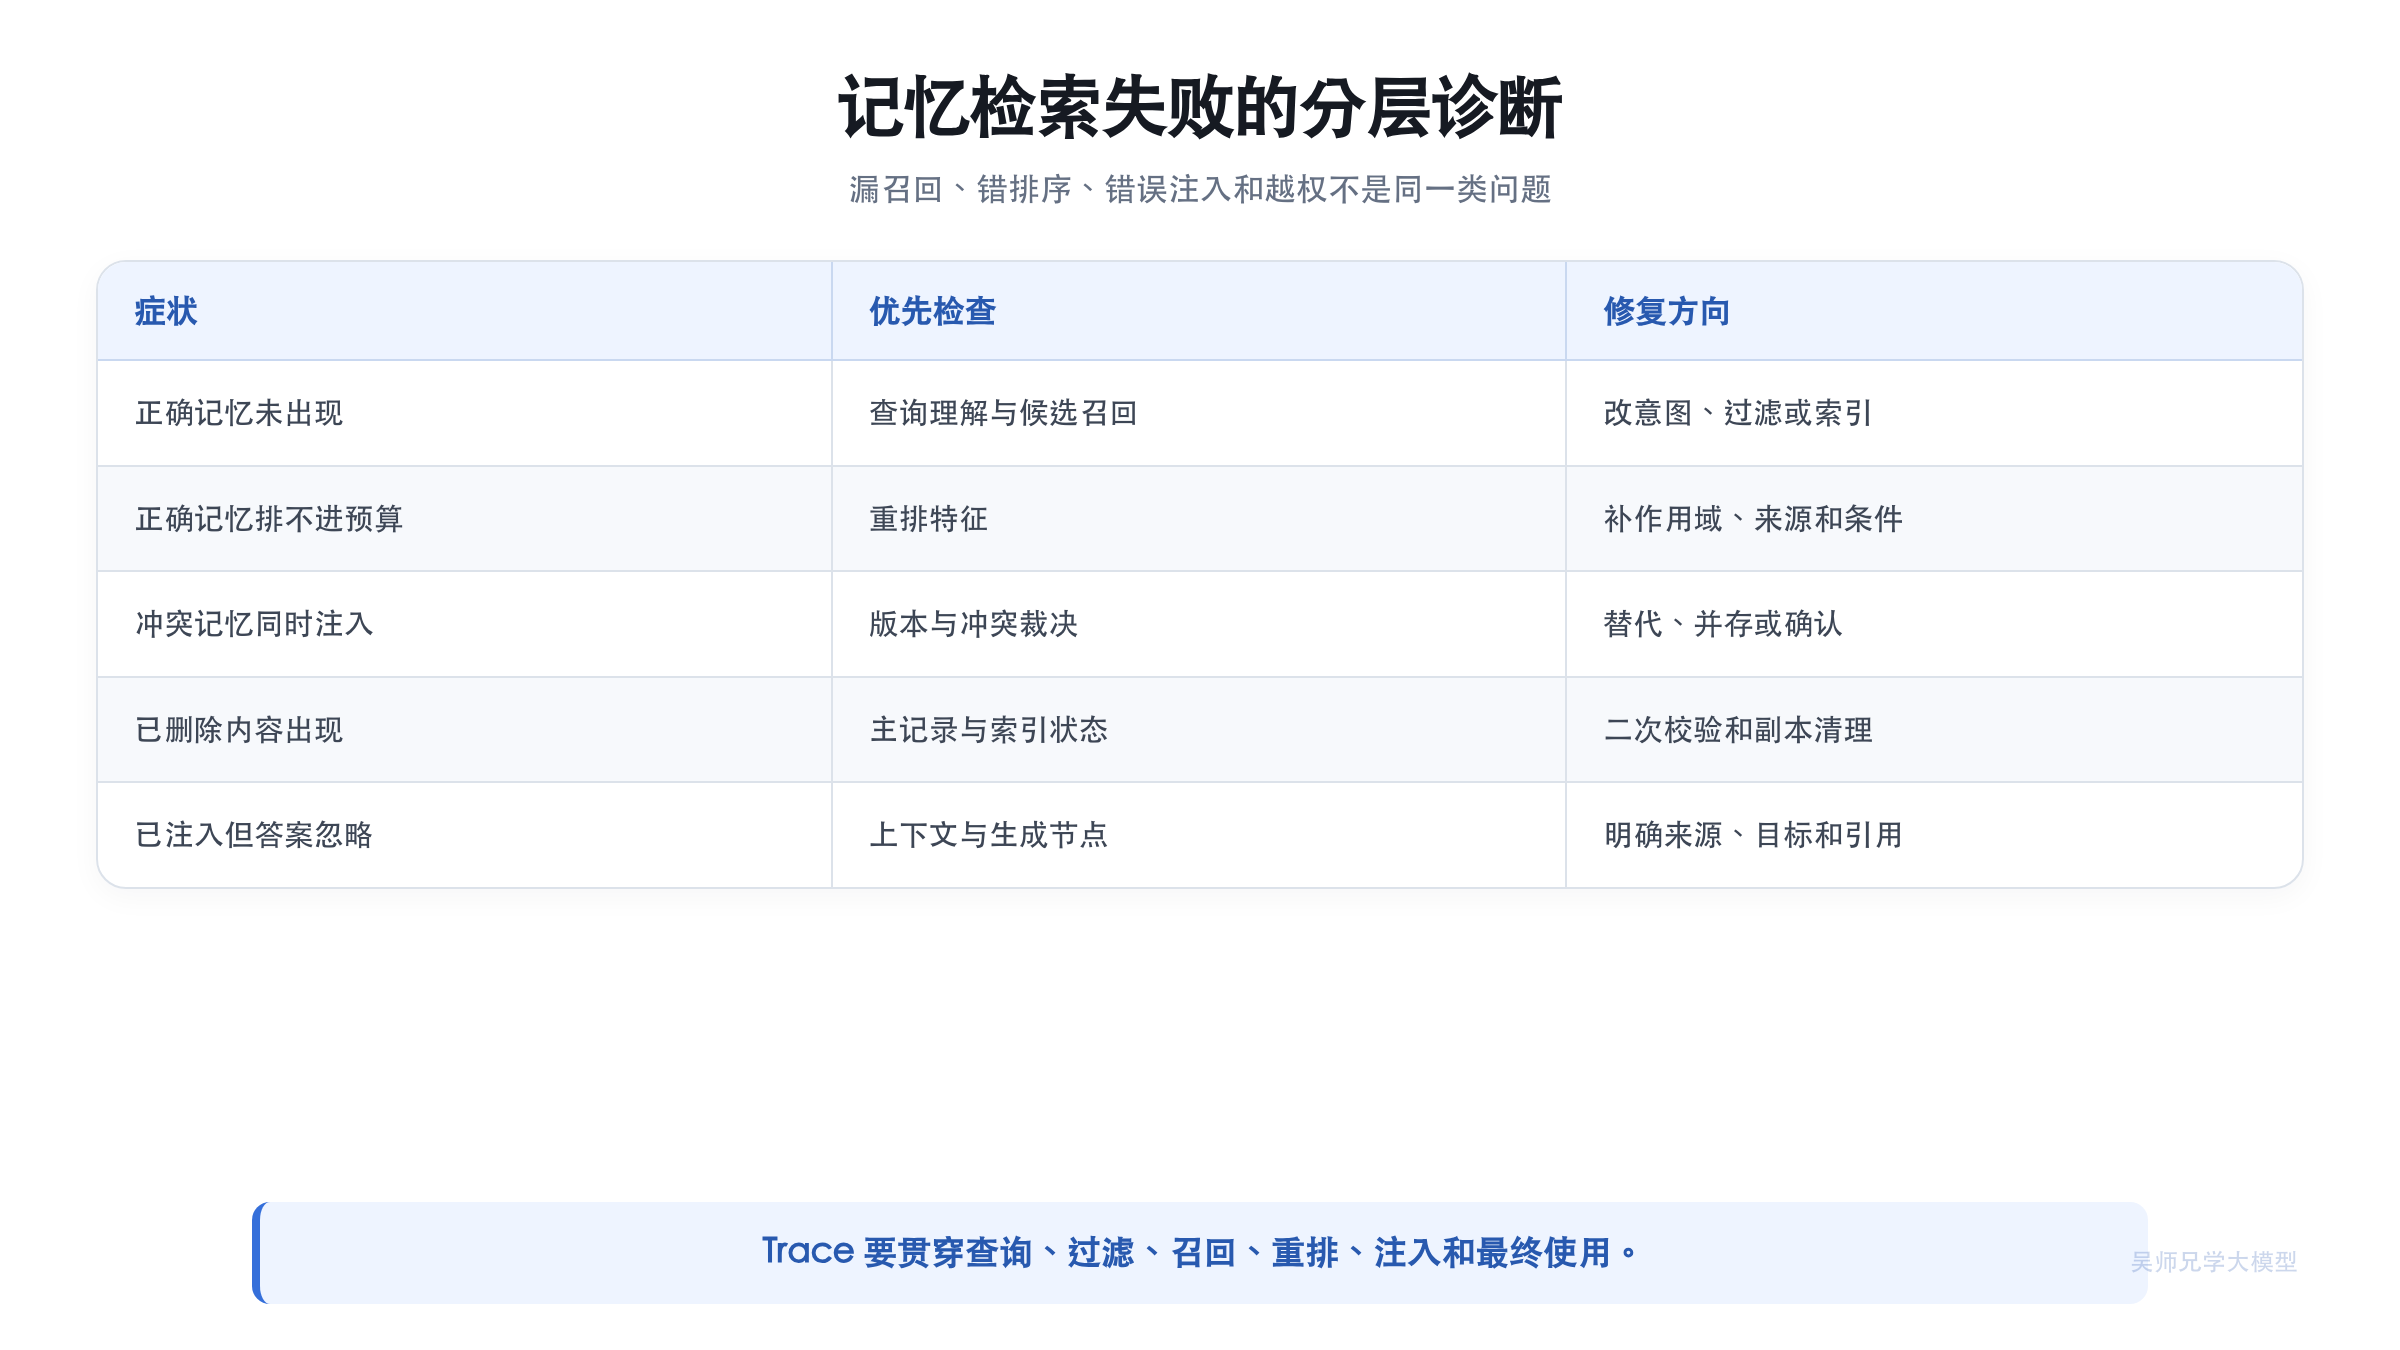
查询改写也要保留原始问题。若改写错误,Trace 需要看见模型怎样把“昨天的方案”解析成某个项目。只有记录查询意图、过滤条件和候选变化,才能判断漏召回发生在理解、过滤、向量召回还是重排。
一个任务可能需要多路检索。用户偏好走结构化属性查询,历史任务摘要走语义检索,最近事件走时间范围查询,实体关系走精确键或图关系。不要强迫所有记忆都经过同一条向量查询。
继续追问 · 4 个问题
- 相关性、时间性和重要性的权重怎么确定?
- 为什么权限和有效状态不能只作为排序负分?
- 新旧记忆冲突时怎样决定使用哪一条?
- 怎样区分检索失败、重排失败和模型没有使用记忆?
回答前,逐项自查
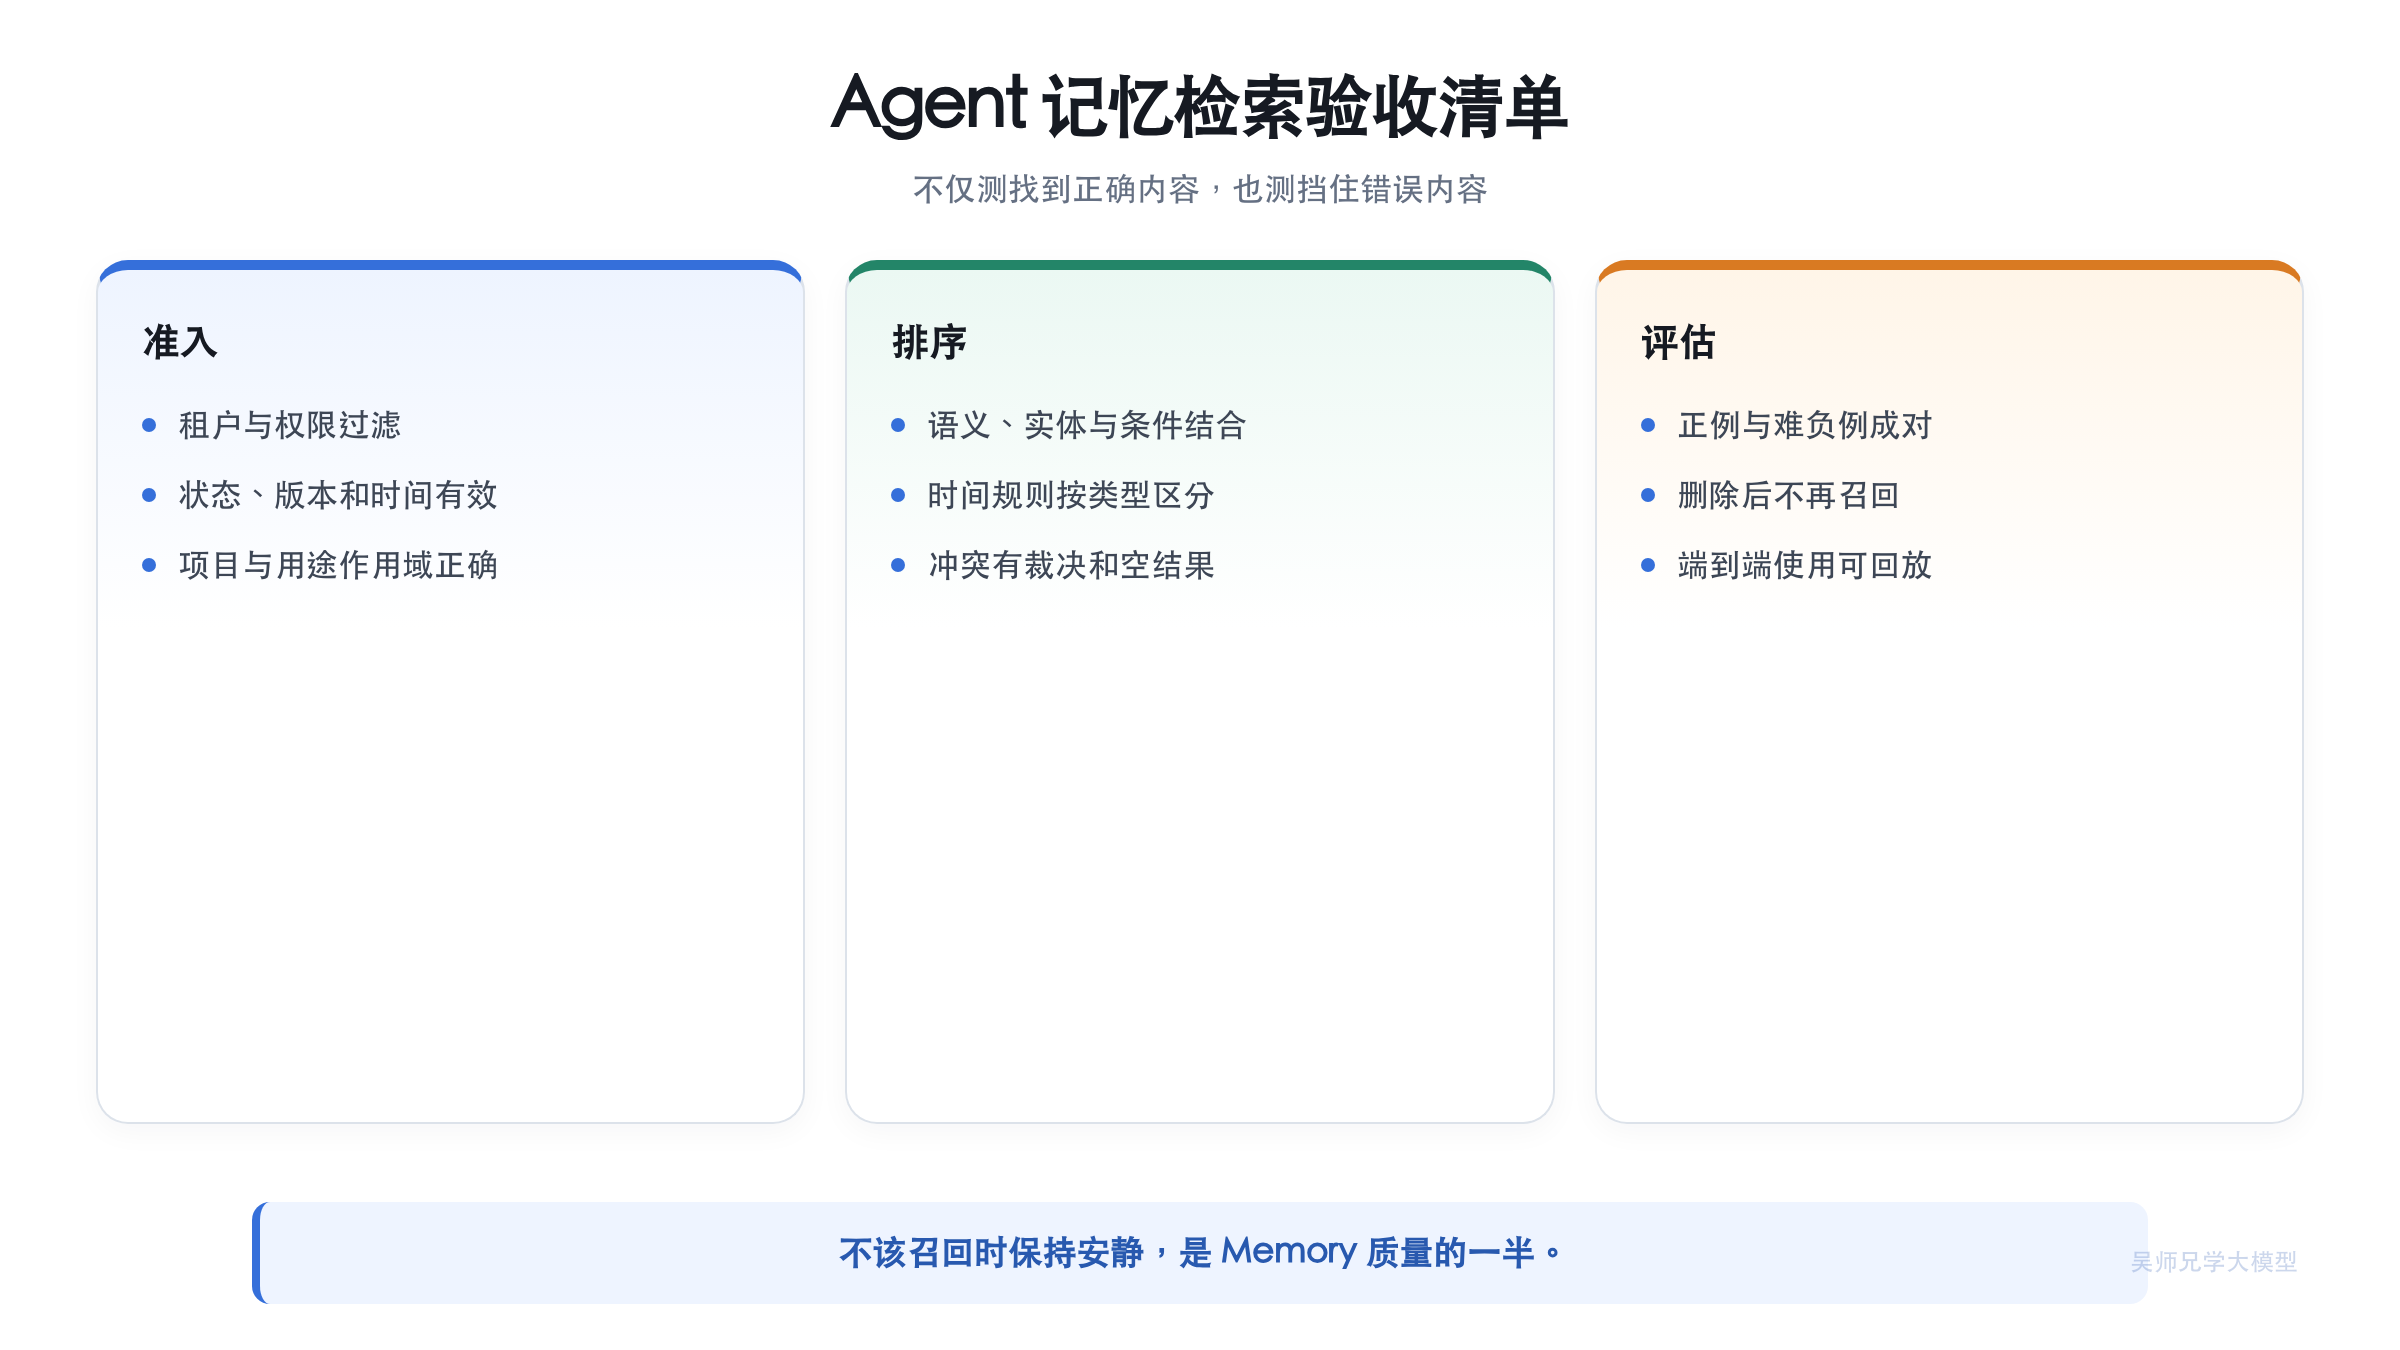
- 先做租户、权限、状态、版本和作用域硬过滤
- 组合语义、实体、时间、重要性、来源与条件信号
- 支持冲突裁决、空结果和受控上下文注入
- 覆盖难负例、删除后不可召回与分层 Trace